AI 新闻更新
GPT-6.1 Terra API 价格:每 100 万 token $1 输入,$5 输出
OpenAI 新的 GPT-6.1 Terra 价格对一个 20 步智能体任务意味着什么,并与旧的 GPT-5.6 Terra 价格和更便宜的模型进行对比。
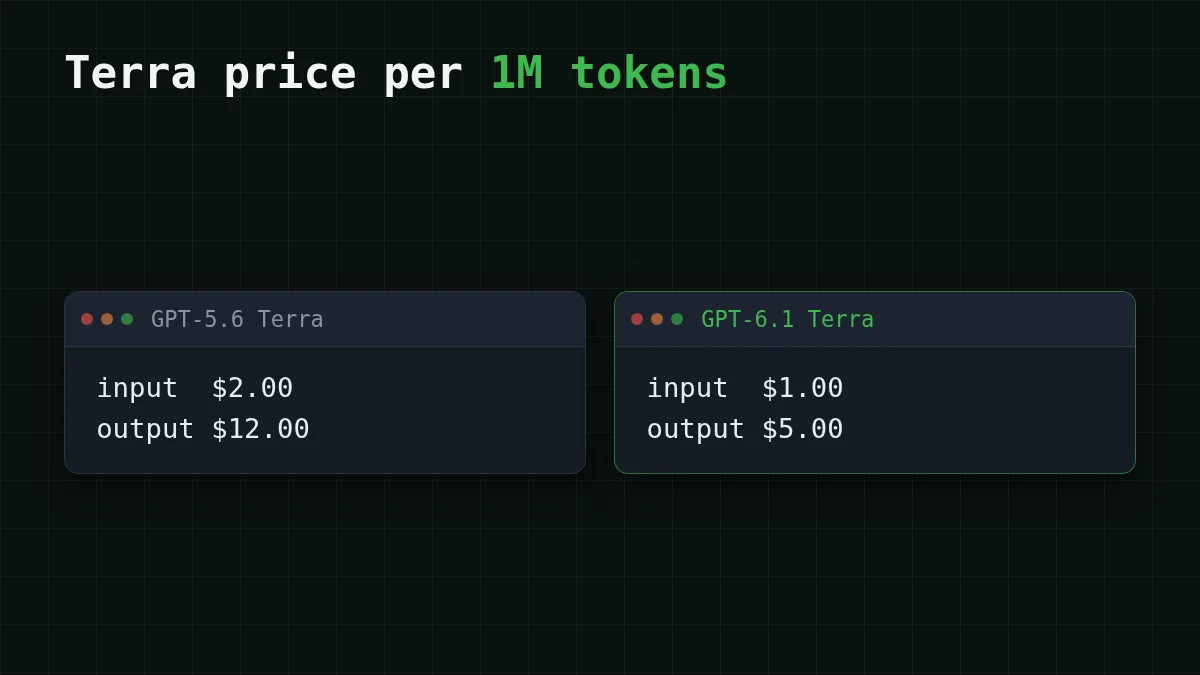
GPT-6.1 Terra 在 OpenAI 的 API 定价页面上标价为 每 100 万输入 token $1.00,每 100 万输出 token $5.00(2026 年 10 月 27 日查询)。上一代 Terra,即 GPT-5.6 Terra,在同一页面上标价为 $2.00 和 $12.00。如果你的编码智能体运行在 GPT-5.6 Terra 上,把它换成 GPT-6.1 Terra,完成同样任务的账单大约减半。下面说明:对于一个典型的智能体任务能省多少,以及更便宜的模型在哪里能让你走得更远。
价格页面上有什么变化#
GPT-6.1 Terra 列在 OpenAI 的定价页面上(2026 年 10 月 27 日查询),API id 为 gpt-6.1-terra。输入价格降到旧价的一半。输出价格从 $12.00 降到 $5.00。第二个数字比看起来更重要:智能体写得很多,而输出是贵的那一侧。
不过,页面上不止一行,选错行是最容易让你被账单吓到的方式:
配对
把价格页面上的每一档与其费率对应起来
点击左侧项目,然后点击其配对项
- 标准档,输入不超过 272K token每 100 万 $1.00 输入,$5.00 输出
- 输入超过 272K token每 100 万 $2.00 输入,$7.50 输出
- Batch / Flex每 100 万 $0.50 输入,$2.50 输出
- Fast每 100 万 $2.00 输入,$10.00 输出
缓存输入在标准档上单独标价为每 100 万 $0.05,当智能体的每一步都重新发送同一段长前缀时,这会有帮助。本文其余部分使用标准档且不使用缓存,因此这些数字很容易重新计算。
一个 20 步的智能体任务要花多少钱#
假设你的智能体用 20 步解决一个工单。每一步发送任务、它已打开的文件以及到目前为止的工具结果,平均约 30,000 个输入 token,并写回约 1,500 个 token(一个计划、一个补丁、一条命令)。这是一个看起来很普通的假设,而正是它让智能体变得昂贵:输入在每一步都会被重新发送。(如果这部分对你是新内容,为什么 AI 智能体会使用这么多 token 有详细说明。)
那么一个任务累计为 20 × 30,000 = 600,000 个输入 token 和 20 × 1,500 = 30,000 个输出 token。每一步都远低于 272K 这条线,因此适用标准费率。
- GPT-6.1 Terra:输入 0.6 × $1.00 = $0.60,输出 0.03 × $5.00 = $0.15,每个任务 $0.60 + $0.15 = $0.75。
- GPT-5.6 Terra:输入 0.6 × $2.00 = $1.20,输出 0.03 × $12.00 = $0.36,每个任务 $1.20 + $0.36 = $1.56。
现在把它放大。一个每天完成 100 个此类任务的团队,在新模型上每天支付 100 × $0.75 = $75,而在旧模型上是 100 × $1.56 = $156。这是实实在在的削减,而且除了模型 id 之外,你的代码无需任何改动。
同样的任务在我们提供的模型上,按实时价格计算(一步是 30,000 输入和 1,500 输出,乘以 20 步):
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 20 次请求 | OpenRouter,20 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
每次请求 30,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
对于一整个任务,DeepSeek-V4-Flash 为 $0.012,GLM-5.3-Flash 为 $0.0132,MiniMax-M2.7 为 $0.0345。表中还显示了它们各自在 OpenRouter 上的价格,而把输入和输出加在一起算总量,CheapTokens 是更便宜的一方。
在迁移整条流水线之前,先把你自己的几个工单发给候选模型,并把 usage 块中的 token 计数与上表进行比较。
哪个模型适合哪种工作#
如果这次降价把你吸引到了 Terra,先问问你的循环实际需要什么。长历史、长回答、紧张的预算:这是三种不同的工作,而我们为每一种都准备了模型。
选择你的情况
选择与你最接近的工作
选择一个选项以查看答案
长时间的编码智能体循环
选择 DeepSeek-V4-Flash。它有 380K 上下文,每次回答最多写 32,768 个输出 token,而且一天中任何时段价格都相同。这适合读取许多文件然后写出大补丁的智能体。
日常编码和聊天
选择 GLM-5.3-Flash。它有 390K 上下文,最多回答 8,192 个 token,而且在相同 token 总量下比 OpenRouter 更便宜。
预算紧张的智能体工作
选择 MiniMax-M2.7。它有 180K 上下文,最多回答 8,192 个 token,而且在相同 token 总量下比 OpenRouter 更便宜。
这三个模型都通过同一个余额使用,并且同时支持 OpenAI 和 Anthropic API,因此在它们之间切换只需改一行模型 id。
在你自己的任务上试一试#
把你的一条真实提示发给更便宜的模型,并读取回答中的 usage 块。它会告诉你确切的输入和输出 token 数,你可以将其与上面假设的每步 30,000 输入 / 1,500 输出进行比较。示例请求(地址和模型 id 是要复制的部分;把你的密钥放在环境变量中):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
完整设置见 CheapTokens 文档,实时价格列表在定价页面上,而如何估算 AI 智能体的成本展示了如何把你自己的日志转换成本文开头的那两个数字。


