AI 新闻更新
Mistral Large 4 开放权重:API 价格与每个智能体任务的成本
Mistral Large 4 现已开放权重,并提供 Mistral 的 API 定价。了解一个编码智能体任务的成本,以及更便宜的模型何时适用。
Mistral Large 4 现已开放权重:Mistral 于 2026 年 10 月 29 日发布了权重,并将 API 价格定为每 100 万输入 token 0.70 美元、每 100 万输出 token 2.10 美元(缓存输入为 0.07 美元)。如果你运行编码智能体,真正有用的问题不是每 token 的价格,而是一个长任务总共要花多少。
Mistral 公布了什么#
根据 Mistral 的发布页面(2026 年 10 月 30 日查看),Mistral Large 4 是一个约 1T 参数的模型,是 instruct 与 reasoning 的混合体,以专家混合架构构建。它在输入上原生支持多模态,覆盖 160 多种语言,并有三种推理模式:Low、Medium 和 High,其中 High 为默认。Hugging Face 仓库是 Mistral-;API id 是 mistral-。
权重以 Mistral Ecosystem Open-Weight 许可证发布,这是修改版 MIT。允许商业使用和微调。将模型作为托管服务出售需要获得 Mistral 的单独商业许可证。你可以用 vLLM 或 SGLang 运行它,通过 NVIDIA NIM 或 TensorRT-LLM,或使用 Mistral 自己的 API、Microsoft Foundry 和 Mistral Vibe Code。
在基准测试上,Mistral 报告的是自己的数字:Terminal-Bench 4.0 上 41%(预览版为 28%),FrontierCode 2.0 上 19.7%,BrowseComp 上 84.5%,Artificial Analysis Coding Agent Index 上 48%,Mistral 称这与 GLM-5.3 持平,且每个任务少用 47% 的 token。这些是厂商的结果,不是独立结果,所以应将其视为在你自己的仓库上测试的理由,而不是定论。
按 Mistral 的价格,一个智能体任务要花多少#
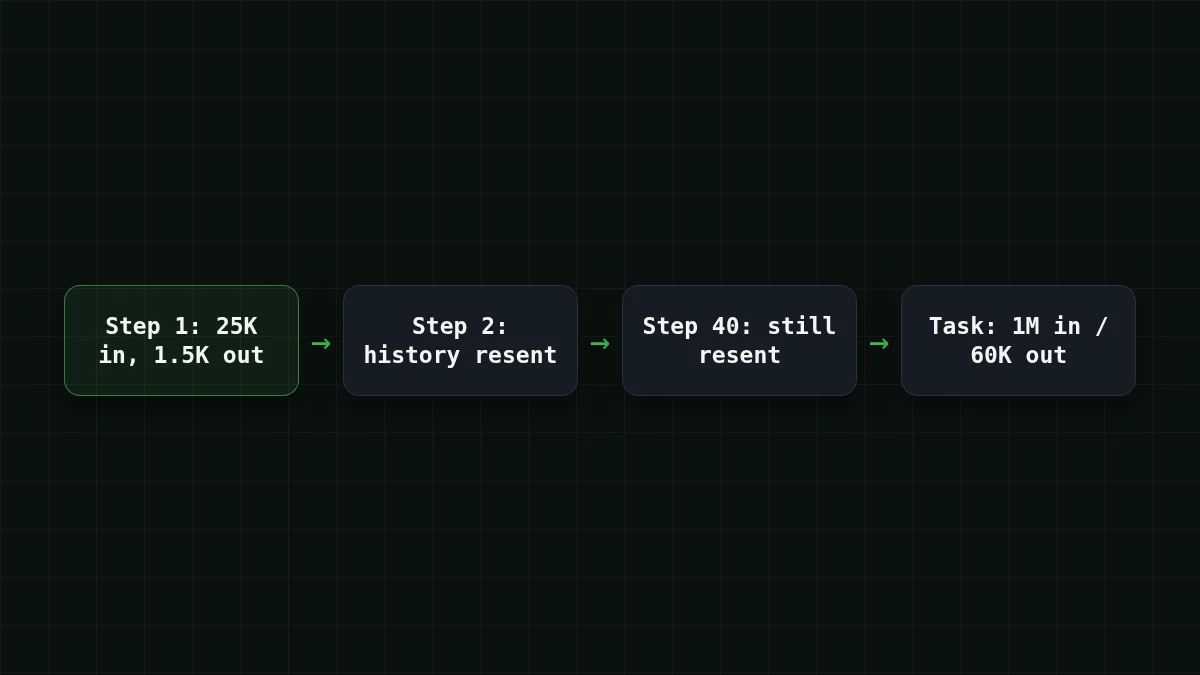
先从智能体实际如何消耗 token 开始。每一步都会重新发送到目前为止的对话,所以输入不断累积,而每个回答保持简短。假设一个终端编码智能体在一个任务上执行 40 步,每步约 25,000 输入 token 和 1,500 输出 token。这是用于说明的假设;换成你自己的数字。
猜数字
40 步,每步约 25,000 输入 token:该任务总共发送多少千输入 token?
你的猜测
02,000
显示答案
答案: 1,000
25,000 × 40 = 1,000,000 输入 token,即 1,000 千。智能体在每一步都重新发送其上下文,这就是输入量主导智能体账单的原因。
按 Mistral 公布的价格(2026 年 10 月 30 日),该任务的输入为 1,000,000 × $0.70 / 1M = $0.70,输出为 60,000 × $2.10 / 1M = $0.126,所以每个任务为 $0.70 + $0.126 = $0.826。输入侧占账单的大部分。
缓存会改变情况。如果每一步 25,000 输入 token 中有 20,000 个以每 1M 0.07 美元的价格从缓存提供,则一步的缓存输入成本为 20,000 × $0.07 / 1M = $0.0014,新输入为 5,000 × $0.70 / 1M = $0.0035,输出为 1,500 × $2.10 / 1M = $0.00315。即每步 $0.00805,每个任务 $0.00805 × 40 = $0.322。80% 的缓存命中率是另一个假设,所以请检查你的工具报告的结果。
以下是在可移动的计算器上运行的相同工作负载:
成本计算器
一个编码智能体任务:40 步
每次请求的输入 token 数: 25,000 · 每次请求的输出 token 数: 1,500 · 每日请求数: 40
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
以及相同任务在 CheapTokens 模型上的实时定价,与 OpenRouter 并列:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 40 次请求 | OpenRouter,40 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
每次请求 25,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
对于这个智能体循环,CheapTokens 上的 DeepSeek-V4-Flash 整个任务为 $0.021,输入和输出合计,且总计比 OpenRouter 的参考价格更便宜。它有 380K 上下文窗口,每个回答最多 32,768 输出 token,全天任意时段一个价格。
开放权重还是 API#
权重是本次发布中有趣的部分。如果你的数据不能离开你的网络,或者你想微调,你现在可以用这个级别的模型做到。这条路线成本是硬件。一个 1T 参数的模型需要多 GPU 服务器,即使每个 token 只有一部分活跃,而且 Mistral 的页面没有说明活跃参数数量(仓库名中的 A52B 暗示 52B,但这是从名称推断的)。Mistral 的页面也没有说明上下文大小。
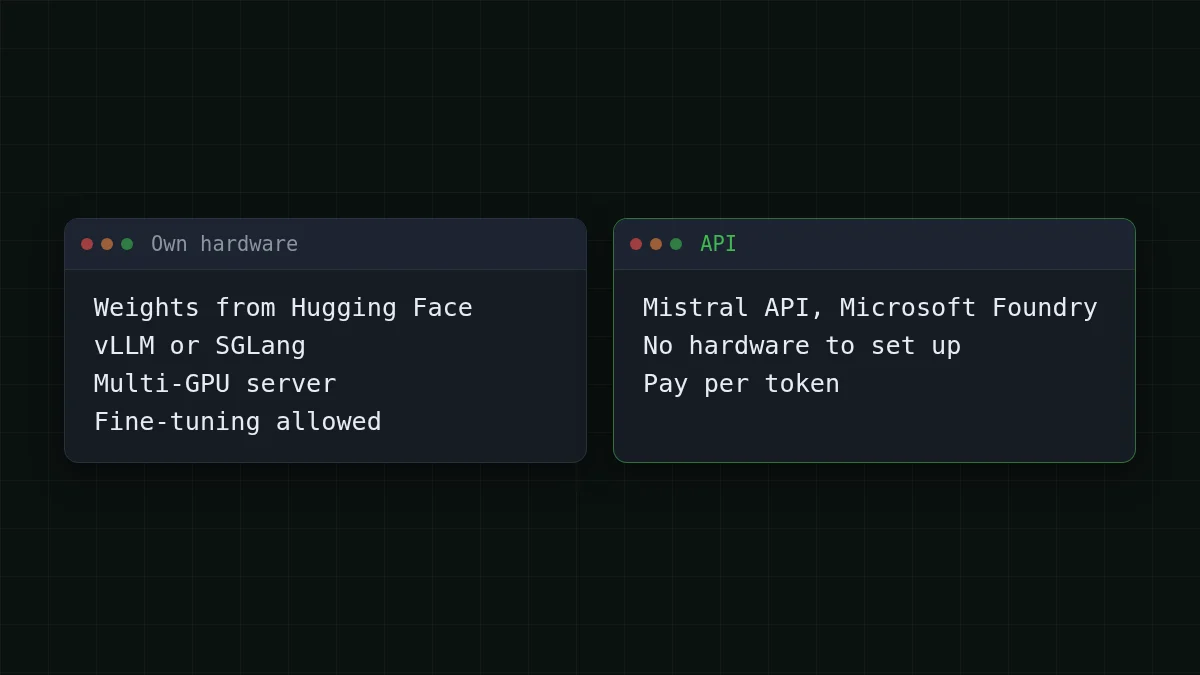
对于大多数只想让智能体完成工单的团队,API 路线避免了这种设置。如果你想了解开放权重在实践中意味着什么背景,请参阅什么是开放权重和量化。
在你今天就能调用的智能体模型上执行相同任务#
如果你的目标是让终端或 IDE 智能体以低成本运行许多步骤,你可以通过 CheapTokens 在 DeepSeek-V4-Flash 或 GLM-5.3-Flash 上尝试相同的循环。API 兼容 OpenAI Chat Completions 和 Anthropic Messages,所有模型共用一个余额。使用 CheapTokens 文档中的完整模型 id;模型名称因提供商而异。
一个请求,两个客户端
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
响应中的 usage 字段显示输入和输出 token,因此你可以测量自己智能体的步骤并代入上面的计算器。我们的 Cline 成本指南 展示了如何为整个会话做预算,文档 涵盖了连接其他工具。模型页面:便宜的 DeepSeek,以及实时定价。
哪个模型适合哪项工作#
在你自己的硬件上使用开放权重以及微调是另一条路径,而这正是本次发布所开启的。对于由短步骤组成的长循环,使用 CheapTokens 上的 DeepSeek-V4-Flash:380K 上下文,每个回答最多 32,768 输出 token,全天任意时段一个价格,且总计比 OpenRouter 更便宜,输入和输出合计。GLM-5.3-Flash 有 390K 上下文。Mistral 的基准测试与 GLM-5.3 比较,但没有说明是哪个 GLM-5.3 变体,所以不要将其数字套用到 GLM-5.3-Flash 上。在各自上运行十个你自己的任务并比较 token 计数;相同方法见GPT-6.1 Terra 的价格如何按任务计算。


