KI-NewsUpdate
Mistral Large 4 Open Weights: API-Preis und Kosten pro Agent-Aufgabe
Mistral Large 4 ist jetzt Open-Weight, mit API-Preisen von Mistral. Sieh, was eine Coding-Agent-Aufgabe kostet und wann ein günstigeres Modell passt.
Auf dieser Seite
Mistral Large 4 ist jetzt Open-Weight: Mistral hat die Gewichte am 29. Oktober 2026 veröffentlicht und den API-Preis auf $0.70 pro 1M Input-Tokens und $2.10 pro 1M Output-Tokens festgelegt ($0.07 für gecachten Input). Wenn du Coding-Agents betreibst, ist die nützliche Frage nicht der Preis pro Token, sondern was eine lange Aufgabe in Summe kostet.
Was Mistral angekündigt hat#
Laut Mistrals Release-Seite (geprüft am 30. Oktober 2026) ist Mistral Large 4 ein Modell mit etwa 1T Parametern, eine Hybrid aus Instruct und Reasoning, gebaut als Mixture of Experts. Es ist nativ multimodal auf der Eingabe, deckt 160+ Sprachen ab und hat drei Reasoning-Modi, Low, Medium und High, wobei High der Standard ist. Das Hugging-Face-Repository ist Mistral-; die API-ID ist mistral-.
Die Gewichte erscheinen unter der Mistral Ecosystem Open-Weight-Lizenz, einer modifizierten MIT. Kommerzielle Nutzung und Fine-Tuning sind erlaubt. Der Verkauf des Modells als gehosteter Dienst erfordert eine separate kommerzielle Lizenz von Mistral. Du kannst es mit vLLM oder SGLang betreiben, über NVIDIA NIM oder TensorRT-LLM, oder Mistrals eigene API, Microsoft Foundry und Mistral Vibe Code nutzen.
Bei Benchmarks nennt Mistral eigene Zahlen: 41% auf Terminal-Bench 4.0 (die Preview erreichte 28%), 19.7% auf FrontierCode 2.0, 84.5% auf BrowseComp und 48% auf dem Artificial Analysis Coding Agent Index, was laut Mistral auf dem Niveau von GLM-5.3 bei 47% weniger Tokens pro Aufgabe liegt. Das sind die Ergebnisse des Anbieters, keine unabhängigen, also behandle sie als Grund, auf deinem eigenen Repo zu testen, nicht als Urteil.
Was eine Agent-Aufgabe zum Mistral-Preis kostet#
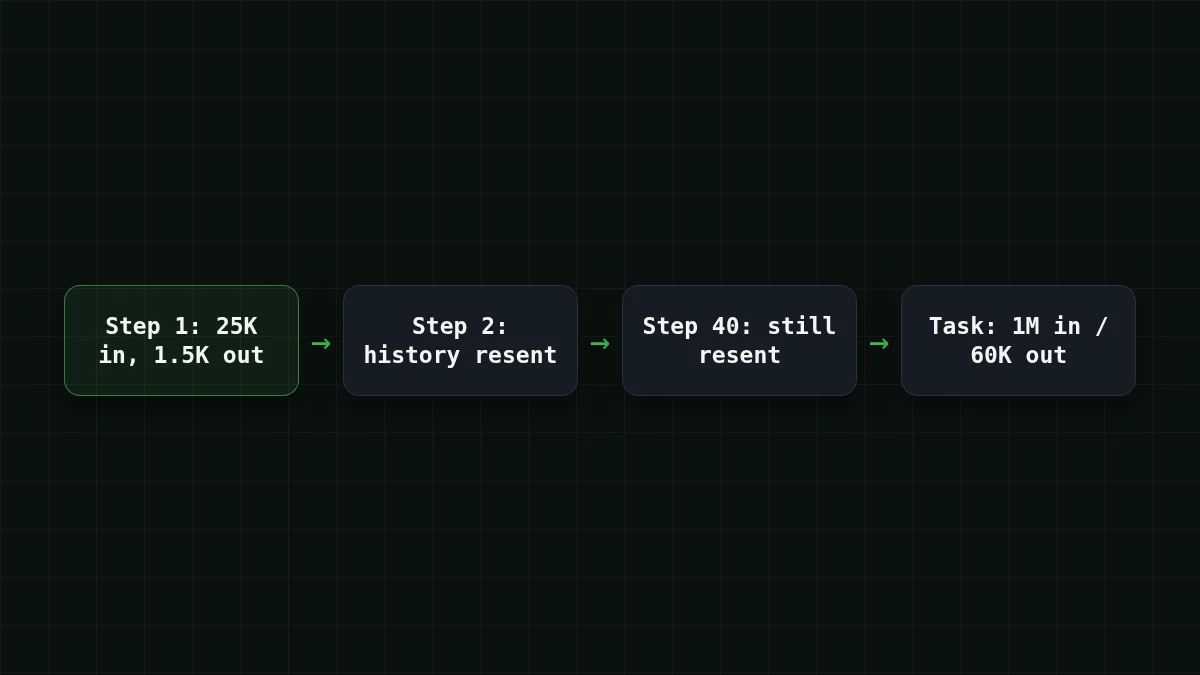
Beginne damit, wie ein Agent wirklich Tokens verbraucht. Jeder Schritt sendet die bisherige Konversation erneut, sodass sich der Input anhäuft, während jede Antwort kurz bleibt. Nehmen wir an, ein Terminal-Coding-Agent braucht 40 Schritte für eine Aufgabe, mit etwa 25.000 Input-Tokens und 1.500 Output-Tokens pro Schritt. Das ist eine Annahme zur Veranschaulichung; setze deine eigenen Zahlen ein.
Zahl erraten
40 Schritte mit je etwa 25.000 Input-Tokens: Wie viele Tausend Input-Tokens sendet die Aufgabe insgesamt?
Deine Schätzung
02.000
Antwort anzeigen
Antwort: 1.000
25.000 × 40 = 1.000.000 Input-Tokens, also 1.000 Tausend. Der Agent sendet seinen Kontext bei jedem Schritt erneut, weshalb das Input-Volumen die Agent-Rechnungen dominiert.
Zum veröffentlichten Preis von Mistral (30. Oktober 2026) kostet diese Aufgabe 1.000.000 × $0.70 / 1M = $0.70 für Input und 60.000 × $2.10 / 1M = $0.126 für Output, also $0.70 + $0.126 = $0.826 pro Aufgabe. Die Input-Seite macht den Großteil der Rechnung aus.
Caching ändert das Bild. Wenn 20.000 der 25.000 Input-Tokens in jedem Schritt aus dem Cache zu $0.07 pro 1M bedient werden, kostet ein Schritt 20.000 × $0.07 / 1M = $0.0014 für gecachten Input, 5.000 × $0.70 / 1M = $0.0035 für frischen Input und 1.500 × $2.10 / 1M = $0.00315 für Output. Das sind $0.00805 pro Schritt und $0.00805 × 40 = $0.322 pro Aufgabe. Die 80% Cache-Hit-Rate ist eine weitere Annahme, also prüfe, was dein Tool meldet.
Hier ist dieselbe Arbeitslast auf einem Rechner, den du verschieben kannst:
Kostenrechner
Eine Coding-Agent-Aufgabe: 40 Schritte
Eingabe-Tokens pro Anfrage: 25.000 · Ausgabe-Tokens pro Anfrage: 1.500 · Anfragen pro Tag: 40
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
Und dieselbe Aufgabe bepreist über CheapTokens-Modelle, live, neben OpenRouter:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 40 Anfragen | OpenRouter, 40 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25.000 Input- und 1.500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Für diese Agent-Schleife kommt DeepSeek-V4-Flash auf CheapTokens auf $0.021 für die gesamte Aufgabe, insgesamt mit Input und Output zusammengerechnet, und es ist insgesamt günstiger als OpenRouters Referenzpreis. Es hat ein 380K-Kontextfenster und bis zu 32.768 Output-Tokens pro Antwort, zu einem Preis zu jeder Tageszeit.
Open Weights oder die API#
Die Gewichte sind der interessante Teil dieses Releases. Wenn deine Daten dein Netzwerk nicht verlassen dürfen oder du fine-tunen willst, kannst du das jetzt mit einem Modell dieser Klasse tun. Der Preis dafür ist Hardware. Ein Modell mit 1T Parametern braucht einen Multi-GPU-Server, selbst wenn pro Token nur ein Teil davon aktiv ist, und Mistrals Seite nennt die Anzahl der aktiven Parameter nicht (das A52B im Repository-Namen deutet auf 52B hin, aber das ist eine Schlussfolgerung aus dem Namen). Mistrals Seite nennt auch die Kontextgröße nicht.
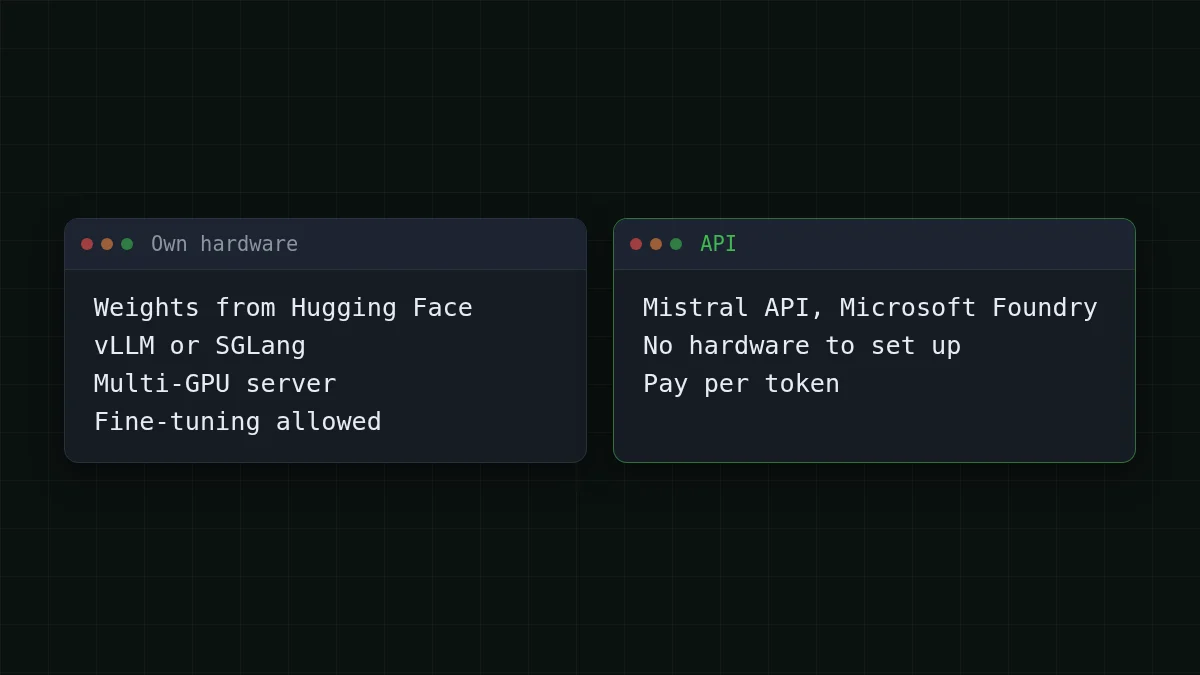
Für die meisten Teams, die nur wollen, dass ein Agent Tickets erledigt, vermeidet der API-Weg dieses Setup. Wenn du den Hintergrund dazu willst, was Open Weights in der Praxis bedeuten, siehe was Open Weights und Quantisierung sind.
Dieselbe Aufgabe auf einem Agent-Modell, das du heute aufrufen kannst#
Wenn dein Ziel ein Terminal- oder IDE-Agent ist, der viele Schritte günstig ausführt, kannst du dieselbe Schleife auf DeepSeek-V4-Flash oder GLM-5.3-Flash über CheapTokens ausprobieren. Die API ist kompatibel mit OpenAI Chat Completions und Anthropic Messages, mit einem Guthaben für alle Modelle. Verwende die vollständige Modell-ID aus den CheapTokens-Docs; Modellnamen unterscheiden sich zwischen Anbietern.
Eine Anfrage, zwei Clients
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Das Feld usage in der Antwort zeigt Input- und Output-Tokens, sodass du den Schritt deines eigenen Agents messen und in den Rechner oben einsetzen kannst. Unser Cline-Kostenleitfaden zeigt, wie du eine ganze Sitzung budgetierst, und die Docs behandeln das Anbinden anderer Tools. Modellseiten: günstiges DeepSeek und Live-Preise.
Welches für welche Aufgabe#
Open Weights auf deiner eigenen Hardware und Fine-Tuning sind ein separater Weg, und genau den öffnet dieses Release. Für eine lange Schleife aus kurzen Schritten nutze DeepSeek-V4-Flash auf CheapTokens: 380K Kontext, bis zu 32.768 Output-Tokens pro Antwort, ein Preis zu jeder Tageszeit und insgesamt günstiger als OpenRouter, mit Input und Output zusammengerechnet. GLM-5.3-Flash hat einen 390K-Kontext. Mistrals Benchmark vergleicht gegen GLM-5.3 und sagt nicht, welche GLM-5.3-Variante, also übertrage seine Zahlen nicht auf GLM-5.3-Flash. Führe zehn eigene Aufgaben auf jedem aus und vergleiche die Token-Zahlen; derselbe Ansatz steht in wie sich der GPT-6.1 Terra-Preis pro Aufgabe ergibt.


