Tin tức AICập nhật
Trọng số mở Mistral Large 4: giá API và chi phí mỗi tác vụ agent
Mistral Large 4 giờ đã mở trọng số, với giá API từ Mistral. Xem một tác vụ coding-agent tốn bao nhiêu và khi nào một mô hình rẻ hơn phù hợp.
Trên trang này
Mistral Large 4 giờ đã mở trọng số: Mistral công bố trọng số vào ngày 29 tháng 10 năm 2026 và đặt giá API ở mức $0.70 cho 1M token đầu vào và $2.10 cho 1M token đầu ra ($0.07 cho đầu vào được cache). Nếu bạn chạy các coding agent, câu hỏi hữu ích không phải là giá mỗi token mà là một tác vụ dài cộng lại tốn bao nhiêu.
Mistral đã công bố gì#
Theo trang phát hành của Mistral (kiểm tra ngày 30 tháng 10 năm 2026), Mistral Large 4 là một mô hình khoảng 1T tham số, kết hợp giữa instruct và reasoning, được xây dựng dưới dạng mixture of experts. Nó đa phương thức gốc ở đầu vào, hỗ trợ hơn 160 ngôn ngữ và có ba chế độ reasoning: Low, Medium và High, với High là mặc định. Kho Hugging Face là Mistral-; id API là mistral-.
Trọng số được phát hành theo giấy phép Mistral Ecosystem Open-Weight, một dạng MIT sửa đổi. Sử dụng thương mại và fine-tuning được phép. Bán mô hình dưới dạng dịch vụ lưu trữ cần giấy phép thương mại riêng từ Mistral. Bạn có thể chạy nó với vLLM hoặc SGLang, qua NVIDIA NIM hoặc TensorRT-LLM, hoặc dùng API riêng của Mistral, Microsoft Foundry và Mistral Vibe Code.
Về benchmark, Mistral báo cáo các con số của chính mình: 41% trên Terminal-Bench 4.0 (bản preview đạt 28%), 19.7% trên FrontierCode 2.0, 84.5% trên BrowseComp, và 48% trên Artificial Analysis Coding Agent Index, mà Mistral nói là ngang với GLM-5.3 với ít hơn 47% token mỗi tác vụ. Đây là kết quả của nhà cung cấp, không phải độc lập, nên hãy coi đó là lý do để thử trên repo của bạn chứ không phải một phán quyết.
Một tác vụ agent tốn bao nhiêu theo giá của Mistral#
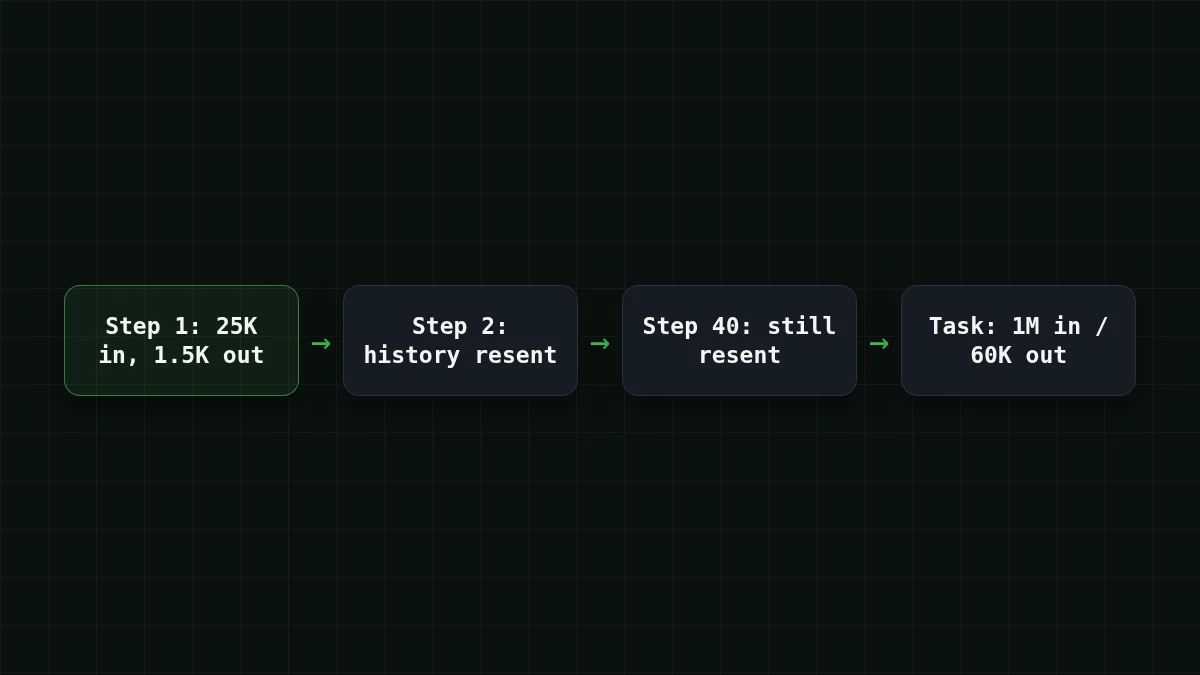
Hãy bắt đầu từ cách một agent thực sự tiêu token. Mỗi bước gửi lại toàn bộ cuộc hội thoại đến thời điểm đó, nên đầu vào tích lũy trong khi mỗi câu trả lời vẫn ngắn. Giả sử một terminal coding agent thực hiện 40 bước cho một tác vụ, với khoảng 25,000 token đầu vào và 1,500 token đầu ra mỗi bước. Đó là một giả định để minh họa; hãy thay bằng con số của bạn.
Đoán số
40 bước với khoảng 25,000 token đầu vào mỗi bước: tác vụ gửi tổng cộng bao nhiêu nghìn token đầu vào?
Dự đoán của bạn
02.000
Hiện đáp án
Trả lời: 1.000
25,000 × 40 = 1,000,000 token đầu vào, tức 1,000 nghìn. Agent gửi lại ngữ cảnh ở mỗi bước, đó là lý do khối lượng đầu vào chiếm ưu thế trong hóa đơn của agent.
Theo giá công bố của Mistral (30 tháng 10 năm 2026), tác vụ đó là 1,000,000 × $0.70 / 1M = $0.70 cho đầu vào và 60,000 × $2.10 / 1M = $0.126 cho đầu ra, vậy $0.70 + $0.126 = $0.826 mỗi tác vụ. Phần đầu vào chiếm phần lớn hóa đơn.
Cache thay đổi bức tranh. Nếu 20,000 trong số 25,000 token đầu vào ở mỗi bước được phục vụ từ cache với giá $0.07 mỗi 1M, một bước tốn 20,000 × $0.07 / 1M = $0.0014 cho đầu vào được cache, 5,000 × $0.70 / 1M = $0.0035 cho đầu vào mới và 1,500 × $2.10 / 1M = $0.00315 cho đầu ra. Đó là $0.00805 mỗi bước, và $0.00805 × 40 = $0.322 mỗi tác vụ. Tỷ lệ cache hit 80% là một giả định khác, nên hãy kiểm tra con số công cụ của bạn báo cáo.
Đây là cùng khối lượng công việc trên một máy tính bạn có thể điều chỉnh:
Máy tính chi phí
Một tác vụ coding-agent: 40 bước
Token đầu vào mỗi yêu cầu: 25.000 · Token đầu ra mỗi yêu cầu: 1.500 · Số yêu cầu mỗi ngày: 40
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
Và cùng tác vụ được định giá trên các mô hình CheapTokens, trực tiếp, bên cạnh OpenRouter:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 40 yêu cầu | OpenRouter, 40 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25.000 token đầu vào và 1.500 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Với vòng lặp agent này, DeepSeek-V4-Flash trên CheapTokens tốn $0.021 cho toàn bộ tác vụ, tính tổng cả đầu vào và đầu ra, và rẻ hơn giá tham chiếu của OpenRouter khi tính tổng. Nó có cửa sổ ngữ cảnh 380K và tối đa 32,768 token đầu ra mỗi câu trả lời, với một mức giá vào bất kỳ giờ nào trong ngày.
Trọng số mở hay API#
Trọng số là phần thú vị của bản phát hành này. Nếu dữ liệu của bạn không thể rời khỏi mạng của bạn, hoặc bạn muốn fine-tune, giờ bạn có thể làm điều đó với một mô hình thuộc đẳng cấp này. Chi phí của hướng đó là phần cứng. Một mô hình 1T tham số cần một máy chủ đa GPU ngay cả khi chỉ một phần của nó hoạt động mỗi token, và trang của Mistral không nêu số tham số hoạt động (A52B trong tên kho gợi ý 52B, nhưng đó là suy luận từ tên). Trang của Mistral cũng không nêu kích thước ngữ cảnh.
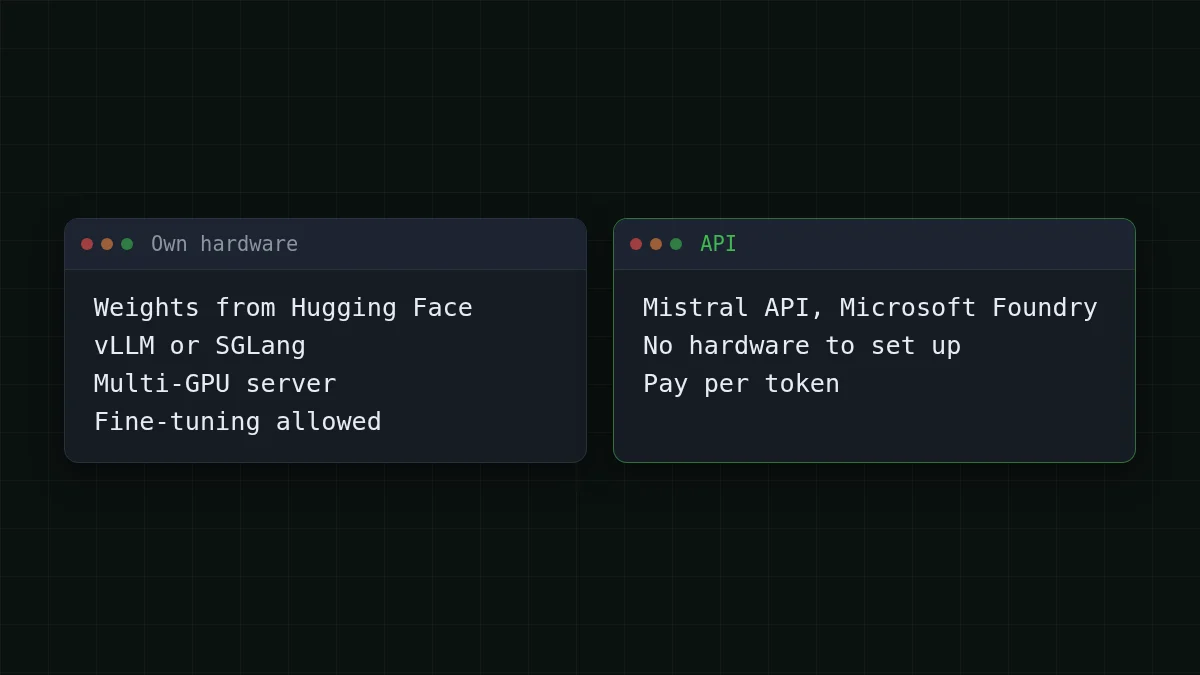
Với hầu hết các nhóm chỉ muốn một agent hoàn thành ticket, hướng API tránh được việc thiết lập đó. Nếu bạn muốn hiểu nền tảng về ý nghĩa thực tế của trọng số mở, xem trọng số mở và lượng tử hóa là gì.
Cùng tác vụ trên một mô hình agent bạn có thể gọi ngay hôm nay#
Nếu mục tiêu của bạn là một terminal hoặc IDE agent chạy nhiều bước với chi phí thấp, bạn có thể thử cùng vòng lặp trên DeepSeek-V4-Flash hoặc GLM-5.3-Flash qua CheapTokens. API tương thích với OpenAI Chat Completions và Anthropic Messages, với một số dư cho tất cả mô hình. Dùng id mô hình đầy đủ từ tài liệu CheapTokens; tên mô hình khác nhau giữa các nhà cung cấp.
Một yêu cầu, hai client
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Trường usage trong phản hồi hiển thị token đầu vào và đầu ra, nên bạn có thể đo bước của agent của mình và đưa vào máy tính ở trên. Hướng dẫn chi phí Cline của chúng tôi chỉ cách lập ngân sách cho cả một phiên, và tài liệu hướng dẫn kết nối các công cụ khác. Trang mô hình: DeepSeek giá rẻ, và giá trực tiếp.
Cái nào cho công việc nào#
Trọng số mở trên phần cứng của riêng bạn, và fine-tuning, là một hướng riêng, và đó là điều bản phát hành này mở ra. Với một vòng lặp dài gồm các bước ngắn, hãy dùng DeepSeek-V4-Flash trên CheapTokens: ngữ cảnh 380K, tối đa 32,768 token đầu ra mỗi câu trả lời, một mức giá vào bất kỳ giờ nào trong ngày, và rẻ hơn OpenRouter khi tính tổng, cả đầu vào và đầu ra cộng lại. GLM-5.3-Flash có ngữ cảnh 390K. Benchmark của Mistral so sánh với GLM-5.3, và không nói rõ là biến thể GLM-5.3 nào, nên đừng áp các con số đó lên GLM-5.3-Flash. Hãy chạy mười tác vụ của riêng bạn trên mỗi mô hình và so sánh số token; cách tiếp cận tương tự có trong cách giá GPT-6.1 Terra tính ra mỗi tác vụ.


