AI समाचारअपडेट
Mistral Large 4 ओपन वेट्स: API कीमत और प्रति एजेंट कार्य लागत
Mistral Large 4 अब ओपन-वेट है, Mistral की API कीमत के साथ। देखें कि एक कोडिंग-एजेंट कार्य का क्या खर्च है और कब सस्ता मॉडल फिट बैठता है।
इस पृष्ठ पर
Mistral Large 4 अब ओपन-वेट है: Mistral ने 29 अक्टूबर 2026 को वेट्स प्रकाशित किए और API की कीमत $0.70 प्रति 1M इनपुट टोकन और $2.10 प्रति 1M आउटपुट टोकन ($0.07 कैश्ड इनपुट के लिए) तय की। अगर आप कोडिंग एजेंट चलाते हैं, तो उपयोगी सवाल प्रति टोकन कीमत नहीं, बल्कि यह है कि एक लंबा काम कुल मिलाकर कितना पड़ता है।
Mistral ने क्या घोषित किया#
Mistral के रिलीज़ पेज (30 अक्टूबर 2026 को जाँचा गया) के अनुसार, Mistral Large 4 लगभग 1T पैरामीटर का मॉडल है, जो instruct और reasoning का हाइब्रिड है और mixture of experts के रूप में बना है। यह इनपुट पर नेटिव रूप से मल्टीमॉडल है, 160+ भाषाओं को कवर करता है और इसमें तीन reasoning मोड हैं, Low, Medium और High, जिनमें High डिफ़ॉल्ट है। Hugging Face रिपॉज़िटरी Mistral- है; API id mistral- है।
वेट्स Mistral Ecosystem Open-Weight लाइसेंस के तहत आते हैं, जो संशोधित MIT है। व्यावसायिक उपयोग और फाइन-ट्यूनिंग की अनुमति है। मॉडल को होस्टेड सेवा के रूप में बेचने के लिए Mistral से अलग व्यावसायिक लाइसेंस चाहिए। आप इसे vLLM या SGLang के साथ, NVIDIA NIM या TensorRT-LLM के ज़रिए, या Mistral के अपने API, Microsoft Foundry और Mistral Vibe Code का उपयोग करके चला सकते हैं।
बेंचमार्क पर Mistral अपने ही आँकड़े बताता है: Terminal-Bench 4.0 पर 41% (प्रीव्यू ने 28% स्कोर किया), FrontierCode 2.0 पर 19.7%, BrowseComp पर 84.5%, और Artificial Analysis Coding Agent Index पर 48%, जिसके बारे में Mistral कहता है कि यह प्रति कार्य 47% कम टोकन के साथ GLM-5.3 के बराबर है। ये विक्रेता के परिणाम हैं, स्वतंत्र नहीं, इसलिए इन्हें अपने ही रेपो पर परखने की वजह मानें, फैसला नहीं।
Mistral की कीमत पर एक एजेंट कार्य का खर्च#
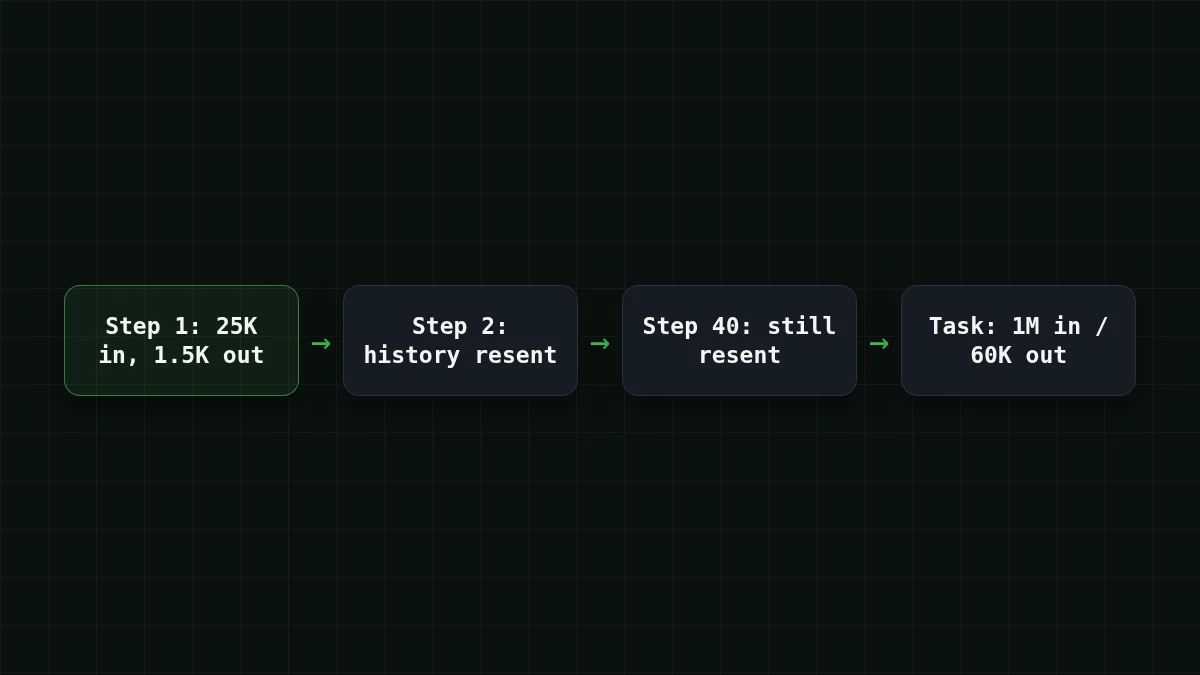
शुरुआत इससे करें कि एजेंट वास्तव में टोकन कैसे खर्च करता है। हर चरण अब तक की बातचीत फिर से भेजता है, इसलिए इनपुट जमा होता जाता है जबकि हर उत्तर छोटा रहता है। मान लें कि एक टर्मिनल कोडिंग एजेंट एक कार्य पर 40 चरण लेता है, प्रति चरण लगभग 25,000 इनपुट टोकन और 1,500 आउटपुट टोकन के साथ। यह उदाहरण के लिए एक अनुमान है; अपने ही आँकड़े डालें।
संख्या का अनुमान लगाएँ
40 चरण, प्रत्येक में लगभग 25,000 इनपुट टोकन: कार्य कुल मिलाकर कितने हज़ार इनपुट टोकन भेजता है?
आपका अनुमान
02,000
उत्तर दिखाएँ
उत्तर: 1,000
25,000 × 40 = 1,000,000 इनपुट टोकन, यानी 1,000 हज़ार। एजेंट हर चरण पर अपना कॉन्टेक्स्ट फिर से भेजता है, इसीलिए एजेंट बिलों में इनपुट की मात्रा हावी रहती है।
Mistral की प्रकाशित कीमत (30 अक्टूबर 2026) पर वह कार्य 1,000,000 × $0.70 / 1M = $0.70 इनपुट के लिए और 60,000 × $2.10 / 1M = $0.126 आउटपुट के लिए, यानी $0.70 + $0.126 = $0.826 प्रति कार्य। बिल का ज़्यादातर हिस्सा इनपुट पक्ष है।
कैशिंग तस्वीर बदल देती है। अगर हर चरण में 25,000 इनपुट टोकन में से 20,000 कैश से $0.07 प्रति 1M पर परोसे जाते हैं, तो एक चरण का खर्च कैश्ड इनपुट के लिए 20,000 × $0.07 / 1M = $0.0014, ताज़ा इनपुट के लिए 5,000 × $0.70 / 1M = $0.0035 और आउटपुट के लिए 1,500 × $2.10 / 1M = $0.00315 है। यह $0.00805 प्रति चरण है, और $0.00805 × 40 = $0.322 प्रति कार्य। 80% कैश हिट दर भी एक अनुमान है, इसलिए देखें कि आपका टूल क्या बताता है।
यहाँ वही वर्कलोड एक ऐसे कैलकुलेटर पर है जिसे आप बदल सकते हैं:
लागत कैलकुलेटर
एक कोडिंग-एजेंट कार्य: 40 चरण
प्रति अनुरोध इनपुट टोकन: 25,000 · प्रति अनुरोध आउटपुट टोकन: 1,500 · प्रति दिन अनुरोध: 40
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
और वही कार्य CheapTokens मॉडलों पर, लाइव, OpenRouter के साथ-साथ कीमत के साथ:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 40 अनुरोध | OpenRouter, 40 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
प्रति अनुरोध 25,000 इनपुट और 1,500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
इस एजेंट लूप के लिए, CheapTokens पर DeepSeek-V4-Flash पूरे कार्य के लिए $0.021 पर आता है, इनपुट और आउटपुट दोनों को मिलाकर कुल में, और कुल में यह OpenRouter के संदर्भ मूल्य से सस्ता है। इसमें 380K कॉन्टेक्स्ट विंडो और प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन हैं, दिन के किसी भी घंटे में एक ही कीमत पर।
ओपन वेट्स या API#
इस रिलीज़ का दिलचस्प हिस्सा वेट्स हैं। अगर आपका डेटा आपके नेटवर्क से बाहर नहीं जा सकता, या आप फाइन-ट्यून करना चाहते हैं, तो अब आप यह इस श्रेणी के मॉडल के साथ कर सकते हैं। उस रास्ते की लागत हार्डवेयर है। 1T-पैरामीटर मॉडल के लिए मल्टी-GPU सर्वर चाहिए, भले ही प्रति टोकन उसका केवल एक हिस्सा सक्रिय हो, और Mistral का पेज सक्रिय पैरामीटर संख्या नहीं बताता (रिपॉज़िटरी नाम में A52B 52B की ओर इशारा करता है, लेकिन यह नाम से एक अनुमान है)। Mistral का पेज कॉन्टेक्स्ट आकार भी नहीं बताता।
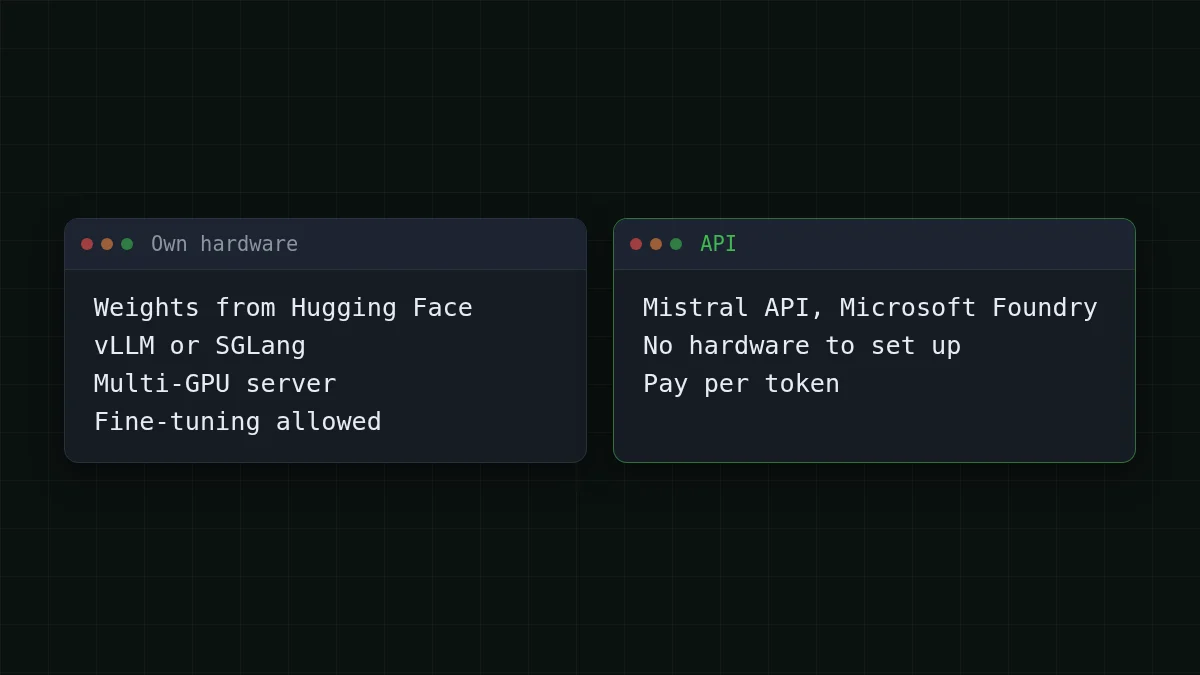
उन ज़्यादातर टीमों के लिए जो बस चाहते हैं कि एक एजेंट टिकट पूरे करे, API का रास्ता उस सेटअप से बचाता है। अगर आप जानना चाहते हैं कि व्यवहार में ओपन वेट्स का क्या मतलब है, तो देखें ओपन वेट्स और क्वांटाइज़ेशन क्या हैं।
वही कार्य एक एजेंट मॉडल पर जिसे आप आज कॉल कर सकते हैं#
अगर आपका लक्ष्य एक टर्मिनल या IDE एजेंट है जो कई चरण सस्ते में चलाए, तो आप वही लूप CheapTokens के ज़रिए DeepSeek-V4-Flash या GLM-5.3-Flash पर आज़मा सकते हैं। API OpenAI Chat Completions और Anthropic Messages के साथ संगत है, सभी मॉडलों के लिए एक ही बैलेंस के साथ। CheapTokens डॉक्स से पूरा मॉडल id इस्तेमाल करें; मॉडल नाम प्रदाताओं के बीच अलग होते हैं।
एक अनुरोध, दो क्लाइंट
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
रिस्पॉन्स में usage फ़ील्ड इनपुट और आउटपुट टोकन दिखाता है, इसलिए आप अपने एजेंट के चरण को माप सकते हैं और ऊपर के कैलकुलेटर में डाल सकते हैं। हमारी Cline लागत गाइड दिखाती है कि पूरे सत्र का बजट कैसे बनाएँ, और डॉक्स अन्य टूल जोड़ने को कवर करते हैं। मॉडल पेज: सस्ता DeepSeek, और लाइव मूल्य निर्धारण।
किस काम के लिए कौन सा#
अपने हार्डवेयर पर ओपन वेट्स, और फाइन-ट्यूनिंग, एक अलग रास्ता है, और यही इस रिलीज़ से खुलता है। छोटे चरणों के लंबे लूप के लिए, CheapTokens पर DeepSeek-V4-Flash इस्तेमाल करें: 380K कॉन्टेक्स्ट, प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन, दिन के किसी भी घंटे में एक ही कीमत, और कुल में OpenRouter से सस्ता, इनपुट और आउटपुट दोनों को मिलाकर। GLM-5.3-Flash में 390K कॉन्टेक्स्ट है। Mistral का बेंचमार्क GLM-5.3 से तुलना करता है, और यह नहीं बताता कि कौन सा GLM-5.3 वेरिएंट, इसलिए इसके आँकड़ों को GLM-5.3-Flash पर मत पढ़ें। अपने दस कार्य हर एक पर चलाएँ और टोकन गिनती की तुलना करें; वही तरीका GPT-6.1 Terra की कीमत प्रति कार्य कैसे निकलती है में है।


