AIニュースアップデート
Mistral Large 4 のオープンウェイト:API 価格とエージェントタスクあたりのコスト
Mistral Large 4 がオープンウェイトになり、Mistral の API 価格が設定されました。コーディングエージェントタスク1つにかかるコストと、より安価なモデルが適する場合を見ます。
Mistral Large 4 がオープンウェイトになりました。Mistral は 2026年10月29日に重みを公開し、API 価格を入力 100万トークンあたり $0.70、出力 100万トークンあたり $2.10(キャッシュ入力は $0.07)に設定しました。コーディングエージェントを動かすなら、有用な問いはトークン単価ではなく、1つの長いタスクが合計でいくらになるかです。
Mistral の発表内容#
Mistral のリリースページ(2026年10月30日確認)によると、Mistral Large 4 は約 1T パラメータのモデルで、instruct と reasoning を組み合わせたハイブリッドを mixture of experts として構築しています。入力はネイティブにマルチモーダルで、160以上の言語に対応し、推論モードは Low、Medium、High の3つで、デフォルトは High です。Hugging Face リポジトリは Mistral-、API id は mistral- です。
重みは MIT を改変した Mistral Ecosystem Open-Weight ライセンスで提供されます。商用利用とファインチューニングは許可されています。モデルをホスト型サービスとして販売するには、Mistral から別途商用ライセンスが必要です。vLLM や SGLang、NVIDIA NIM や TensorRT-LLM 経由で実行するか、Mistral 自身の API、Microsoft Foundry、Mistral Vibe Code を利用できます。
ベンチマークでは Mistral が自社の数値を報告しています。Terminal-Bench 4.0 で 41%(プレビューは 28%)、FrontierCode 2.0 で 19.7%、BrowseComp で 84.5%、Artificial Analysis Coding Agent Index で 48% で、Mistral によればタスクあたりのトークン数が 47% 少ない状態で GLM-5.3 の 47% と同等だといいます。これらはベンダーの結果であり独立したものではないため、判定ではなく自分のリポジトリで試す理由として扱ってください。
Mistral の価格でエージェントタスク1つにかかるコスト#
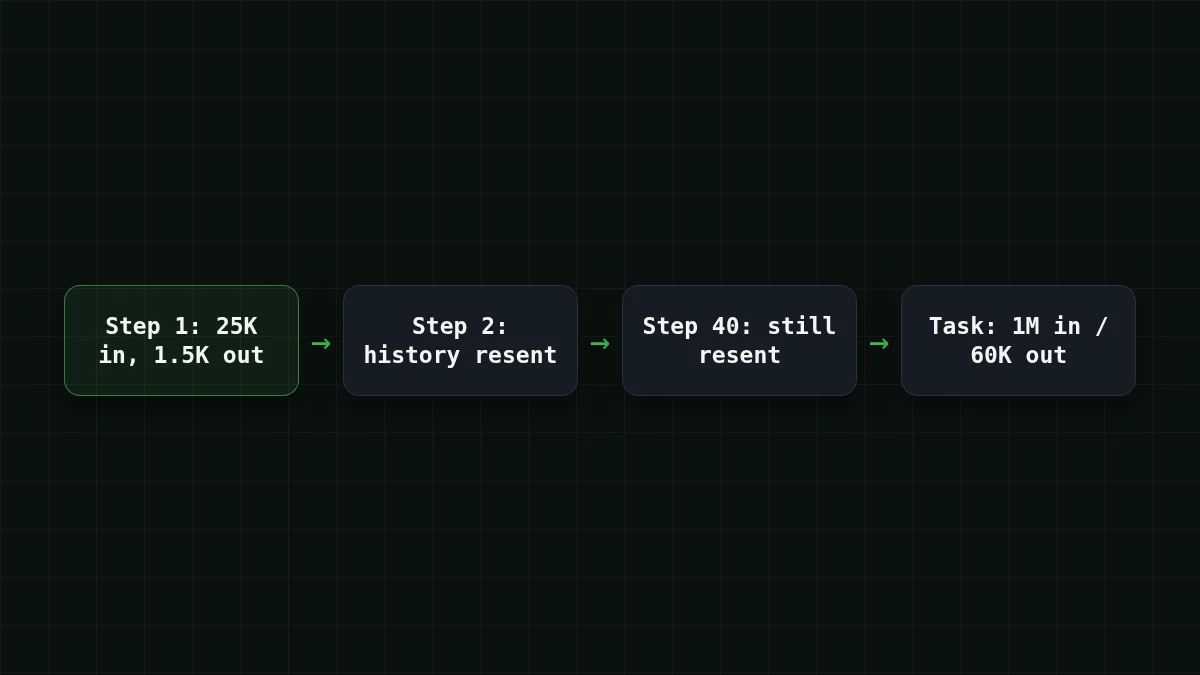
まず、エージェントが実際にどうトークンを使うかを考えます。各ステップでそれまでの会話を再送するため、入力が積み上がる一方で各回答は短く保たれます。ターミナルのコーディングエージェントが1つのタスクで40ステップかかり、1ステップあたり入力約25,000トークン、出力1,500トークンだとします。これは説明のための仮定です。自分の数値に置き換えてください。
数字を当てる
各ステップ約25,000入力トークンで40ステップ:このタスクは合計で何千入力トークンを送るか?
あなたの予想
02,000
答えを表示
答え: 1,000
25,000 × 40 = 1,000,000入力トークン、つまり1,000千。エージェントは毎ステップでコンテキストを再送するため、入力量がエージェントの請求額を支配します。
Mistral の公開価格(2026年10月30日)では、そのタスクは入力が 1,000,000 × $0.70 / 1M = $0.70、出力が 60,000 × $2.10 / 1M = $0.126 なので、$0.70 + $0.126 = タスクあたり $0.826 です。請求額の大半は入力側です。
キャッシュは状況を変えます。各ステップの25,000入力トークンのうち20,000が 100万トークンあたり $0.07 でキャッシュから提供される場合、1ステップはキャッシュ入力が 20,000 × $0.07 / 1M = $0.0014、新規入力が 5,000 × $0.70 / 1M = $0.0035、出力が 1,500 × $2.10 / 1M = $0.00315 です。つまり1ステップ $0.00805 で、$0.00805 × 40 = タスクあたり $0.322 です。80% のキャッシュヒット率も仮定なので、自分のツールが報告する値を確認してください。
同じワークロードを動かせる計算機で見ると:
コスト計算機
コーディングエージェントタスク1つ:40ステップ
リクエストあたりの入力トークン数: 25,000 · リクエストあたりの出力トークン数: 1,500 · 1日あたりのリクエスト数: 40
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
そして同じタスクを CheapTokens のモデル群でライブ価格にし、OpenRouter と並べると:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 40 リクエスト | OpenRouter、40 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
リクエストあたり 25,000 入力トークンと 1,500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
このエージェントループでは、CheapTokens の DeepSeek-V4-Flash がタスク全体で $0.021 となり、入力と出力を合計した総額で、OpenRouter の参考価格より安くなります。コンテキストウィンドウは 380K、回答あたり最大 32,768 出力トークンで、1日のどの時間帯でも同一価格です。
オープンウェイトか API か#
このリリースで興味深いのは重みです。データをネットワーク外に出せない場合やファインチューニングしたい場合、このクラスのモデルでそれができるようになりました。そのルートのコストはハードウェアです。1T パラメータのモデルは、トークンごとに一部しかアクティブでなくてもマルチ GPU サーバーが必要で、Mistral のページにはアクティブパラメータ数が記載されていません(リポジトリ名の A52B は 52B を示唆しますが、それは名前からの推測です)。Mistral のページにはコンテキストサイズも記載されていません。
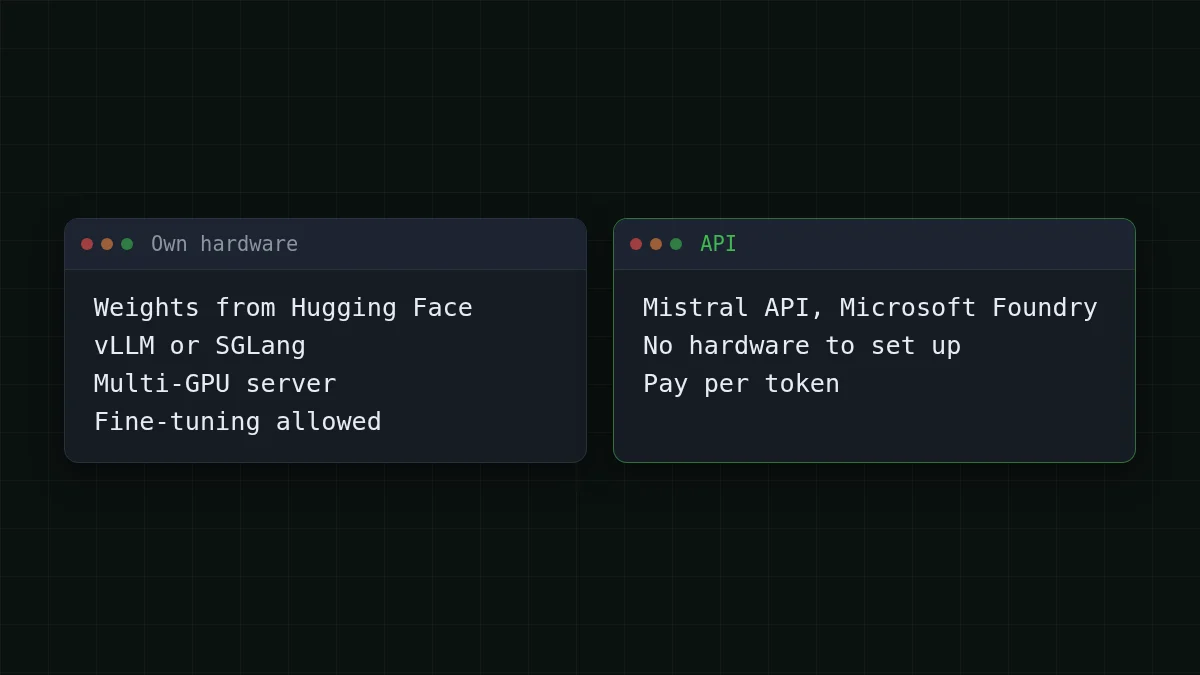
チケットを完了するエージェントが欲しいだけのほとんどのチームにとって、API ルートはそのセットアップを避けられます。オープンウェイトが実際に何を意味するかの背景は、オープンウェイトと量子化とは何かを参照してください。
今日呼び出せるエージェントモデルで同じタスク#
目標が多くのステップを安く実行するターミナルまたは IDE エージェントなら、CheapTokens 経由で DeepSeek-V4-Flash や GLM-5.3-Flash で同じループを試せます。API は OpenAI Chat Completions と Anthropic Messages に互換で、全モデルで1つの残高を使います。プロバイダー間でモデル名は異なるため、CheapTokens のドキュメントにある完全なモデル id を使用してください。
1つのリクエスト、2つのクライアント
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
レスポンスの usage フィールドは入力と出力のトークン数を示すので、自分のエージェントのステップを測定して上の計算機に当てはめられます。Cline のコストガイドではセッション全体の予算の立て方を示し、ドキュメントでは他のツールの接続方法を扱っています。モデルページ:安価な DeepSeek、ライブ価格。
どの仕事にどれを#
自前ハードウェアでのオープンウェイトとファインチューニングは別の道であり、このリリースが開くのはそこです。短いステップが長く続くループには、CheapTokens の DeepSeek-V4-Flash を使ってください。コンテキスト 380K、回答あたり最大 32,768 出力トークン、1日のどの時間帯でも同一価格で、入力と出力を合計した総額で OpenRouter より安価です。GLM-5.3-Flash はコンテキスト 390K です。Mistral のベンチマークは GLM-5.3 と比較しており、どの GLM-5.3 バリアントかは述べていないため、その数値を GLM-5.3-Flash に当てはめて読まないでください。自分のタスクを各モデルで10個実行し、トークン数を比較してください。同じアプローチは GPT-6.1 Terra の価格がタスクあたりどうなるかにあります。


