AI入門ガイド
オープンウェイトとは?2ビットと4ビットの量子化を解説
オープンウェイトとはモデルファイルをダウンロードできるという意味です。量子化はファイルを小さくします。2ビットが忠実度に与えるコストと、APIがより簡単な場合を説明します。
モデルの発表を開くと、UD-Q2_K_XL というファイルの横に「オープンウェイト」と書かれているのを目にします。手短に言えば、オープンウェイトとは開発者がモデルのファイルを公開したという意味で、誰でもダウンロードして実行できます。2ビットとは、内部のすべての数値がわずか2ビットで保存されるという意味で、ファイルははるかに小さくなり、モデルは少しぼやけます。ダウンロードを避けたい場合は、代わりにAPI経由でモデルを呼び出せます。CheapTokensのドキュメントに最初のリクエストの方法が載っています。
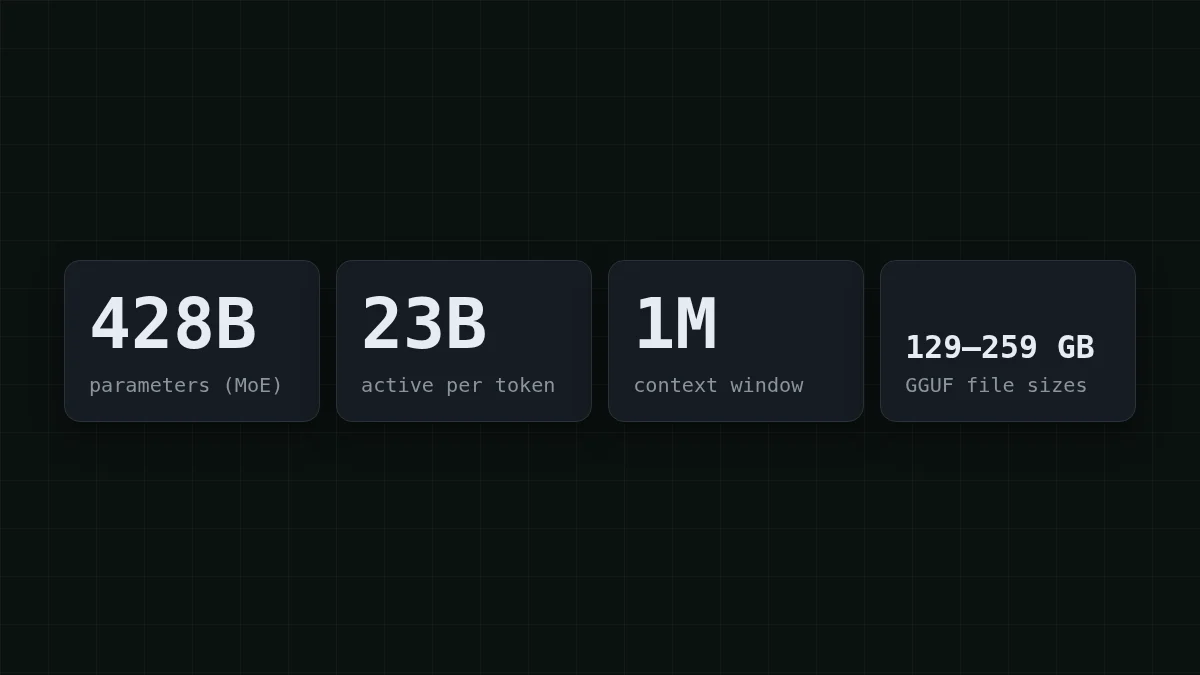
以下の例は実在のものです。MiniMax-M3.1-FlashのUnslothのモデルページ(日付なし、2026年10月27日確認)には、M3.1 Flashのローンチ記事で取り上げたモデルのGGUFファイルが129.4 GBから259.1 GBまで掲載されています。ここに示すサイズとメモリの数値はすべてそのページから引用しています。
よく目にする用語#
4280億個のダイヤルが付いたミキシングコンソールを想像してください。トレーニングは出力が正しく聞こえるまで各ダイヤルを微調整します。すべてのダイヤルの最終位置がモデルのウェイトです。そのリストを公開すればオープンウェイトモデルになり、自分のサーバーに置いておけばAPI経由でしかアクセスできません。
フラッシュカード
あらゆる発表で出会う用語
カードをタップしてめくる
初心者が陥る2つの罠。「オープンウェイト」は自動的に「あらゆる用途で無料」ではありません。ライセンスが決めることであり、Unslothのページには記載がないため、商用利用の前にモデルカード(Hugging FaceのMiniMaxAI/)を読んでください。また「ダウンロード無料」は「実行無料」ではありません。次のセクションで示します。
なぜ1つのモデルが130〜260 GBのダウンロードになるのか#
4280億個のウェイトはそれぞれ数値であり、数値にはスペースが必要です。目安は 個数 × ビット数 ÷ 8 = バイト数 です。読み進める前に試してみてください。
数字を当てる
80億個のウェイトを各4ビットで保存すると何GBになるか?
あなたの予想
016
答えを表示
答え: 4
4ビットは0.5バイトなので、80億 × 0.5バイト = 4 GB。
ではスケールアップしましょう。ウェイトあたり2ビットでも、428 × 2 ÷ 8 = 107 GBがモデル全体の下限です。実際の2ビットファイルは143.9 GBで下限より少し上なので、ファイル名のビット数は正確な数ではなくラベルです。
「23Bアクティブ」という数字はストレージではなく速度に関するものです。各トークンではモデルの一部のスライスだけが動作するため高速ですが、スライスはトークンごとに変わるので、428Bのウェイトすべてを読み込んで待機させておく必要があります。
2ビットと4ビットが実際に何をするか#
定規を考えてください。ビット数は目盛りの数を決めます。2ビットで4目盛り、4ビットで16、8ビットで256、通常の16ビットで65,536です。量子化は各ウェイトを最も近い目盛りに丸めます。目盛りが少ないほどファイルは小さくなり、各数値の丸め誤差は大きくなります。
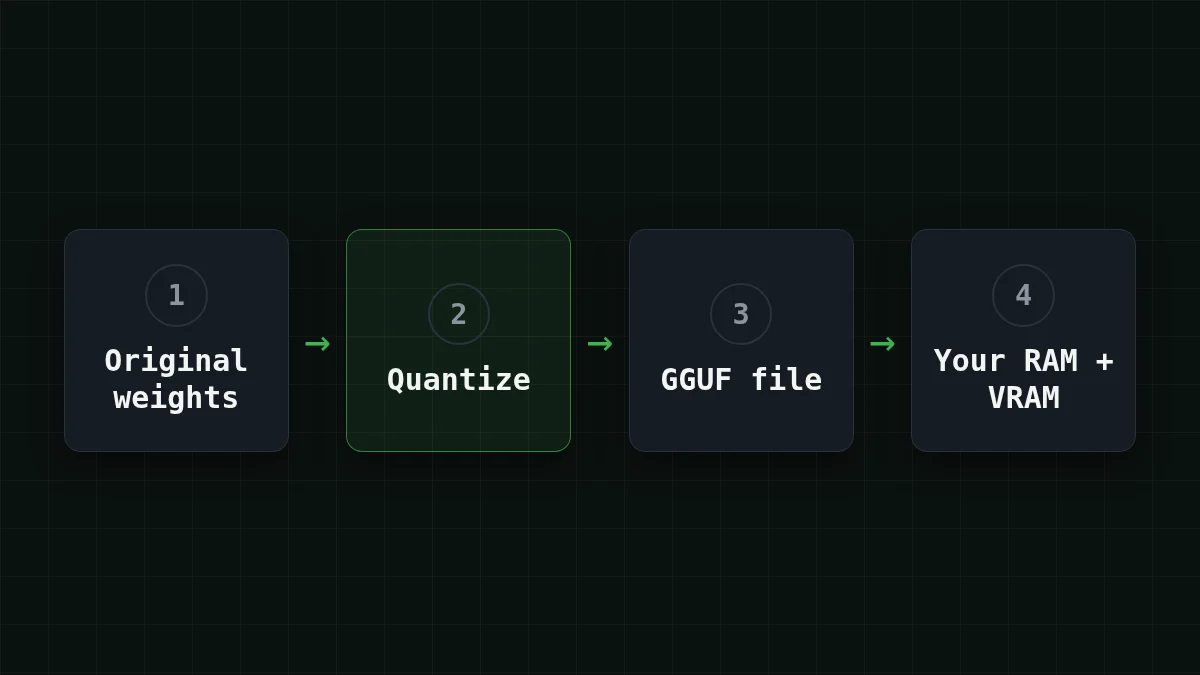
以下はこのモデルのUnslothのラインナップで、1セッションあたり16Kコンテキストで必要なメモリ(RAM+VRAM)を示しています。サイズは10進GBです。
テーブルを右にスクロールしてください →
| レベル | ファイル(サイズ) | 必要なメモリ |
|---|---|---|
| 1ビット | UD-IQ1_M (129.4 GB) | 約134 GB |
| 2ビット | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | 約150〜160+ GB |
| 3ビット | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176〜208 GB |
| 4ビット | UD-Q4_K_XL (249.4 GB) | 約256 GB |
| 8ビット | UD-Q8_K_XL (259.1 GB) | 約272 GB |
名前の読み方:UD-Q2_K_XL は約2ビットのUnsloth Dynamicビルドです。数字はレベル、文字はバリアントです。数字で計算しないでください。8ビットファイルは2ビットの約1.8倍(259.1 ÷ 143.9 ≈ 1.8)であり、4倍ではありません。サイズはダウンロードページで確認してください。
自分で試す試してみましょう:あなたのマシンのメモリは合計128 GBです。これらのファイルはどれか収まりますか?答えを表示
いいえ。最小のUD-IQ1_Mでも16Kコンテキストで約134 GBのRAM+VRAMが必要なので、128 GBでは足りません。2ビットファイルは約150〜160+ GB必要です。
2ビットで失うもの#
写真をより小さいJPEGとして保存するのと比べてください。画像の大部分は残り、損傷は細部に現れます。Unslothは、2ビットファイル(143.9 GB)が7つのカテゴリ(コーディング、数学、チャット、ツール、多言語、推論、エージェント)で元のモデルと91.5%の加重一致に達すると報告しています。
その数字を注意深く読んでください。これはUnsloth自身の指標であり、ページにはベースラインや重み付けが明記されていないため、大まかな目安として扱い、独立したテストとは考えないでください。一致は正確さでもありません。小さいファイルが大きいファイルにどれだけ近く振る舞うかを示すもので、どちらがどれだけ正しいかではありません。小さな違いは、エージェントが20回のツール呼び出しを実行するような長いステップの連鎖で積み重なる可能性があるため、依存する前に自分のタスクで量子化を試してください。高いレベルほど元のモデルに近く、より多くのメモリを消費します。
ダウンロードかAPI呼び出しか?#
発表を読んでモデルを試したいとします。自分に当てはまる行を選んでください。
ケースを選ぶ
あなたに当てはまるのはどれですか?
オプションを選択して答えを表示
16〜32 GBのメモリのラップトップ
ローカルルートは閉ざされています。1ビットファイルでも約134 GBのRAM+VRAMが必要です。代わりにAPI経由でモデルを呼び出してください。
約192 GBのメモリのワークステーション
2ビットファイル(約150〜160+ GB必要)は余裕を持って収まります。3ビットはファイルによって176〜208 GB必要なので、ダウンロード前に目的のファイルの正確な数値を確認してください。まずライセンスを確認してください。
API経由でモデルを試したいだけ
ダウンロードをスキップ。API呼び出しは従量課金制で、テキストを送って回答を得るだけで、ディスク上に130 GBのファイルは不要です。
3番目の場合、1回のリクエストで感触がつかめます。これはDeepSeek-V4-Flashへのリクエストで、380Kのコンテキストウィンドウを持ち、最大32,768トークンの回答が可能で、1日を通して同一価格です:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'回答はchoices[0].で返り、usageフィールドで支払ったトークン数がわかります。トークンとは何かわからない場合、平易な英語の説明は5分で読めます。MiniMax-M2.7も同様に利用でき、180Kのコンテキストウィンドウと回答あたり最大8,192トークンです。どちらもOpenAI/Anthropic互換APIを使用し、1つの残高ですべてのモデルをカバーします。
請求書ではどう見えるでしょうか?小さなサポートボットが1日2,000リクエストを送り、各リクエストが入力1,500トークン、出力500トークンだとします。そのようなリクエスト1回のコストはMiniMax-M2.7で$0.00015です。以下は各モデルの1日分をOpenRouterと並べたものです:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 2,000 リクエスト | OpenRouter、2,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
リクエストあたり 1,500 入力トークンと 500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
入力と出力を合計すると、CheapTokensはOpenRouterより安くなります。すべてのモデルの現在の価格は料金ページにあります。
ハードウェアがあり、速度と実行コストを比較したい場合は、DeepSeekをローカルで実行するかAPIを使うで詳しく説明しています。そしてこれらの言葉はすぐまた目にするでしょう。Kimi K3.1 Proのオープンウェイトは11月4日に公開予定で、ローンチ記事で説明しています。


