O que são open weights? Quantização 2-bit e 4-bit explicada
Open weights significam que você pode baixar os arquivos do modelo. A quantização os reduz: veja o que 2-bit custa em fidelidade e quando uma API é mais simples.
Nesta página
Você abre o anúncio de um modelo e vê “open weights” ao lado de um arquivo chamado UD-Q2_K_XL. Resposta curta: open weights significa que o desenvolvedor publicou os arquivos do modelo, então qualquer pessoa pode baixá-los e executá-los. 2-bit significa que cada número interno é armazenado com apenas dois bits: o arquivo fica bem menor e o modelo fica um pouco mais embaçado. Se preferir pular o download, você pode chamar modelos por uma API; a documentação do CheapTokens mostra a primeira requisição.
O exemplo abaixo é real. A página do modelo MiniMax-M3.1-Flash no Unsloth (sem data; verificada em 27 de outubro de 2026) lista arquivos GGUF de 129,4 GB a 259,1 GB para um modelo que cobrimos no post de lançamento do M3.1 Flash. Todos os tamanhos e números de memória aqui vêm dessa página.
As palavras que você continua encontrando#
Imagine uma mesa de mixagem com 428 bilhões de botões. O treinamento ajusta cada botão até a saída soar certa. A posição final de todos os botões são os pesos do modelo. Publique essa lista e você tem um modelo open-weight; mantenha-a nos seus próprios servidores e o único jeito de entrar é por uma API.
Flashcards
Palavras que você vai encontrar em todo anúncio
Toque num cartão para virar
Duas armadilhas para iniciantes. “Open-weight” não é automaticamente “livre para qualquer uso”: a licença decide, e a página do Unsloth não a informa, então leia o model card (MiniMaxAI/ no Hugging Face) antes de construir qualquer coisa comercial. E “grátis para baixar” não é “grátis para executar”, como as próximas seções mostram.
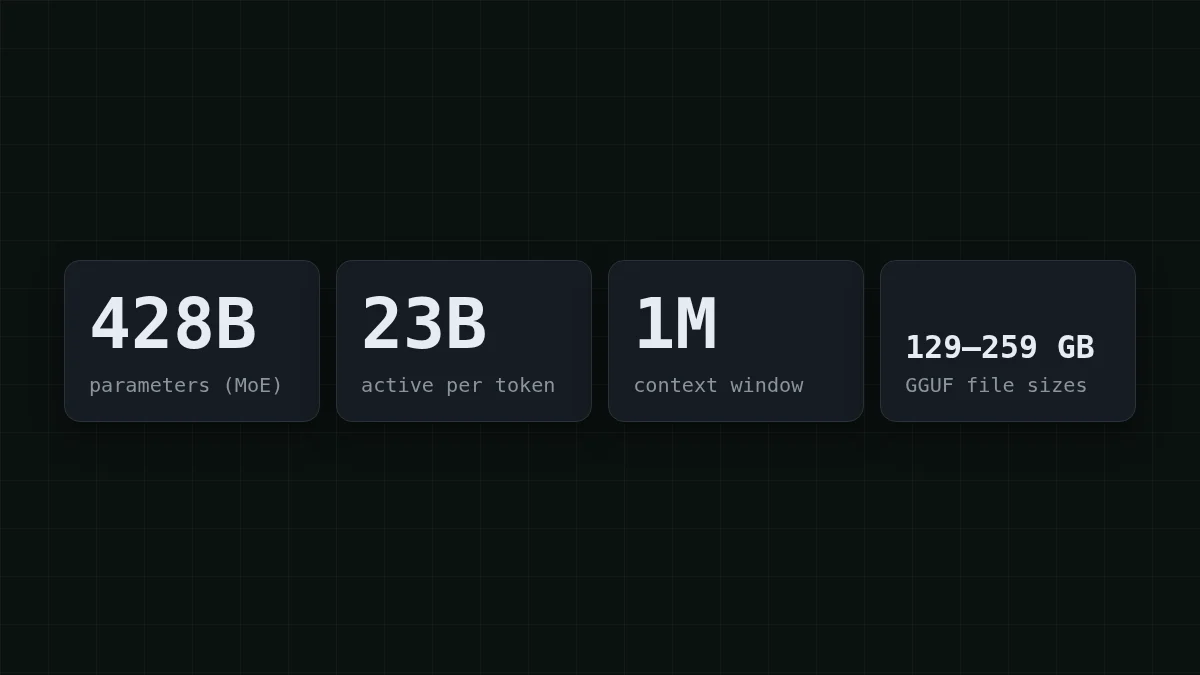
Por que um modelo é um download de 130–260 GB#
Cada um desses 428 bilhões de pesos é um número, e números ocupam espaço. A regra de bolso é contagem × bits ÷ 8 = bytes. Tente antes de continuar lendo.
Adivinhar o número
Quantos GB ocupam 8 bilhões de pesos quando cada um é armazenado em 4 bits?
O seu palpite
016
Mostrar resposta
Resposta: 4
4 bits é meio byte, então 8 bilhões × 0,5 byte = 4 GB.
Agora aumente a escala. Mesmo a 2 bits por peso, 428 × 2 ÷ 8 = 107 GB é o piso para o modelo inteiro. O arquivo real de 2 bits tem 143,9 GB, um pouco acima do piso, então o número de bits no nome do arquivo é um rótulo, não uma contagem exata.
O número “23B ativos” é sobre velocidade, não armazenamento. Apenas uma fração do modelo trabalha em cada token, o que o torna rápido, mas a fração muda de token para token, então todos os 428B de pesos precisam estar carregados e esperando.
O que 2-bit e 4-bit realmente fazem#
Pense em uma régua. Os bits decidem quantas marcas ela tem: 2 bits dão 4 marcas, 4 bits dão 16, 8 bits dão 256, e os habituais 16 bits dão 65.536. A quantização arredonda cada peso para a marca mais próxima. Menos marcas significa um arquivo menor e um erro de arredondamento maior em cada número.
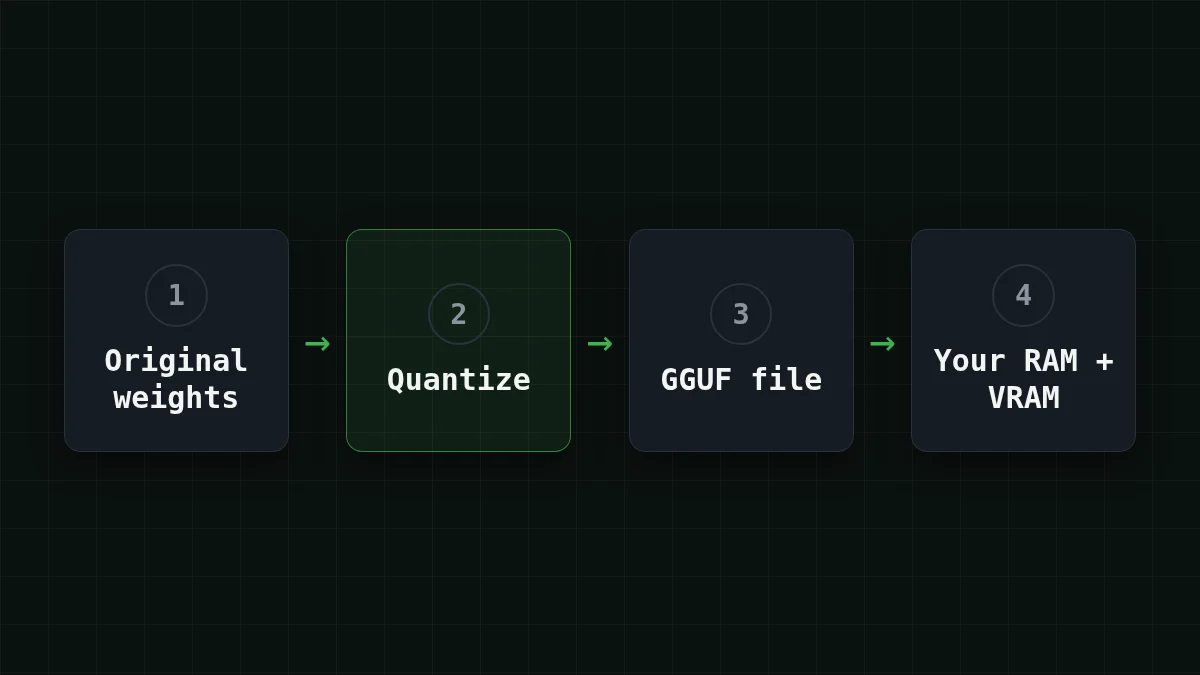
Aqui está a linha do Unsloth para o modelo, com a memória (RAM mais VRAM) necessária em contexto de 16K para uma sessão. Tamanhos em GB decimais.
Role a tabela para a direita →
| Nível | Arquivos (tamanho) | Memória necessária |
|---|---|---|
| 1-bit | UD-IQ1_M (129,4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134,9 GB), UD-Q2_K_XL (143,9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160,0 GB), UD-IQ3_S (175,5 GB), UD-Q3_K_XL (194,0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249,4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259,1 GB) | ~272 GB |
Lendo um nome: UD-Q2_K_XL é uma build Unsloth Dynamic com cerca de 2 bits; o dígito é o nível e as letras são variantes. Não faça aritmética com o dígito. O arquivo de 8 bits tem apenas cerca de 1,8 vezes o de 2 bits (259,1 ÷ 143,9 ≈ 1,8), não 4 vezes. Leia o tamanho na página de download.
Experimente você mesmoTeste: sua máquina tem 128 GB de memória no total. Algum desses arquivos cabe?Mostrar resposta
Não. Mesmo o menor, UD-IQ1_M, precisa de cerca de 134 GB de RAM mais VRAM em contexto de 16K, então 128 GB é insuficiente. Os arquivos de 2 bits precisam de cerca de 150–160+ GB.
O que você abre mão em 2 bits#
Compare com salvar uma foto como um JPEG menor: a maior parte da imagem sobrevive, e o dano aparece nos detalhes finos. O Unsloth relata que seu arquivo de 2 bits (143,9 GB) alcança 91,5% de concordância ponderada com o modelo original em sete categorias: programação, matemática, chat, ferramentas, multilíngue, raciocínio e agêntico.
Leia esse número com cuidado. É uma medida do próprio Unsloth, e a página não detalha a linha de base nem a ponderação, então trate como um guia aproximado e não como um teste independente. Concordância também não é acurácia: ela diz o quão próximo o arquivo pequeno se comporta do grande, não com que frequência cada um está certo. Pequenas diferenças podem se acumular ao longo de uma longa cadeia de passos, como um agente executando vinte chamadas de ferramentas, então teste um quant na sua própria tarefa antes de confiar nele. Níveis mais altos ficam mais próximos do original e custam mais memória.
Baixar ou chamar uma API?#
Digamos que você queira experimentar o modelo depois de ler o anúncio. Escolha a linha que parece com você.
Escolha o seu caso
Qual descreve você?
Escolha uma opção para ver a resposta
Um laptop com 16–32 GB de memória
A rota local está fechada: até o arquivo de 1 bit precisa de cerca de 134 GB de RAM mais VRAM. Chame um modelo por uma API.
Uma workstation com cerca de 192 GB de memória
Os arquivos de 2 bits (cerca de 150–160+ GB necessários) cabem com folga. Os de 3 bits precisam de 176–208 GB dependendo do arquivo, então confira o número exato do arquivo que você quer antes de baixar. Verifique a licença primeiro.
Só quero experimentar um modelo por uma API
Pule o download. Uma chamada de API é pay-as-you-go: você envia texto e recebe uma resposta, sem um arquivo de 130 GB no disco.
Para a terceira linha, uma requisição basta para ver como é. Esta vai para o DeepSeek-V4-Flash, que tem uma janela de contexto de 380K e responde com até 32.768 tokens, a um preço único em qualquer hora do dia:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
A resposta volta em choices[0]., e o campo usage informa quantos tokens você pagou. Não sabe o que é um token? A explicação em linguagem simples leva cinco minutos. O MiniMax-M2.7 está disponível da mesma forma, com uma janela de contexto de 180K e até 8.192 tokens por resposta. Ambos usam uma API compatível com OpenAI/Anthropic, e um único saldo cobre todos os modelos.
Como isso aparece na fatura? Digamos que um pequeno bot de suporte envie 2.000 requisições por dia, cada uma com 1.500 tokens de entrada e 500 de saída. Uma dessas requisições custa $0.00015 no MiniMax-M2.7. Aqui está o dia inteiro para cada modelo, ao lado do OpenRouter:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 2.000 solicitações | OpenRouter, 2.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1.500 tokens de entrada e 500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
No total, com entrada e saída contadas juntas, o CheapTokens sai mais barato que o OpenRouter. Os preços atuais de cada modelo estão na página de preços.
Se você tem o hardware e quer comparar velocidade e custos de execução, Rodar o DeepSeek localmente ou usar uma API passa por isso. E espere essas palavras de novo em breve: os pesos abertos do Kimi K3.1 Pro estão previstos para 4 de novembro, como explica nosso post de lançamento.


