AI สำหรับผู้เริ่มต้นคู่มือ
open weights คืออะไร? อธิบายการควอนไทซ์ 2-bit และ 4-bit
open weights หมายความว่าคุณดาวน์โหลดไฟล์โมเดลได้ การควอนไทซ์ทำให้เล็กลง ดูว่า 2-bit เสียความเที่ยงตรงแค่ไหน และเมื่อไหร่ที่ API ง่ายกว่า
ในหน้านี้
คุณเปิดประกาศเปิดตัวโมเดลแล้วเห็นคำว่า “open weights” อยู่ข้างไฟล์ชื่อ UD-Q2_K_XL คำตอบสั้น ๆ: open weights หมายความว่านักพัฒนาปล่อยไฟล์ของโมเดลออกมา ใครก็ดาวน์โหลดไปรันได้ 2-bit หมายความว่าตัวเลขทุกตัวข้างในถูกเก็บด้วยแค่สองบิต ไฟล์จึงเล็กลงมาก และโมเดลก็เบลอขึ้นเล็กน้อย ถ้าไม่อยากเสียเวลาดาวน์โหลด เรียกโมเดลผ่าน API แทนได้เลย เอกสาร CheapTokens แสดงคำขอแรกให้ดู
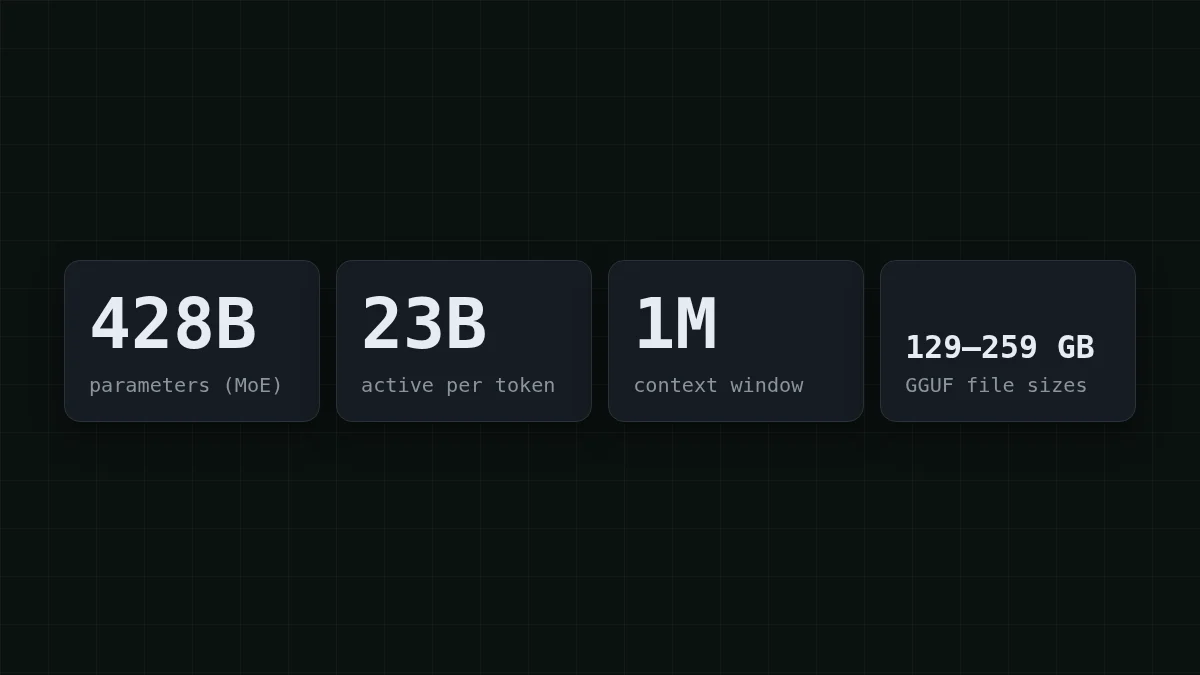
ตัวอย่างด้านล่างเป็นของจริง หน้าโมเดลของ Unsloth สำหรับ MiniMax-M3.1-Flash (ไม่ระบุวันที่ ตรวจสอบเมื่อ 27 ตุลาคม 2026) แสดงไฟล์ GGUF ตั้งแต่ 129.4 GB ถึง 259.1 GB สำหรับโมเดลที่เราเขียนถึงในโพสต์เปิดตัว M3.1 Flash ขนาดและตัวเลขหน่วยความจำทั้งหมดในที่นี้มาจากหน้านั้น
คำศัพท์ที่คุณเจอบ่อย#
ลองนึกถึงมิกเซอร์ที่มีปุ่มหมุน 428 พันล้านปุ่ม การเทรนจะขยับทุกปุ่มจนเสียงออกมาถูก ตำแหน่งสุดท้ายของปุ่มทั้งหมดคือ weights ของโมเดล ปล่อยรายการนั้นออกมาแล้วคุณก็ได้โมเดลแบบ open-weight เก็บไว้บนเซิร์ฟเวอร์ตัวเองแล้วทางเข้าเดียวคือ API
แฟลชการ์ด
คำศัพท์ที่คุณจะเจอในทุกประกาศ
แตะการ์ดเพื่อพลิก
กับดักสองข้อสำหรับมือใหม่ “Open-weight” ไม่ได้หมายถึง “ใช้ฟรีทุกกรณี” โดยอัตโนมัติ สัญญาอนุญาตเป็นตัวตัดสิน และหน้าเว็บของ Unsloth ไม่ได้ระบุไว้ ดังนั้นอ่าน model card (MiniMaxAI/ บน Hugging Face) ก่อนสร้างอะไรเชิงพาณิชย์ และ “ดาวน์โหลดฟรี” ไม่เท่ากับ “รันฟรี” ซึ่งส่วนถัดไปจะแสดงให้เห็น
ทำไมโมเดลเดียวจึงเป็นไฟล์ดาวน์โหลด 130–260 GB#
weight ทั้ง 428 พันล้านตัวแต่ละตัวคือตัวเลข และตัวเลขกินพื้นที่ กฎง่าย ๆ คือ จำนวน × บิต ÷ 8 = ไบต์ ลองคำนวณก่อนอ่านต่อ
ทายตัวเลข
weight 8 พันล้านตัวกินพื้นที่กี่ GB เมื่อแต่ละตัวถูกเก็บด้วย 4 บิต?
คำตอบของคุณ
016
แสดงคำตอบ
คำตอบ: 4
4 บิตคือครึ่งไบต์ ดังนั้น 8 พันล้าน × 0.5 ไบต์ = 4 GB
ทีนี้ขยายขนาดขึ้น แม้ที่ 2 บิตต่อ weight 428 × 2 ÷ 8 = 107 GB คือขอบล่างสำหรับโมเดลทั้งตัว ไฟล์ 2-bit จริงมีขนาด 143.9 GB สูงกว่าขอบล่างเล็กน้อย ตัวเลขบิตในชื่อไฟล์จึงเป็นแค่ป้ายกำกับ ไม่ใช่จำนวนที่แน่นอน
ตัวเลข “23B active” เกี่ยวกับความเร็ว ไม่ใช่พื้นที่จัดเก็บ มีเพียงบางส่วนของโมเดลที่ทำงานกับแต่ละโทเคน ทำให้เร็ว แต่ส่วนที่ทำงานเปลี่ยนไปทุกโทเคน weight ทั้ง 428B จึงต้องถูกโหลดและรออยู่
2-bit และ 4-bit ทำอะไรจริง ๆ#
ลองนึกถึงไม้บรรทัด บิตกำหนดว่ามีกี่ขีด: 2 บิตให้ 4 ขีด, 4 บิตให้ 16, 8 บิตให้ 256 และ 16 บิตที่ใช้ทั่วไปให้ 65,536 การควอนไทซ์ปัด weight ทุกตัวไปยังขีดที่ใกล้ที่สุด ขีดน้อยลงหมายถึงไฟล์เล็กลงและความคลาดเคลื่อนจากการปัดมีมากขึ้นในแต่ละตัวเลข
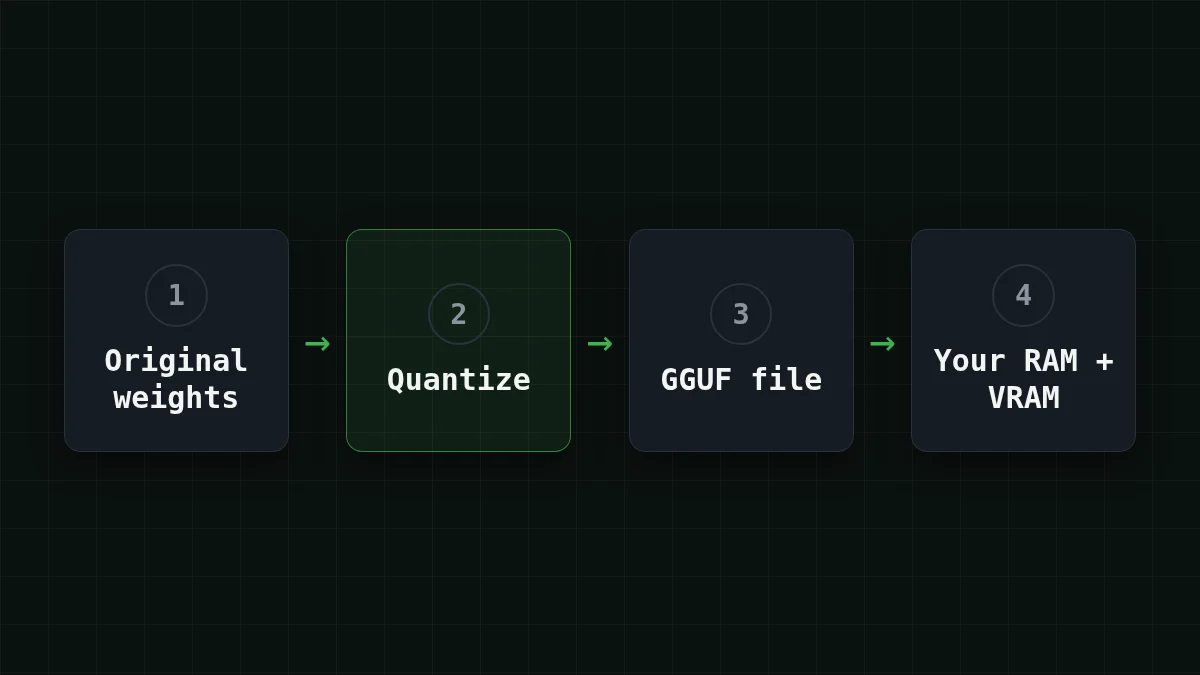
นี่คือไลน์อัปของ Unsloth สำหรับโมเดลนี้ พร้อมหน่วยความจำ (RAM บวก VRAM) ที่ต้องใช้ที่บริบท 16K สำหรับหนึ่งเซสชัน ขนาดเป็น GB แบบทศนิยม
เลื่อนตารางไปทางขวา →
| ระดับ | ไฟล์ (ขนาด) | หน่วยความจำที่ต้องใช้ |
|---|---|---|
| 1-bit | UD-IQ1_M (129.4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249.4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259.1 GB) | ~272 GB |
การอ่านชื่อ: UD-Q2_K_XL คือบิลด์ Unsloth Dynamic ที่ประมาณ 2 บิต ตัวเลขคือระดับและตัวอักษรคือตัวแปร อย่าเอาตัวเลขไปคำนวณ ไฟล์ 8-bit มีขนาดเพียงประมาณ 1.8 เท่าของ 2-bit (259.1 ÷ 143.9 ≈ 1.8) ไม่ใช่ 4 เท่า อ่านขนาดจากหน้าดาวน์โหลด
ลองด้วยตัวเองลองดู: เครื่องของคุณมีหน่วยความจำรวม 128 GB ไฟล์เหล่านี้มีไฟล์ไหนใส่ได้ไหม?แสดงคำตอบ
ไม่ได้ แม้แต่ไฟล์เล็กสุด UD-IQ1_M ก็ต้องใช้ RAM บวก VRAM ประมาณ 134 GB ที่บริบท 16K ดังนั้น 128 GB จึงไม่พอ ไฟล์ 2-bit ต้องใช้ประมาณ 150–160+ GB
สิ่งที่คุณเสียไปที่ 2 บิต#
เทียบกับการบันทึกรูปเป็น JPEG ที่เล็กลง: ภาพส่วนใหญ่ยังอยู่ ความเสียหายจะปรากฏในรายละเอียดเล็ก ๆ Unsloth รายงานว่าไฟล์ 2-bit ของมัน (143.9 GB) มีความสอดคล้องแบบถ่วงน้ำหนัก 91.5% กับโมเดลต้นฉบับในเจ็ดหมวดหมู่: การเขียนโค้ด, คณิตศาสตร์, แชท, เครื่องมือ, หลายภาษา, การให้เหตุผล และ agentic
อ่านตัวเลขนั้นให้ดี มันคือการวัดของ Unsloth เอง และหน้าเว็บไม่ได้ระบุ baseline หรือการถ่วงน้ำหนักไว้ จึงควรถือเป็นแนวทางคร่าว ๆ ไม่ใช่การทดสอบอิสระ ความสอดคล้องก็ไม่ใช่ความแม่นยำ: มันบอกว่าไฟล์เล็กทำงานเหมือนไฟล์ใหญ่แค่ไหน ไม่ได้บอกว่าอันไหนตอบถูกบ่อยกว่า ความต่างเล็ก ๆ อาจสะสมตลอดห่วงโซ่ขั้นตอนยาว ๆ เช่น agent ที่เรียกเครื่องมือยี่สิบครั้ง ดังนั้นลอง quant กับงานของคุณเองก่อนจะพึ่งพามัน ระดับที่สูงกว่าจะใกล้ต้นฉบับมากกว่าและกินหน่วยความจำมากกว่า
ดาวน์โหลดหรือเรียก API?#
สมมติว่าคุณอยากลองโมเดลหลังอ่านประกาศ เลือกบรรทัดที่ตรงกับคุณ
เลือกกรณีของคุณ
อันไหนตรงกับคุณ?
เลือกตัวเลือกเพื่อดูคำตอบ
แล็ปท็อปที่มีหน่วยความจำ 16–32 GB
เส้นทางในเครื่องปิดไปเลย แม้แต่ไฟล์ 1-bit ก็ต้องใช้ RAM บวก VRAM ประมาณ 134 GB เรียกโมเดลผ่าน API แทน
เวิร์กสเตชันที่มีหน่วยความจำประมาณ 192 GB
ไฟล์ 2-bit (ต้องใช้ประมาณ 150–160+ GB) ใส่ได้สบาย ๆ ไฟล์ 3-bit ต้องใช้ 176–208 GB ขึ้นอยู่กับไฟล์ ดังนั้นตรวจสอบตัวเลขที่แน่นอนของไฟล์ที่ต้องการก่อนดาวน์โหลด ตรวจสอบสัญญาอนุญาตก่อน
ฉันแค่อยากลองโมเดลผ่าน API
ข้ามการดาวน์โหลดไป การเรียก API คือจ่ายตามการใช้งาน: คุณส่งข้อความไปและได้คำตอบกลับมา โดยไม่มีไฟล์ 130 GB บนดิสก์
สำหรับบรรทัดที่สาม คำขอเดียวก็พอให้รู้สึกได้ อันนี้ส่งไปที่ DeepSeek-V4-Flash ซึ่งมีหน้าต่างบริบท 380K และตอบได้ยาวถึง 32,768 โทเคน ในราคาเดียวทุกชั่วโมงของวัน:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
คำตอบกลับมาใน choices[0]. และฟิลด์ usage บอกคุณว่าจ่ายค่าโทเคนไปกี่ตัว ไม่แน่ใจว่าโทเคนคืออะไร? คำอธิบายภาษาง่าย ๆ ใช้เวลาห้านาที MiniMax-M2.7 ก็ใช้ได้แบบเดียวกัน ด้วยหน้าต่างบริบท 180K และตอบได้สูงสุด 8,192 โทเคนต่อคำตอบ ทั้งคู่ใช้ API ที่เข้ากันได้กับ OpenAI/Anthropic และยอดเงินเดียวครอบคลุมทุกโมเดล
แล้วในบิลหน้าตาเป็นอย่างไร? สมมติบอทซัพพอร์ตตัวเล็กส่งคำขอ 2,000 ครั้งต่อวัน แต่ละครั้งมี 1,500 โทเคนขาเข้าและ 500 ขาออก คำขอแบบหนึ่งมีค่าใช้จ่าย $0.00015 บน MiniMax-M2.7 นี่คือทั้งวันของแต่ละโมเดล เทียบกับ OpenRouter:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 2,000 คำขอ | OpenRouter, 2,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1,500 โทเค็นอินพุตและ 500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
โดยรวม เมื่อนับขาเข้าและขาออกรวมกัน CheapTokens ออกมาถูกกว่า OpenRouter ราคาปัจจุบันของทุกโมเดลอยู่ที่หน้าราคา
ถ้าคุณมีฮาร์ดแวร์และอยากเทียบความเร็วและต้นทุนการรัน รัน DeepSeek ในเครื่องหรือใช้ API อธิบายไว้ครบ และเตรียมเจอคำเหล่านี้เร็ว ๆ นี้: open weights ของ Kimi K3.1 Pro จะออกในวันที่ 4 พฤศจิกายน ตามที่โพสต์เปิดตัวของเราอธิบาย


