Ano ang open weights? Ipinaliwanag ang 2-bit at 4-bit quantization
Ang open weights ay nangangahulugang maaari mong i-download ang mga file ng modelo. Pinapaliit sila ng quantization: tingnan ang halaga ng 2-bit sa fidelity at kung kailan mas simple ang API.
Sa pahinang ito
Bubuksan mo ang isang anunsyo ng modelo at makikita mo ang “open weights” sa tabi ng file na tinatawag na UD-Q2_K_XL. Maikling sagot: open weights ay nangangahulugang inilathala ng developer ang mga file ng modelo, kaya kahit sino ay makakapag-download at makakapagpatakbo nito. 2-bit ay nangangahulugang ang bawat numero sa loob ay naka-store gamit lamang ang dalawang bit: mas lumiliit nang husto ang file at medyo lumalabo ang modelo. Kung mas gusto mong laktawan ang download, maaari kang tumawag ng mga modelo sa pamamagitan ng API; ipinapakita ng CheapTokens docs ang unang request.
Ang halimbawa sa ibaba ay totoo. Ang model page ng Unsloth para sa MiniMax-M3.1-Flash (walang petsa; sinuri noong 27 Oktubre 2026) ay naglilista ng mga GGUF file mula 129.4 GB hanggang 259.1 GB para sa isang modelong tinalakay namin sa M3.1 Flash launch post. Ang bawat sukat at memory figure dito ay galing sa page na iyon.
Ang mga salitang paulit-ulit mong naririnig#
Isipin ang isang mixing desk na may 428 bilyong dial. Ang training ay nag-aadjust sa bawat dial hanggang sa tumunog nang tama ang output. Ang huling posisyon ng lahat ng dial ay ang weights ng modelo. Ilathala ang listahang iyon at mayroon kang open-weight model; panatilihin ito sa sarili mong server at ang tanging paraan papasok ay API.
Mga flashcard
Mga salitang makikita mo sa bawat anunsyo
I-tap ang card para i-flip ito
Dalawang bitag para sa mga baguhan. Ang “open-weight” ay hindi awtomatikong “libre para sa anumang gamit”: ang lisensya ang magpapasya, at hindi ito sinasabi ng page ng Unsloth, kaya basahin ang model card (MiniMaxAI/ sa Hugging Face) bago magtayo ng anumang komersyal. At ang “libreng i-download” ay hindi “libreng patakbuhin”, na ipinapakita ng mga susunod na seksyon.
Bakit ang isang modelo ay 130–260 GB na download#
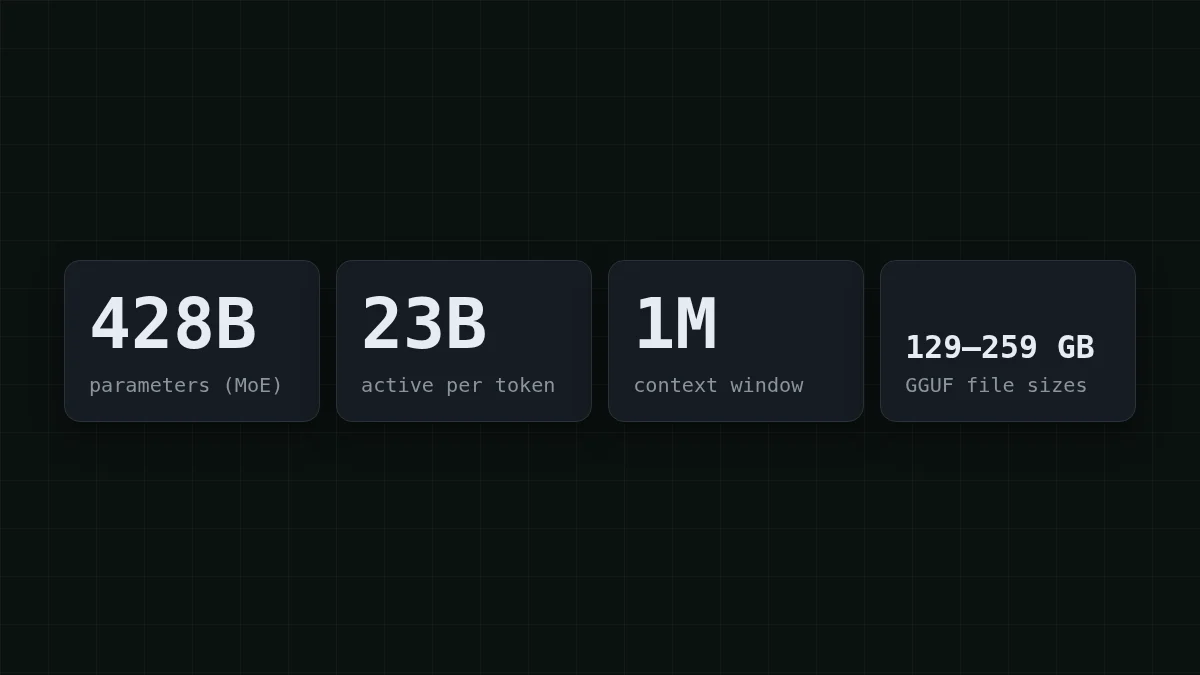
Ang bawat isa sa 428 bilyong weights na iyon ay isang numero, at ang mga numero ay kumukuha ng espasyo. Ang rule of thumb ay count × bits ÷ 8 = bytes. Subukan ito bago magpatuloy.
Hulaan ang numero
Ilang GB ang kinukuha ng 8 bilyong weights kapag ang bawat isa ay naka-store sa 4 bits?
Ang iyong hula
016
Ipakita ang sagot
Sagot: 4
Ang 4 bits ay kalahating byte, kaya 8 bilyon × 0.5 byte = 4 GB.
Ngayon palakihin natin. Kahit sa 2 bits bawat weight, ang 428 × 2 ÷ 8 = 107 GB ang pinakamababa para sa buong modelo. Ang tunay na 2-bit file ay 143.9 GB, medyo mataas sa pinakamababa, kaya ang bit number sa pangalan ng file ay isang label lamang at hindi eksaktong bilang.
Ang “23B active” na figure ay tungkol sa bilis, hindi sa storage. Isang slice lamang ng modelo ang gumagana sa bawat token, kaya mabilis ito, ngunit nagbabago ang slice mula token to token, kaya lahat ng 428B weights ay kailangang ma-load at naghihintay.
Ano ang aktwal na ginagawa ng 2-bit at 4-bit#
Isipin ang isang ruler. Ang bits ang nagtatakda kung ilang marka mayroon ito: 2 bits ay 4 na marka, 4 bits ay 16, 8 bits ay 256, at ang karaniwang 16 bits ay 65,536. Ang quantization ay nagro-round sa bawat weight sa pinakamalapit na marka. Mas kaunting marka ay nangangahulugang mas maliit na file at mas malaking rounding error sa bawat numero.
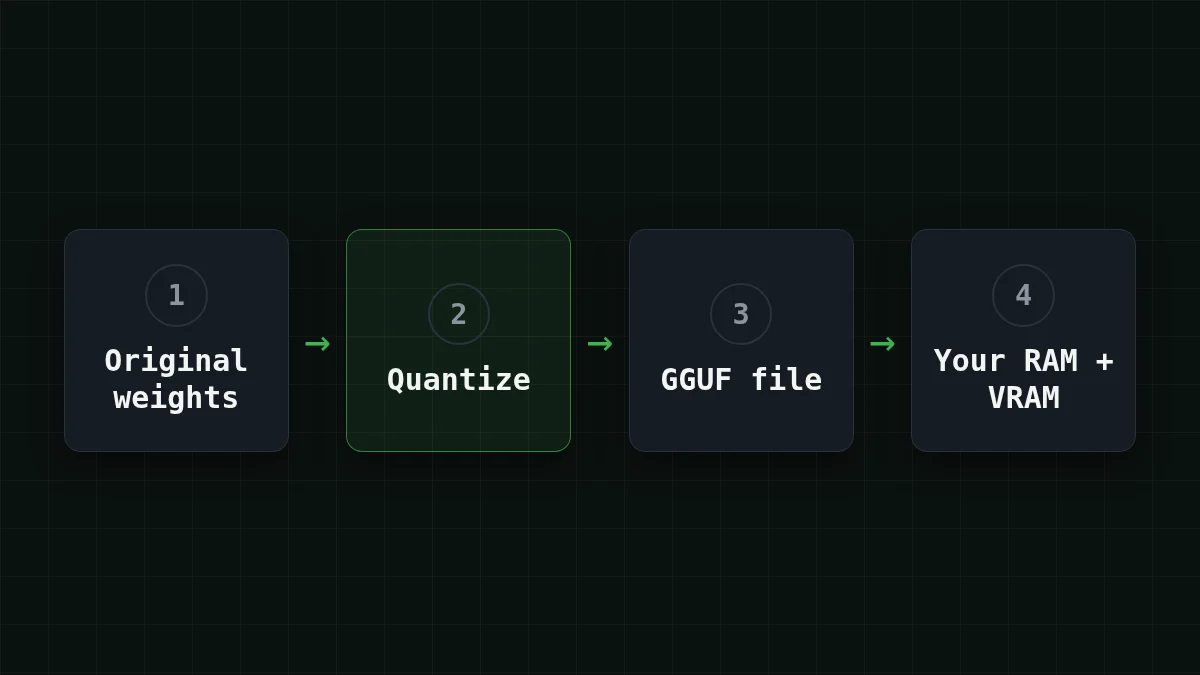
Narito ang lineup ng Unsloth para sa modelo, kasama ang memory (RAM plus VRAM) na kailangan nito sa 16K context para sa isang session. Ang mga sukat ay decimal GB.
I-scroll ang table pakanan →
| Level | Files (size) | Memory needed |
|---|---|---|
| 1-bit | UD-IQ1_M (129.4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249.4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259.1 GB) | ~272 GB |
Pagbasa ng pangalan: ang UD-Q2_K_XL ay isang Unsloth Dynamic build sa tinatayang 2 bits; ang digit ay ang level at ang mga letra ay mga variant. Huwag mag-arithmetic gamit ang digit. Ang 8-bit file ay mga 1.8 beses lamang ng 2-bit (259.1 ÷ 143.9 ≈ 1.8), hindi 4 na beses. Basahin ang sukat sa download page.
Subukan mo mismoSubukan: ang iyong makina ay may 128 GB na memory sa kabuuan. May kasya ba sa mga file na ito?Ipakita ang sagot
Wala. Kahit ang pinakamaliit, UD-IQ1_M, ay nangangailangan ng mga 134 GB ng RAM plus VRAM sa 16K context, kaya kulang ang 128 GB. Ang mga 2-bit file ay nangangailangan ng mga 150–160+ GB.
Ano ang isinusuko mo sa 2 bits#
Ihambing ito sa pag-save ng larawan bilang mas maliit na JPEG: karamihan ng larawan ay nananatili, at ang pinsala ay lumalabas sa pinong detalye. Iniulat ng Unsloth na ang 2-bit file nito (143.9 GB) ay umabot sa 91.5% weighted agreement sa orihinal na modelo sa pitong kategorya: coding, math, chat, tools, multilingual, reasoning at agentic.
Basahin nang mabuti ang numerong iyon. Ito ay sariling sukatan ng Unsloth, at hindi tinukoy ng page ang baseline o ang weighting, kaya ituring itong magaspang na gabay at hindi independiyenteng test. Ang agreement ay hindi rin accuracy: sinasabi nito kung gaano kalapit ang kilos ng maliit na file sa malaki, hindi kung gaano kadalas tama ang alinman. Ang maliliit na pagkakaiba ay maaaring magdagdag sa mahabang chain ng mga hakbang, tulad ng agent na nagpapatakbo ng dalawampung tool call, kaya subukan ang isang quant sa sarili mong gawain bago ka umasa dito. Ang mas matataas na level ay nananatiling mas malapit sa orihinal at mas malaki ang memory na kailangan.
Mag-download o tumawag ng API?#
Sabihin nating gusto mong subukan ang modelo pagkatapos basahin ang anunsyo. Piliin ang linyang mukhang ikaw.
Piliin ang iyong kaso
Alin ang naglalarawan sa iyo?
Pumili ng opsyon upang makita ang sagot
Isang laptop na may 16–32 GB na memory
Sarado ang lokal na ruta: kahit ang 1-bit file ay nangangailangan ng mga 134 GB ng RAM plus VRAM. Tumawag na lang ng modelo sa pamamagitan ng API.
Isang workstation na may mga 192 GB na memory
Kasya ang mga 2-bit file (mga 150–160+ GB ang kailangan) nang may sobrang espasyo. Ang mga 3-bit ay nangangailangan ng 176–208 GB depende sa file, kaya tingnan ang eksaktong figure para sa file na gusto mo bago mag-download. Tingnan muna ang lisensya.
Gusto ko lang subukan ang isang modelo sa pamamagitan ng API
Laktawan ang download. Ang API call ay pay-as-you-go: nagpapadala ka ng text at nakakakuha ng sagot, na walang 130 GB na file sa disk.
Para sa ikatlong linya, sapat na ang isang request para makita kung ano ang pakiramdam. Ang isang ito ay papunta sa DeepSeek-V4-Flash, na may 380K context window at sumasagot ng hanggang 32,768 token ang haba, sa isang presyo sa anumang oras ng araw:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
Bumabalik ang sagot sa choices[0]., at sinasabi ng field na usage kung ilang token ang binayaran mo. Hindi sigurado kung ano ang token? Ang paliwanag sa simpleng Ingles ay tumatagal ng limang minuto. Ang MiniMax-M2.7 ay available sa parehong paraan, na may 180K context window at hanggang 8,192 token bawat sagot. Pareho silang gumagamit ng OpenAI/Anthropic-compatible API, at isang balanse ang sumasaklaw sa bawat modelo.
Ano ang hitsura nito sa bill? Sabihin nating ang isang maliit na support bot ay nagpapadala ng 2,000 request bawat araw, bawat isa ay may 1,500 token na input at 500 na output. Ang isang ganoong request ay nagkakahalaga ng $0.00015 sa MiniMax-M2.7. Narito ang buong araw para sa bawat modelo, katabi ng OpenRouter:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 2,000 mga kahilingan | OpenRouter, 2,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1,500 input at 500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa kabuuan, kasama ang input at output na binibilang nang magkasama, mas mura ang CheapTokens kaysa sa OpenRouter. Ang kasalukuyang presyo para sa bawat modelo ay nasa pricing page.
Kung mayroon ka namang hardware at gusto mong ihambing ang bilis at running costs, dinadaanan ito ng Run DeepSeek locally or use an API. At asahan mong muli ang mga salitang ito sa lalong madaling panahon: ang open weights para sa Kimi K3.1 Pro ay nakatakda sa 4 Nobyembre, gaya ng ipinaliwanag ng aming launch post.


