AI для новичковИнструкция
Open weights и квантизация: что значит 2-бит и 4-бит
Open weights — это когда файлы модели можно скачать. Квантизация их сжимает: что теряет 2-бит и когда проще взять API.
Содержание
Вы открываете анонс модели и видите «open weights» рядом с файлом UD-Q2_K_XL. Коротко: open weights — разработчик выложил файлы модели, и любой может скачать и запустить их у себя. 2-бит — каждое число внутри хранится всего в двух битах: файл становится намного меньше, а модель — чуть размытее. Если скачивать не хочется, модели можно вызывать по API; первый запрос показан в документации CheapTokens.
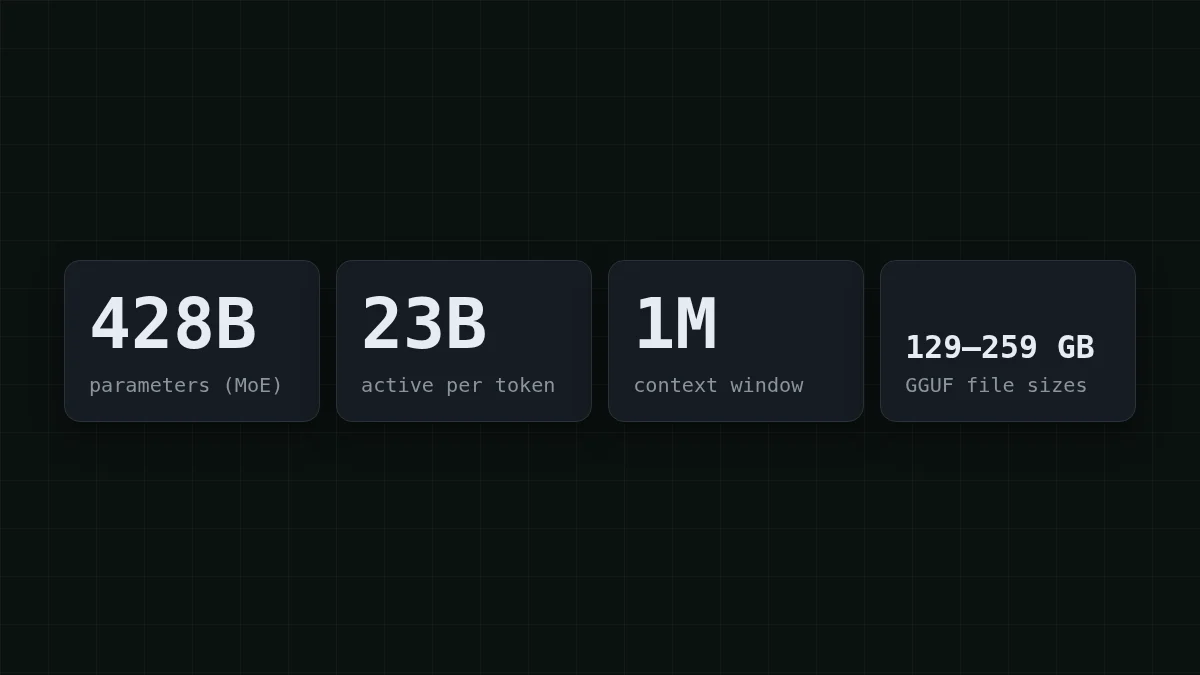
Пример ниже настоящий. На странице Unsloth про MiniMax-M3.1-Flash (даты на ней нет; проверено 27 октября 2026) перечислены GGUF-файлы от 129,4 до 259,1 ГБ — это та модель, о которой мы писали в новости про выход M3.1 Flash. Все размеры и объёмы памяти в статье взяты с этой страницы.
Слова, которые вы встретите в каждом анонсе#
Представьте микшерный пульт с 428 миллиардами ручек. Обучение понемногу двигает каждую, пока звук не станет правильным. Итоговые положения всех ручек — это веса модели. Выложили этот список — получилась open-weight модель; держите у себя на серверах — доступ только через API.
Карточки
Слова из каждого анонса
Нажмите на карточку, чтобы перевернуть её
Две ловушки для новичков. «Open-weight» не значит «можно использовать как угодно»: решает лицензия, а на странице Unsloth её нет — прочитайте карточку модели (MiniMaxAI/ на Hugging Face), прежде чем делать на ней коммерческий продукт. И «скачать бесплатно» не значит «запустить бесплатно» — это видно в следующих разделах.
Почему одна модель — это 130–260 ГБ#
Каждый из 428 миллиардов весов — число, а числа занимают место. Правило: количество × биты ÷ 8 = байты. Прикиньте сами, пока не читали дальше.
Угадайте число
Сколько ГБ занимают 8 миллиардов весов, если каждый хранится в 4 битах?
Ваш вариант
016
Показать ответ
Ответ: 4
4 бита — это полбайта, то есть 8 миллиардов × 0,5 байта = 4 ГБ.
Теперь масштаб. Даже при 2 битах на вес 428 × 2 ÷ 8 = 107 ГБ — нижняя граница для всей модели. Настоящий 2-битный файл — 143,9 ГБ, чуть выше этой границы, поэтому число бит в названии файла — это метка, а не точный счёт.
«23B активных» — про скорость, а не про место на диске. На каждый токен работает лишь часть модели, поэтому она быстрая, но эта часть меняется от токена к токену, и в памяти должны лежать все 428B весов.
Что на самом деле делают 2-бит и 4-бит#
Представьте линейку. Биты решают, сколько на ней делений: 2 бита — 4 деления, 4 бита — 16, 8 бит — 256, а привычные 16 бит — 65 536. Квантизация округляет каждый вес до ближайшего деления. Меньше делений — меньше файл и больше ошибка округления у каждого числа.
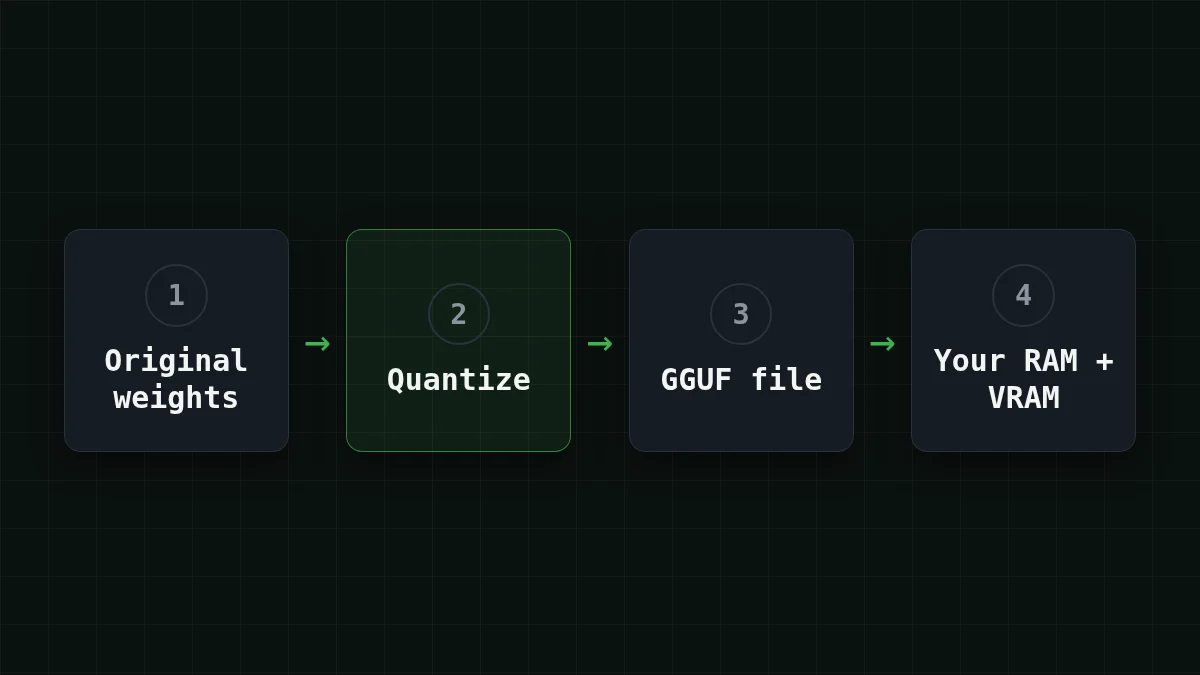
Вот набор Unsloth для этой модели и память (RAM плюс VRAM), которая нужна при контексте 16K для одной сессии. Размеры в десятичных ГБ.
Прокрутите таблицу вправо →
| Уровень | Файлы (размер) | Нужно памяти |
|---|---|---|
| 1-бит | UD-IQ1_M (129,4 ГБ) | ~134 ГБ |
| 2-бит | UD-IQ2_XXS (134,9 ГБ), UD-Q2_K_XL (143,9 ГБ) | ~150–160+ ГБ |
| 3-бит | UD-IQ3_XXS (160,0 ГБ), UD-IQ3_S (175,5 ГБ), UD-Q3_K_XL (194,0 ГБ) | 176–208 ГБ |
| 4-бит | UD-Q4_K_XL (249,4 ГБ) | ~256 ГБ |
| 8-бит | UD-Q8_K_XL (259,1 ГБ) | ~272 ГБ |
Как читать имя: UD-Q2_K_XL — сборка Unsloth Dynamic примерно на 2 бита; цифра — уровень, буквы — варианты. Считать по этой цифре не надо. 8-битный файл всего примерно в 1,8 раза больше 2-битного (259,1 ÷ 143,9 ≈ 1,8), а не в 4. Размер смотрите на странице загрузки.
Попробуйте самиПопробуйте: у вашей машины всего 128 ГБ памяти. Влезет ли хоть один файл?Показать ответ
Нет. Даже самому маленькому, UD-IQ1_M, нужно около 134 ГБ RAM плюс VRAM при контексте 16K, так что 128 ГБ не хватает. Для 2-битных файлов нужно около 150–160+ ГБ.
Что вы теряете на 2 битах#
Это как сохранить фото в JPEG поменьше: картинка в целом на месте, а потери видны в мелких деталях. Unsloth сообщает, что его 2-битный файл (143,9 ГБ) показывает 91,5% взвешенного согласия с исходной моделью по семи категориям: код, математика, чат, инструменты, многоязычность, рассуждения и агентные задачи.
Читайте эту цифру аккуратно. Это собственная метрика Unsloth, а база сравнения и веса категорий на странице не раскрыты — считайте её грубым ориентиром, а не независимым тестом. И согласие — это не точность: оно показывает, насколько маленький файл ведёт себя как большой, а не как часто правы оба. Мелкие расхождения могут накапливаться в длинной цепочке шагов — например, когда агент делает двадцать вызовов инструментов, — поэтому проверьте квант на своей задаче, прежде чем на него полагаться. Уровни повыше ближе к оригиналу и требуют больше памяти.
Скачивать или вызывать по API?#
Допустим, после анонса вы хотите попробовать модель. Выберите строку, которая про вас.
Выберите свой случай
Что про вас?
Выберите вариант, чтобы увидеть ответ
Ноутбук с 16–32 ГБ памяти
Локальный путь закрыт: даже 1-битному файлу нужно около 134 ГБ RAM плюс VRAM. Вызывайте модель по API.
Рабочая станция примерно со 192 ГБ памяти
2-битные файлы (нужно около 150–160+ ГБ) влезут с запасом. 3-битным нужно 176–208 ГБ в зависимости от файла, так что точную цифру для нужного файла проверьте до скачивания. Сначала проверьте лицензию.
Просто хочу попробовать модель через API
Пропустите скачивание. Вызов API оплачивается по факту: вы отправляете текст и получаете ответ, а 130-гигабайтного файла на диске нет.
Для третьего варианта хватит одного запроса. Этот уходит в DeepSeek-V4-Flash: контекст 380K, ответ до 32 768 токенов и одна цена в любое время суток:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
Ответ придёт в choices[0]., а поле usage покажет, за сколько токенов вы заплатили. Не уверены, что такое токен? В простом объяснении всё уместилось в пять минут. Так же доступна MiniMax-M2.7: контекст 180K и до 8 192 токенов в ответе. У обеих API совместим с OpenAI и Anthropic, а баланс один на все модели.
Как это выглядит в счёте? Допустим, небольшой бот поддержки отправляет 2 000 запросов в день: 1 500 токенов на входе и 500 на выходе. Один такой запрос на MiniMax-M2.7 стоит $0.00015. Вот весь день по каждой модели рядом с OpenRouter:
| Модель | Вход $/1M | Выход $/1M | За запрос | 2 000 запросов | OpenRouter, 2 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1 500 входных и 500 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В сумме, с учётом входа и выхода, CheapTokens выходит дешевле OpenRouter. Актуальные цены всех моделей — на странице цен.
Если железо есть и хочется сравнить скорость и расходы на запуск, подробнее в разборе: запускать DeepSeek локально или брать API. А эти слова скоро встретятся снова: открытые веса Kimi K3.1 Pro ожидаются 4 ноября, как рассказано в новости о выходе модели.


