KI für EinsteigerAnleitung
Was sind offene Gewichte? 2-Bit- und 4-Bit-Quantisierung erklärt
Offene Gewichte bedeuten, dass du die Modelldateien herunterladen kannst. Quantisierung verkleinert sie: Sieh, was 2-Bit an Genauigkeit kostet und wann eine API einfacher ist.
Auf dieser Seite
Du öffnest eine Modellankündigung und siehst „offene Gewichte“ neben einer Datei namens UD-Q2_K_XL. Kurze Antwort: Offene Gewichte bedeutet, dass der Entwickler die Dateien des Modells veröffentlicht hat, sodass jeder sie herunterladen und ausführen kann. 2-Bit bedeutet, dass jede Zahl im Inneren mit nur zwei Bits gespeichert wird: Die Datei wird deutlich kleiner und das Modell etwas unschärfer. Wenn du den Download lieber überspringen möchtest, kannst du Modelle stattdessen über eine API aufrufen; die CheapTokens-Dokumentation zeigt die erste Anfrage.
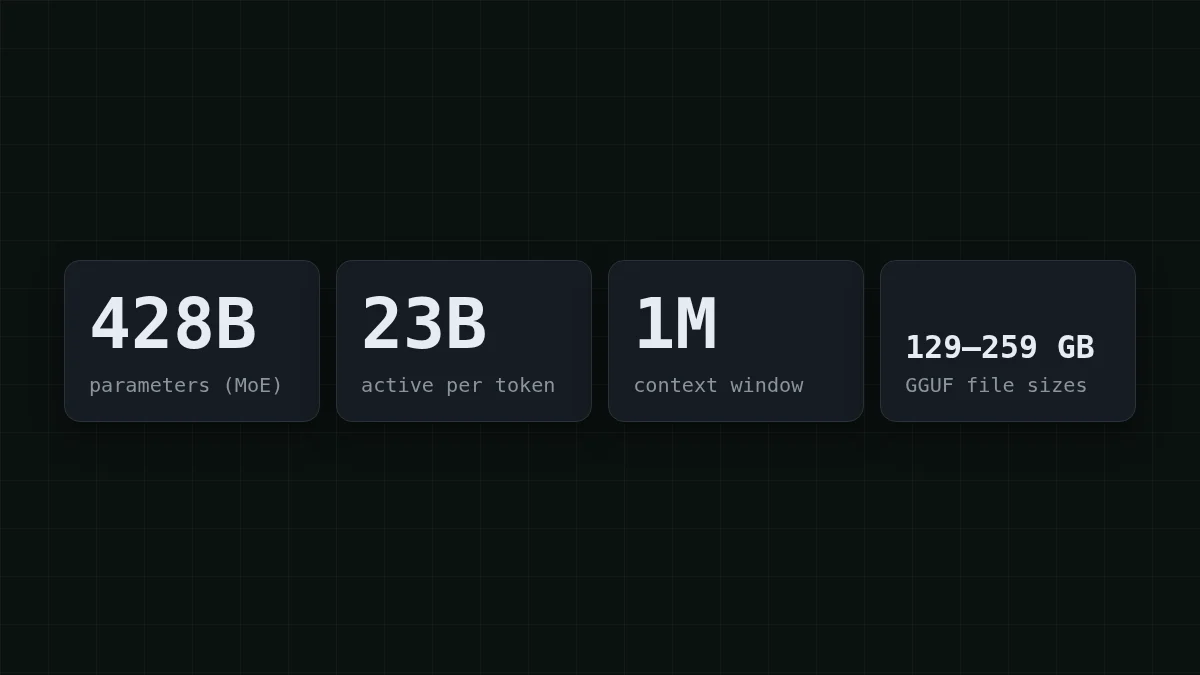
Das folgende Beispiel ist echt. Unsloths Modellseite für MiniMax-M3.1-Flash (undatiert; geprüft am 27. Oktober 2026) listet GGUF-Dateien von 129,4 GB bis 259,1 GB für ein Modell, das wir im M3.1-Flash-Launch-Post behandelt haben. Jede Größen- und Speicherangabe hier stammt von dieser Seite.
Die Begriffe, die dir ständig begegnen#
Stell dir ein Mischpult mit 428 Milliarden Reglern vor. Das Training dreht an jedem Regler, bis die Ausgabe richtig klingt. Die endgültige Position aller Regler sind die Gewichte des Modells. Veröffentliche diese Liste, und du hast ein Modell mit offenen Gewichten; behalte sie auf deinen eigenen Servern, und der einzige Zugang ist eine API.
Lernkarten
Begriffe, die dir in jeder Ankündigung begegnen
Tippe auf eine Karte, um sie umzudrehen
Zwei Fallen für Einsteiger. „Open-Weight“ ist nicht automatisch „frei für jede Nutzung“: Das entscheidet die Lizenz, und Unsloths Seite nennt sie nicht, also lies die Modellkarte (MiniMaxAI/ auf Hugging Face), bevor du etwas Kommerzielles baust. Und „kostenlos herunterladbar“ ist nicht „kostenlos ausführbar“, was die nächsten Abschnitte zeigen.
Warum ein Modell ein Download von 130–260 GB ist#
Jedes dieser 428 Milliarden Gewichte ist eine Zahl, und Zahlen brauchen Platz. Die Faustregel lautet Anzahl × Bits ÷ 8 = Bytes. Probier es aus, bevor du weiterliest.
Zahl erraten
Wie viele GB brauchen 8 Milliarden Gewichte, wenn jedes mit 4 Bits gespeichert wird?
Deine Schätzung
016
Antwort anzeigen
Antwort: 4
4 Bits sind ein halbes Byte, also 8 Milliarden × 0,5 Byte = 4 GB.
Jetzt skaliere hoch. Selbst bei 2 Bits pro Gewicht ist 428 × 2 ÷ 8 = 107 GB die Untergrenze für das gesamte Modell. Die echte 2-Bit-Datei ist 143,9 GB, etwas über der Untergrenze, also ist die Bit-Zahl in einem Dateinamen eher ein Etikett als eine exakte Angabe.
Die Angabe „23B aktiv“ betrifft die Geschwindigkeit, nicht den Speicher. Nur ein Teil des Modells arbeitet an jedem Token, was es schnell macht, aber der Teil wechselt von Token zu Token, also müssen alle 428B Gewichte geladen und bereit sein.
Was 2-Bit und 4-Bit tatsächlich tun#
Denk an ein Lineal. Bits entscheiden, wie viele Markierungen es hat: 2 Bits ergeben 4 Markierungen, 4 Bits ergeben 16, 8 Bits ergeben 256, und die üblichen 16 Bits ergeben 65.536. Die Quantisierung rundet jedes Gewicht auf die nächste Markierung. Weniger Markierungen bedeuten eine kleinere Datei und einen größeren Rundungsfehler bei jeder Zahl.
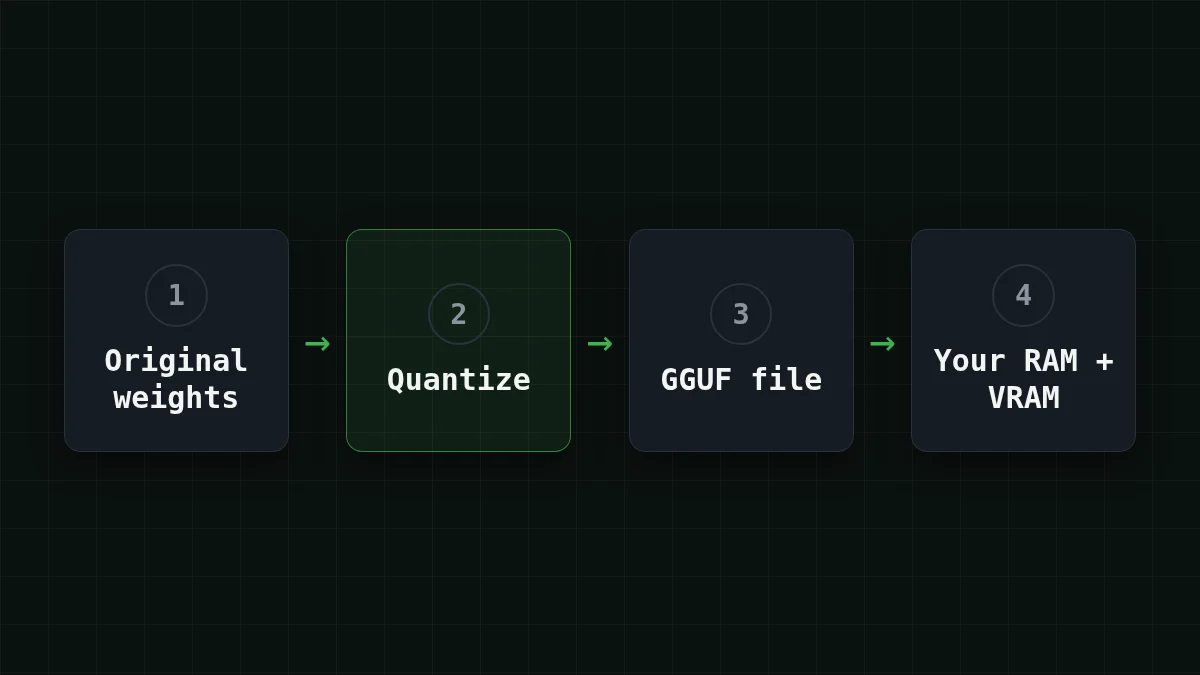
Hier ist Unsloths Aufstellung für das Modell, mit dem Speicher (RAM plus VRAM), den es bei 16K Kontext für eine Sitzung braucht. Größen sind dezimale GB.
Tabelle nach rechts scrollen →
| Stufe | Dateien (Größe) | Benötigter Speicher |
|---|---|---|
| 1-Bit | UD-IQ1_M (129,4 GB) | ~134 GB |
| 2-Bit | UD-IQ2_XXS (134,9 GB), UD-Q2_K_XL (143,9 GB) | ~150–160+ GB |
| 3-Bit | UD-IQ3_XXS (160,0 GB), UD-IQ3_S (175,5 GB), UD-Q3_K_XL (194,0 GB) | 176–208 GB |
| 4-Bit | UD-Q4_K_XL (249,4 GB) | ~256 GB |
| 8-Bit | UD-Q8_K_XL (259,1 GB) | ~272 GB |
Einen Namen lesen: UD-Q2_K_XL ist ein Unsloth-Dynamic-Build mit ungefähr 2 Bits; die Ziffer ist die Stufe und die Buchstaben sind Varianten. Rechne nicht mit der Ziffer. Die 8-Bit-Datei ist nur etwa 1,8-mal so groß wie die 2-Bit-Datei (259,1 ÷ 143,9 ≈ 1,8), nicht 4-mal. Lies die Größe auf der Download-Seite ab.
Probier es selbstProbier es aus: Dein Rechner hat insgesamt 128 GB Speicher. Passt eine dieser Dateien?Antwort anzeigen
Nein. Selbst die kleinste, UD-IQ1_M, braucht bei 16K Kontext etwa 134 GB RAM plus VRAM, also reichen 128 GB nicht. Die 2-Bit-Dateien brauchen etwa 150–160+ GB.
Was du bei 2 Bits aufgibst#
Vergleiche es mit dem Speichern eines Fotos als kleineres JPEG: Der Großteil des Bildes bleibt erhalten, und der Schaden zeigt sich im Feindetail. Unsloth berichtet, dass seine 2-Bit-Datei (143,9 GB) eine gewichtete Übereinstimmung von 91,5 % mit dem Originalmodell über sieben Kategorien erreicht: Coding, Mathe, Chat, Tools, Mehrsprachigkeit, Reasoning und Agentic.
Lies diese Zahl sorgfältig. Es ist Unsloths eigene Messung, und die Seite legt weder die Baseline noch die Gewichtung offen, also behandle sie als grobe Orientierung und nicht als unabhängigen Test. Übereinstimmung ist auch nicht Genauigkeit: Sie sagt, wie ähnlich sich die kleine Datei im Verhalten zur großen verhält, nicht wie oft eine von beiden richtig liegt. Kleine Unterschiede können sich über eine lange Kette von Schritten summieren, etwa bei einem Agenten, der zwanzig Tool-Aufrufe ausführt, also probiere eine Quantisierung an deiner eigenen Aufgabe aus, bevor du dich darauf verlässt. Höhere Stufen bleiben näher am Original und kosten mehr Speicher.
Herunterladen oder eine API aufrufen?#
Angenommen, du willst das Modell nach dem Lesen der Ankündigung ausprobieren. Wähle die Zeile, die zu dir passt.
Wähle deinen Fall
Welche Beschreibung passt zu dir?
Wähle eine Option, um die Antwort zu sehen
Ein Laptop mit 16–32 GB Speicher
Der lokale Weg ist versperrt: Selbst die 1-Bit-Datei braucht etwa 134 GB RAM plus VRAM. Rufe stattdessen ein Modell über eine API auf.
Eine Workstation mit etwa 192 GB Speicher
Die 2-Bit-Dateien (etwa 150–160+ GB benötigt) passen mit Reserve. Die 3-Bit-Dateien brauchen je nach Datei 176–208 GB, also prüfe die genaue Angabe für die gewünschte Datei, bevor du herunterlädst. Prüfe zuerst die Lizenz.
Ich möchte ein Modell einfach über eine API ausprobieren
Überspringe den Download. Ein API-Aufruf ist Pay-as-you-go: Du sendest Text und bekommst eine Antwort, ohne eine 130-GB-Datei auf der Festplatte.
Für die dritte Zeile reicht eine Anfrage, um ein Gefühl dafür zu bekommen. Diese hier geht an DeepSeek-V4-Flash, das ein Kontextfenster von 380K hat und Antworten bis zu 32.768 Token lang liefert, zu einem Preis zu jeder Tageszeit:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
Die Antwort kommt in choices[0]. zurück, und das Feld usage sagt dir, für wie viele Token du bezahlt hast. Du weißt nicht, was ein Token ist? Die Erklärung in einfacher Sprache dauert fünf Minuten. MiniMax-M2.7 ist auf dieselbe Weise verfügbar, mit einem Kontextfenster von 180K und bis zu 8.192 Token pro Antwort. Beide nutzen eine OpenAI/Anthropic-kompatible API, und ein Guthaben deckt jedes Modell ab.
Wie sieht das auf einer Rechnung aus? Angenommen, ein kleiner Support-Bot sendet 2.000 Anfragen pro Tag, jede mit 1.500 Token Eingabe und 500 Ausgabe. Eine solche Anfrage kostet $0.00015 bei MiniMax-M2.7. Hier ist der ganze Tag für jedes Modell, neben OpenRouter:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 2.000 Anfragen | OpenRouter, 2.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1.500 Input- und 500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Insgesamt, mit Eingabe und Ausgabe zusammengerechnet, ist CheapTokens günstiger als OpenRouter. Aktuelle Preise für jedes Modell stehen auf der Preisseite.
Wenn du die Hardware hast und Geschwindigkeit sowie Betriebskosten vergleichen willst, geht DeepSeek lokal ausführen oder eine API nutzen darauf ein. Und erwarte diese Wörter bald wieder: Die offenen Gewichte für Kimi K3.1 Pro sind für den 4. November angekündigt, wie unser Launch-Post erklärt.


