ओपन वेट क्या हैं? 2-bit और 4-bit क्वांटाइज़ेशन समझाया गया
ओपन वेट का मतलब है कि आप मॉडल फ़ाइलें डाउनलोड कर सकते हैं। क्वांटाइज़ेशन उन्हें छोटा करता है: देखें कि 2-bit निष्ठा में क्या कीमत लेता है और API कब सरल है।
इस पृष्ठ पर
आप एक मॉडल की घोषणा खोलते हैं और UD-Q2_K_XL नाम की फ़ाइल के बगल में “open weights” देखते हैं। संक्षिप्त उत्तर: open weights का मतलब है कि डेवलपर ने मॉडल की फ़ाइलें प्रकाशित की हैं, इसलिए कोई भी उन्हें डाउनलोड और चला सकता है। 2-bit का मतलब है कि अंदर की हर संख्या केवल दो बिट्स में संग्रहीत है: फ़ाइल बहुत छोटी हो जाती है और मॉडल थोड़ा धुंधला हो जाता है। यदि आप डाउनलोड छोड़ना चाहते हैं, तो आप API के माध्यम से मॉडल कॉल कर सकते हैं; CheapTokens दस्तावेज़ पहला अनुरोध दिखाते हैं।
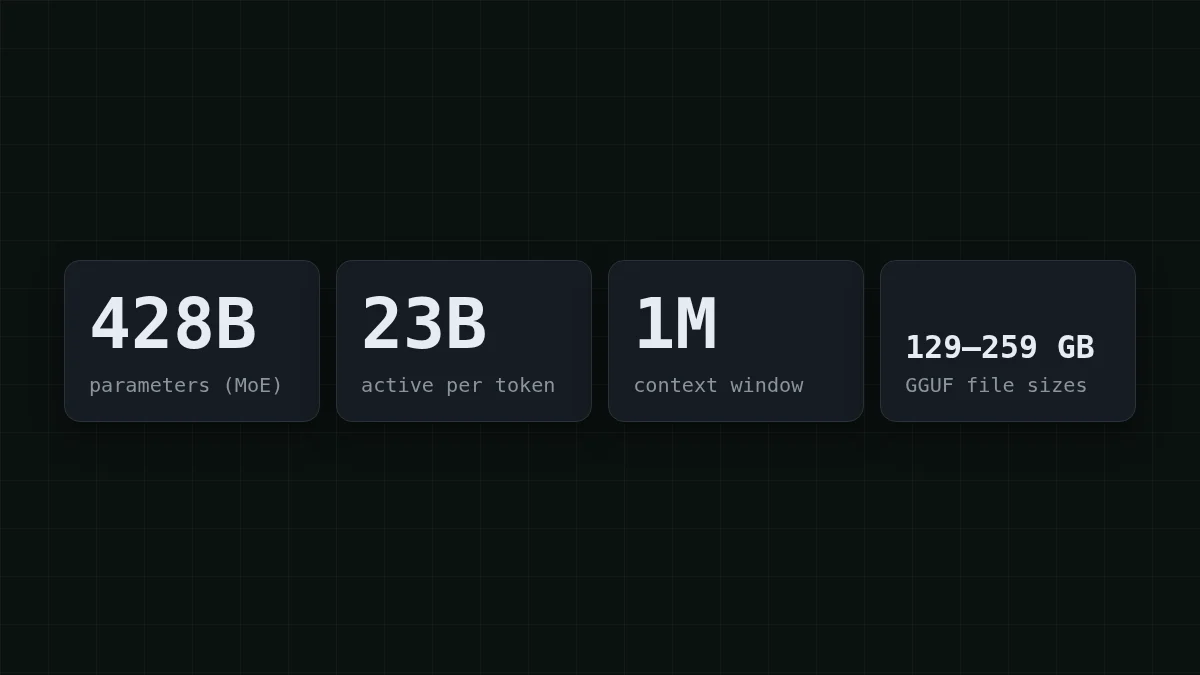
नीचे दिया गया उदाहरण वास्तविक है। MiniMax-M3.1-Flash के लिए Unsloth का मॉडल पेज (बिना तारीख; 27 अक्टूबर 2026 को जाँचा गया) उस मॉडल के लिए 129.4 GB से 259.1 GB तक की GGUF फ़ाइलें सूचीबद्ध करता है जिसे हमने M3.1 Flash लॉन्च पोस्ट में कवर किया था। यहाँ दिया गया प्रत्येक आकार और मेमोरी आंकड़ा उसी पेज से है।
वे शब्द जो आप बार-बार सुनते हैं#
428 अरब डायल वाले मिक्सिंग डेस्क की कल्पना करें। प्रशिक्षण हर डायल को तब तक समायोजित करता है जब तक आउटपुट सही न सुनाई दे। सभी डायल की अंतिम स्थिति मॉडल के weights हैं। उस सूची को प्रकाशित करें और आपके पास एक ओपन-वेट मॉडल है; इसे अपने सर्वर पर रखें और प्रवेश का एकमात्र तरीका API है।
फ्लैशकार्ड
हर घोषणा में मिलने वाले शब्द
पलटने के लिए कार्ड पर टैप करें
शुरुआती लोगों के लिए दो जाल। “Open-weight” स्वचालित रूप से “किसी भी उपयोग के लिए मुफ़्त” नहीं है: लाइसेंस तय करता है, और Unsloth का पेज इसे नहीं बताता, इसलिए कुछ भी व्यावसायिक बनाने से पहले मॉडल कार्ड (Hugging Face पर MiniMaxAI/) पढ़ें। और “डाउनलोड करने के लिए मुफ़्त” “चलाने के लिए मुफ़्त” नहीं है, जो अगले अनुभाग दिखाते हैं।
एक मॉडल 130–260 GB डाउनलोड क्यों है#
उन 428 अरब वेट में से प्रत्येक एक संख्या है, और संख्याएँ जगह लेती हैं। अनुमानित नियम है गणना × बिट्स ÷ 8 = बाइट्स। आगे पढ़ने से पहले इसे आज़माएँ।
संख्या का अनुमान लगाएँ
8 अरब वेट कितने GB लेंगे जब प्रत्येक 4 बिट्स में संग्रहीत हो?
आपका अनुमान
016
उत्तर दिखाएँ
उत्तर: 4
4 बिट्स आधा बाइट है, इसलिए 8 अरब × 0.5 बाइट = 4 GB।
अब बड़ा करें। प्रति वेट 2 बिट्स पर भी, 428 × 2 ÷ 8 = 107 GB पूरे मॉडल के लिए न्यूनतम है। वास्तविक 2-बिट फ़ाइल 143.9 GB है, न्यूनतम से थोड़ा अधिक, इसलिए फ़ाइल नाम में बिट संख्या एक लेबल है न कि सटीक गणना।
“23B सक्रिय” आंकड़ा गति के बारे में है, संग्रहण के बारे में नहीं। प्रत्येक टोकन पर मॉडल का केवल एक टुकड़ा काम करता है, जो इसे तेज़ बनाता है, लेकिन टुकड़ा टोकन-दर-टोकन बदलता है, इसलिए सभी 428B वेट लोड होकर प्रतीक्षा में रहने चाहिए।
2-bit और 4-bit वास्तव में क्या करते हैं#
एक रूलर की कल्पना करें। बिट्स तय करते हैं कि उस पर कितने निशान हैं: 2 बिट्स 4 निशान देते हैं, 4 बिट्स 16, 8 बिट्स 256, और सामान्य 16 बिट्स 65,536। क्वांटाइज़ेशन प्रत्येक वेट को निकटतम निशान पर गोल करता है। कम निशान का मतलब छोटी फ़ाइल और प्रत्येक संख्या पर बड़ी राउंडिंग त्रुटि।
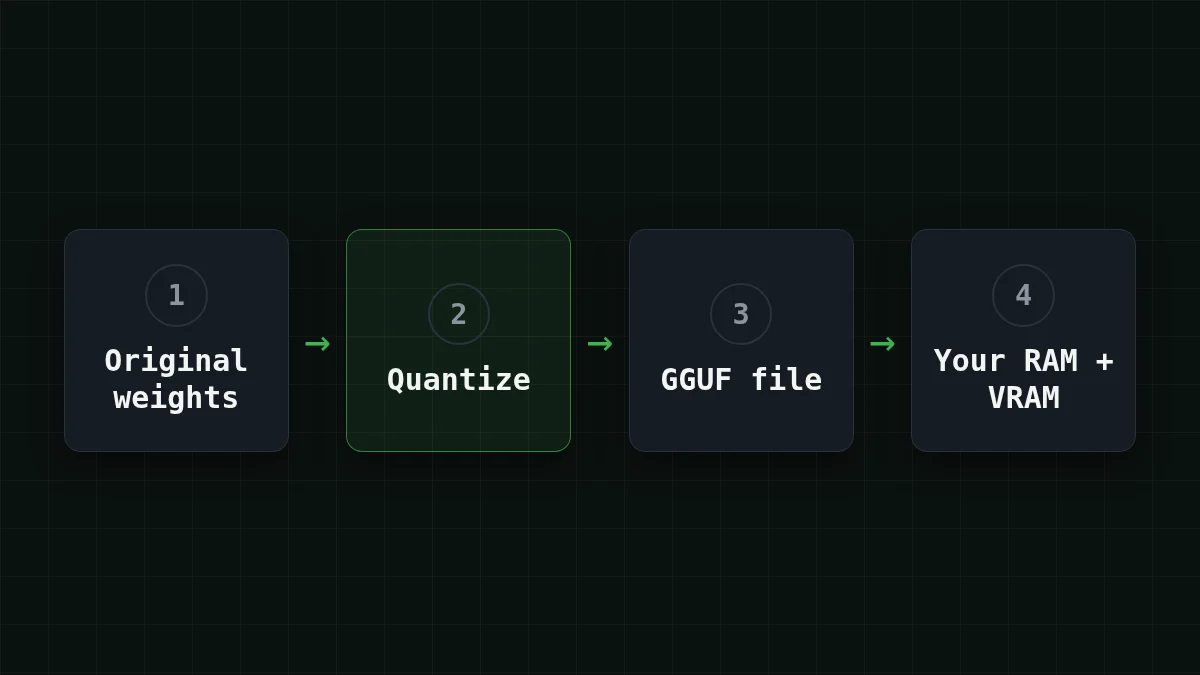
यहाँ मॉडल के लिए Unsloth की लाइनअप है, जिसमें एक सत्र के लिए 16K संदर्भ पर आवश्यक मेमोरी (RAM प्लस VRAM) दी गई है। आकार दशमलव GB में हैं।
तालिका को दाईं ओर स्क्रॉल करें →
| स्तर | फ़ाइलें (आकार) | आवश्यक मेमोरी |
|---|---|---|
| 1-bit | UD-IQ1_M (129.4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249.4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259.1 GB) | ~272 GB |
नाम पढ़ना: UD-Q2_K_XL लगभग 2 बिट्स पर एक Unsloth Dynamic बिल्ड है; अंक स्तर है और अक्षर वेरिएंट हैं। अंक से अंकगणित न करें। 8-बिट फ़ाइल 2-बिट वाली की केवल लगभग 1.8 गुना है (259.1 ÷ 143.9 ≈ 1.8), 4 गुना नहीं। डाउनलोड पेज से आकार पढ़ें।
स्वयं आज़माएँआज़माएँ: आपकी मशीन में कुल 128 GB मेमोरी है। क्या इनमें से कोई फ़ाइल फिट होती है?उत्तर दिखाएँ
नहीं। सबसे छोटी, UD-IQ1_M, को 16K संदर्भ पर लगभग 134 GB RAM प्लस VRAM चाहिए, इसलिए 128 GB कम है। 2-बिट फ़ाइलों को लगभग 150–160+ GB चाहिए।
2 बिट्स पर आप क्या छोड़ते हैं#
इसकी तुलना फ़ोटो को छोटे JPEG के रूप में सहेजने से करें: अधिकांश चित्र बचा रहता है, और क्षति बारीक विवरण में दिखती है। Unsloth बताता है कि इसकी 2-बिट फ़ाइल (143.9 GB) सात श्रेणियों—कोडिंग, गणित, चैट, टूल्स, बहुभाषी, तर्क और एजेंटिक—में मूल मॉडल के साथ 91.5% भारित सहमति तक पहुँचती है।
उस संख्या को ध्यान से पढ़ें। यह Unsloth का अपना माप है, और पेज आधार रेखा या भारांकन नहीं बताता, इसलिए इसे मोटे मार्गदर्शन के रूप में लें, स्वतंत्र परीक्षण के रूप में नहीं। सहमति सटीकता भी नहीं है: यह बताती है कि छोटी फ़ाइल बड़ी की तरह कितनी निकट व्यवहार करती है, न कि दोनों में से कोई कितनी बार सही है। छोटे अंतर लंबे चरणों की श्रृंखला में जुड़ सकते हैं, जैसे बीस टूल कॉल चलाने वाला एजेंट, इसलिए किसी क्वांट पर भरोसा करने से पहले उसे अपने कार्य पर आज़माएँ। उच्च स्तर मूल के अधिक निकट रहते हैं और अधिक मेमोरी लेते हैं।
डाउनलोड करें या API कॉल करें?#
मान लें कि घोषणा पढ़ने के बाद आप मॉडल आज़माना चाहते हैं। वह पंक्ति चुनें जो आपके जैसी लगे।
अपना मामला चुनें
आपका वर्णन कौन करता है?
उत्तर देखने के लिए एक विकल्प चुनें
16–32 GB मेमोरी वाला लैपटॉप
स्थानीय मार्ग बंद है: 1-बिट फ़ाइल को भी लगभग 134 GB RAM प्लस VRAM चाहिए। इसके बजाय API के माध्यम से मॉडल कॉल करें।
लगभग 192 GB मेमोरी वाला वर्कस्टेशन
2-बिट फ़ाइलें (लगभग 150–160+ GB आवश्यक) अतिरिक्त जगह के साथ फिट होती हैं। 3-बिट वालों को फ़ाइल के आधार पर 176–208 GB चाहिए, इसलिए डाउनलोड करने से पहले अपनी इच्छित फ़ाइल का सटीक आंकड़ा जाँचें। पहले लाइसेंस जाँचें।
मैं बस API के माध्यम से मॉडल आज़माना चाहता हूँ
डाउनलोड छोड़ें। API कॉल पे-एज़-यू-गो है: आप टेक्स्ट भेजते हैं और उत्तर पाते हैं, डिस्क पर 130 GB फ़ाइल के बिना।
तीसरी पंक्ति के लिए, यह देखने के लिए एक अनुरोध पर्याप्त है कि यह कैसा लगता है। यह वाला DeepSeek-V4-Flash पर जाता है, जिसकी 380K संदर्भ विंडो है और दिन के किसी भी समय एक ही कीमत पर 32,768 टोकन लंबे उत्तर देता है:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
उत्तर choices[0]. में वापस आता है, और usage फ़ील्ड बताता है कि आपने कितने टोकन के लिए भुगतान किया। टोकन क्या है पता नहीं? सरल अंग्रेज़ी व्याख्या पाँच मिनट लेती है। MiniMax-M2.7 इसी तरह उपलब्ध है, 180K संदर्भ विंडो और प्रति उत्तर 8,192 टोकन तक। दोनों OpenAI/Anthropic-संगत API का उपयोग करते हैं, और एक बैलेंस हर मॉडल को कवर करता है।
यह बिल पर कैसा दिखता है? मान लें एक छोटा सहायता बॉट प्रतिदिन 2,000 अनुरोध भेजता है, प्रत्येक में 1,500 टोकन इन और 500 आउट। MiniMax-M2.7 पर ऐसे एक अनुरोध की लागत $0.00015 है। यहाँ प्रत्येक मॉडल के लिए पूरा दिन है, OpenRouter के बगल में:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 2,000 अनुरोध | OpenRouter, 2,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
प्रति अनुरोध 1,500 इनपुट और 500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, CheapTokens OpenRouter से सस्ता निकलता है। हर मॉडल के वर्तमान मूल्य मूल्य पृष्ठ पर हैं।
यदि आपके पास हार्डवेयर है और गति और चलाने की लागत की तुलना करना चाहते हैं, तो DeepSeek को स्थानीय रूप से चलाएँ या API का उपयोग करें इसे समझाता है। और जल्द ही ये शब्द फिर सुनने को मिलेंगे: Kimi K3.1 Pro के ओपन वेट 4 नवंबर को आने वाले हैं, जैसा कि हमारी लॉन्च पोस्ट बताती है।


