AI में टोकन क्या है? एक सरल-अंग्रेजी व्याख्या
टोकन टेक्स्ट का वह टुकड़ा है जिसे एक AI मॉडल पढ़ता और लिखता है। देखें कि एक वास्तविक टोकनाइज़र एक वाक्य को कैसे विभाजित करता है, एक शब्द में कितने टोकन लगते हैं और टोकन बिल कैसे बनते हैं।
इस पृष्ठ पर
टोकन टेक्स्ट का एक छोटा टुकड़ा है जिसके साथ एक भाषा मॉडल काम करता है: एक पूरा शब्द, किसी शब्द का हिस्सा, एक विराम चिह्न, या उसके आगे के स्थान के साथ एक शब्द। मॉडल आपके प्रॉम्प्ट को टोकन के रूप में पढ़ते हैं, उत्तर को टोकन के रूप में लिखते हैं, और AI API टोकन के आधार पर बिल करते हैं। इसलिए "यह कितने टोकन है" वास्तव में दो प्रश्न हैं: क्या यह फिट होगा, और इसकी लागत क्या होगी।
एक मॉडल टेक्स्ट को टोकन में कैसे काटता है#
इससे पहले कि कोई मॉडल आपके टेक्स्ट को देखे, एक टोकनाइज़र इसे एक निश्चित शब्दावली से टुकड़ों में विभाजित करता है और प्रत्येक टुकड़े को एक संख्या में बदल देता है। बार-बार आने वाले शब्दों को आमतौर पर एक ही टोकन मिलता है। दुर्लभ और लंबे शब्दों को भागों में विभाजित किया जाता है।
यहाँ एक वास्तविक उदाहरण है। हमने एक वाक्य को दो टोकनाइज़रों के माध्यम से चलाया: DeepSeek-V4-Flash-0731 के साथ प्रकाशित एक, और OpenAI का o200k_base एन्कोडिंग।
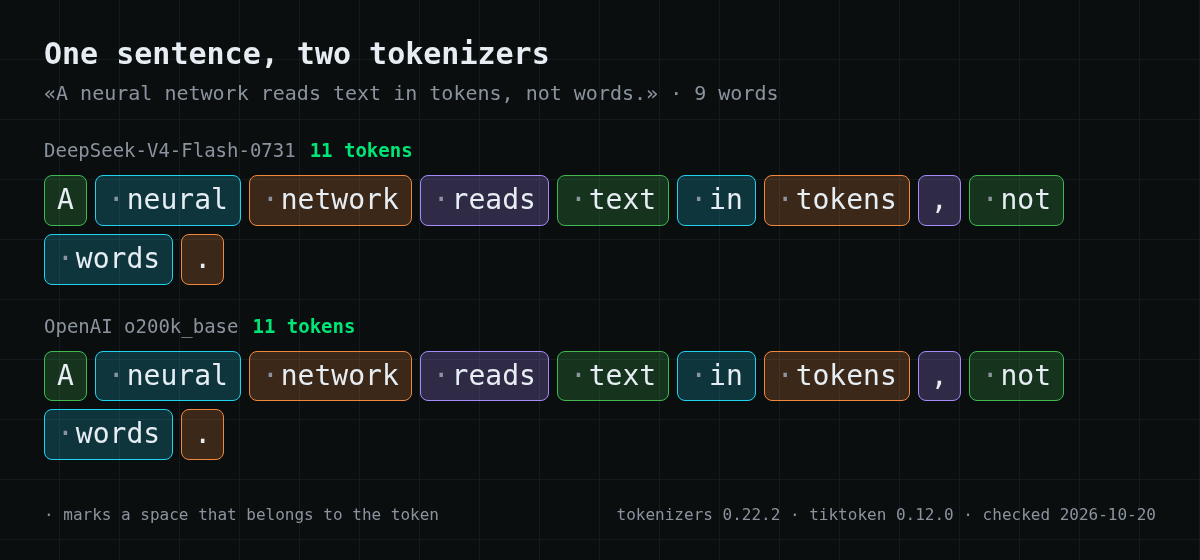
अंग्रेजी में दोनों टोकनाइज़र सहमत हैं: 9 शब्द, 11 टोकन। अल्पविराम और पूर्ण विराम अपने स्वयं के टोकन हैं, और अधिकांश शब्दों में उनके आगे का स्थान शामिल होता है।
लंबे शब्दों में टोकनाइज़र अलग होने लगते हैं। "tokenization" दोनों में दो टोकन है: token + ization। रूसी शब्द «токенизация» DeepSeek के लिए तीन टोकन और OpenAI के लिए चार है। एक ही शब्द, अलग गिनती।
एक शब्द में कितने टोकन होते हैं#
टोकन के बारे में एक छोटे पैराग्राफ के साथ एक त्वरित परीक्षण, अंग्रेजी और रूसी में:
तालिका को दाईं ओर स्क्रॉल करें →
| टेक्स्ट | शब्द | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| अंग्रेजी पैराग्राफ, 254 अक्षर | 53 | 60 टोकन | 60 टोकन |
| वही पैराग्राफ रूसी में, 255 अक्षर | 42 | 73 टोकन | 65 टोकन |
अंग्रेजी टेक्स्ट के लिए, प्रति शब्द लगभग 1.1–1.2 टोकन एक उचित अनुमान है। अन्य लिपियों में आमतौर पर अधिक खर्च होता है: रूसी संस्करण कम शब्दों में वही बात कहता है लेकिन DeepSeek के टोकनाइज़र के साथ लगभग 20% अधिक टोकन लेता है।
इन्हें अंगूठे के नियमों के रूप में लें। प्रत्येक मॉडल परिवार का अपना टोकनाइज़र होता है, और आपके टेक्स्ट की सटीक गिनती वही है जो API वापस रिपोर्ट करता है।
टोकन ही वह चीज़ है जिसके लिए आप भुगतान करते हैं#
API की कीमतें प्रति मिलियन टोकन के हिसाब से बताई जाती हैं, इनपुट और आउटपुट के लिए अलग-अलग:
- इनपुट टोकन — आप जो कुछ भी भेजते हैं: सिस्टम प्रॉम्प्ट, चैट इतिहास, दस्तावेज़ और आपका प्रश्न;
- आउटपुट टोकन — मॉडल जो कुछ भी वापस लिखता है, उसमें उसका तर्क भी शामिल है यदि मॉडल उत्तर देने से पहले तर्क करता है।
एक अनुरोध की लागत = इनपुट टोकन × इनपुट मूल्य + आउटपुट टोकन × आउटपुट मूल्य।
दो व्यावहारिक परिणाम। एक लंबी चैट हर संदेश के साथ अधिक महंगी हो जाती है, क्योंकि हर बार पूरा इतिहास इनपुट के रूप में मॉडल को वापस जाता है। और आउटपुट की कीमत आमतौर पर प्रति टोकन इनपुट से कई गुना अधिक होती है, इसलिए छोटे उत्तर मांगने से वास्तविक पैसे बचते हैं।
चार चीज़ें जिन्हें लोग "टोकन" कहते हैं#
यह शब्द अतिभारित है, यही कारण है कि इसके लिए खोज करना इतना भ्रमित करने वाला है:
तालिका को दाईं ओर स्क्रॉल करें →
| जहाँ आपने इसे देखा | इसका क्या अर्थ है |
|---|---|
| किसी मॉडल की सीमाएँ या कीमतें | टेक्स्ट के टुकड़े, जैसा ऊपर वर्णित है |
| "API टोकन", "एक्सेस टोकन" | एक गुप्त कुंजी जो आपके कोड को API कॉल करने देती है। यह आपकी पहचान करती है; यह टेक्स्ट की प्रीपेड राशि नहीं है |
| चैट ऐप के अंदर टोकन | अक्सर ऐप के अपने क्रेडिट। वे मॉडल टोकन से कैसे संबंधित हैं यह ऐप पर निर्भर है |
| क्रिप्टो टोकन | एक ब्लॉकचेन संपत्ति, भाषा मॉडल से असंबंधित |
यदि आप "टोकन है…" जैसे किसी प्रश्नोत्तरी प्रश्न का उत्तर दे रहे हैं, तो भाषा मॉडल के लिए सही उत्तर टेक्स्ट का एक टुकड़ा है: एक शब्द, किसी शब्द का हिस्सा या एक प्रतीक।
आपको "पर्याप्त टोकन नहीं" क्यों दिख सकता है#
एक ही वाक्यांश चार अलग-अलग समस्याओं की ओर इशारा कर सकता है, और उनमें से केवल एक पैसे के बारे में है:
- प्रॉम्प्ट कॉन्टेक्स्ट विंडो में फिट नहीं होता। प्रत्येक मॉडल में इनपुट प्लस आउटपुट पर एक सीमा होती है। CheapTokens पर यह DeepSeek-V4-Flash के लिए 380,000 टोकन, GLM-5.3-Flash के लिए 390,000 और MiniMax-M2.7 के लिए 200,000 है। इतिहास छोटा करें या दस्तावेज़ को विभाजित करें।
- उत्तर आउटपुट सीमा तक पहुँच गया। उत्तर वाक्य के बीच में रुक जाता है। मॉडल के अधिकतम के भीतर
max_tokensबढ़ाएँ, या छोटा उत्तर मांगें। - बैलेंस खत्म हो गया। यह एकमात्र मामला है जहाँ टॉप अप करने से यह ठीक होता है।
- ऐप की अपनी सीमा है। चैट सेवाएँ अक्सर अपने स्वयं के नियमों से उपयोग को सीमित करती हैं, जो मॉडल से असंबंधित है।
अपने स्वयं के टेक्स्ट में टोकन कैसे गिनें#
सबसे विश्वसनीय संख्या API से आती है: प्रत्येक प्रतिक्रिया में usage ब्लॉक होता है जिसमें prompt_tokens और completion_ होते हैं।
भेजने से पहले अनुमान लगाने के लिए, मॉडल के टोकनाइज़र को स्थानीय रूप से चलाएँ। ओपन मॉडल अपने टोकनाइज़र को वेट के साथ प्रकाशित करते हैं। यह स्निपेट DeepSeek-V4-Flash-0731 टोकनाइज़र के साथ उदाहरण वाक्य को गिनता है:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
OpenAI मॉडल के लिए tiktoken लाइब्रेरी है। ध्यान रखें कि एक टोकनाइज़र से गिनती किसी अन्य मॉडल के लिए केवल एक अनुमान है।
आपका अगला कदम#
बजट का अनुमान लगाने के लिए, एक सामान्य प्रॉम्प्ट और उत्तर का आकार लें और प्रति मिलियन टोकन की कीमत से गुणा करें। वर्तमान CheapTokens कीमतें, अमेरिकी डॉलर में निर्धारित:
| मॉडल | संदर्भ | इनपुट $/1M | आउटपुट $/1M | OpenRouter इनपुट | OpenRouter आउटपुट |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning अस्थायी रूप से अनुपलब्ध | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash अस्थायी रूप से अनुपलब्ध | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 अस्थायी रूप से अनुपलब्ध | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
कीमतें USD प्रति 1M टोकन में हैं। OpenRouter के आंकड़े तुलना के लिए दिखाए गए हैं और बदल सकते हैं।


