AI 入门指南
AI 中的 token 是什么?一份通俗易懂的解释
token 是 AI 模型读取和写出的文本片段。看看真实分词器如何拆分一个句子、一个词要占多少 token,以及 token 如何变成账单。
本页内容
一个 token 是语言模型处理的一小段文本:一个完整的词、词的一部分、一个标点符号,或者一个词连同它前面的空格。模型把你的提示词当作 token 来读取,把回答当作 token 来写出,AI API 也按 token 计费。所以“这段文本有多少 token”实际上是两个问题:装得下吗,以及要花多少钱。
模型如何把文本切成 token#
在模型看到你的文本之前,分词器会把它拆成来自固定词表的片段,并把每个片段转成一个数字。高频词通常只占一个 token。罕见词和长词会被拆成多个部分。
这里有一个真实例子。我们把一个句子分别送进两个分词器:随 DeepSeek-V4-Flash-0731 发布的分词器,以及 OpenAI 的 o200k_base 编码。
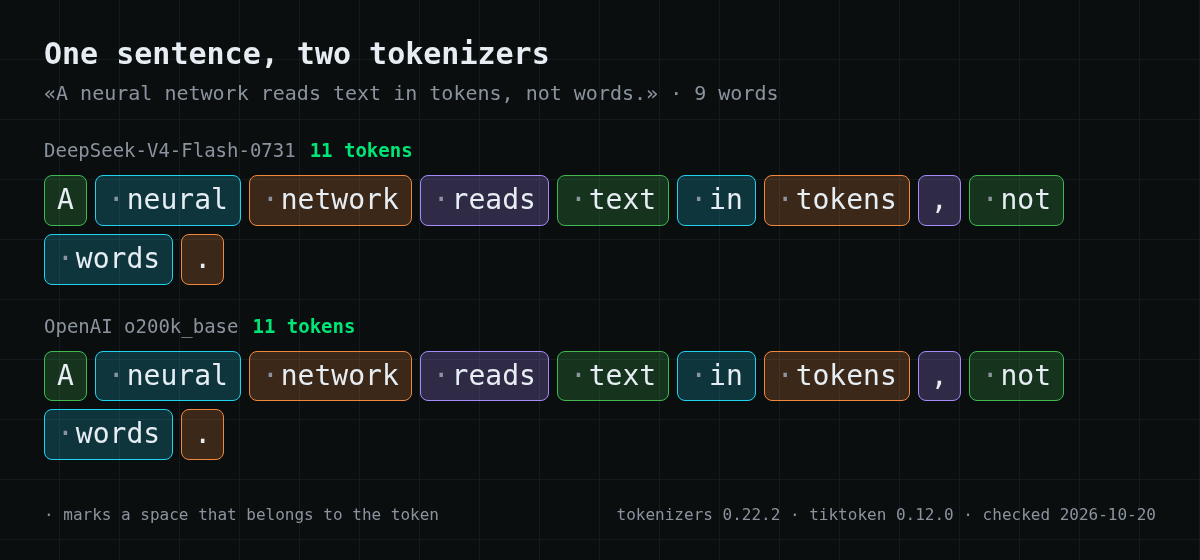
在英文中,两个分词器的结果一致:9 个词,11 个 token。逗号和句号各自是一个 token,大多数词都带着前面的空格。
长词是分词器开始出现差异的地方。“tokenization”在两者中都是两个 token:token + ization。俄语词 «токенизация» 对 DeepSeek 来说是三个 token,对 OpenAI 来说是四个。同一个词,数量不同。
一个词有多少 token#
用一段关于 token 的短文做个快速测试,分别用英文和俄文:
向右滚动表格 →
| 文本 | 词数 | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| 英文段落,254 个字符 | 53 | 60 个 token | 60 个 token |
| 同一段落的俄文版,255 个字符 | 42 | 73 个 token | 65 个 token |
对于英文文本,大约每词 1.1–1.2 个 token 是一个合理的估计。其他文字系统通常更贵:俄文版用更少的词表达了同样的意思,但用 DeepSeek 的分词器要多花约 20% 的 token。
把这些当作经验法则。每个模型系列都有自己的分词器,而你的文本的准确数量以 API 返回的为准。
Token 就是你付费的东西#
API 价格按每百万 token 报价,输入和输出分开计算:
- 输入 token —— 你发送的一切:系统提示词、聊天历史、文档和你的问题;
- 输出 token —— 模型写回的一切,包括模型在回答前进行推理时的推理内容。
一次请求的成本是输入 token × 输入价格 + 输出 token × 输出价格。
两个实际后果。长对话每多一条消息都会更贵,因为每次整个历史都会作为输入送回模型。而且输出的每 token 价格通常比输入贵好几倍,所以要求更简短的回答能省下真金白银。
人们称为“token”的四样东西#
这个词被过度使用了,所以搜索它才会这么令人困惑:
向右滚动表格 →
| 你在哪里看到它 | 它是什么意思 |
|---|---|
| 模型的限制或价格 | 文本片段,如上所述 |
| “API token”、“access token” | 一个密钥,让你的代码可以调用 API。它用于识别你的身份;它不是预付的文本额度 |
| 聊天应用内部的 token | 通常是应用自己的积分。它们与模型 token 的关系由应用决定 |
| 加密货币 token | 一种区块链资产,与语言模型无关 |
如果你在回答像“a token is…”这样的测验题,对于语言模型来说,正确答案是一段文本:一个词、词的一部分或一个符号。
为什么你可能会看到“not enough tokens”#
同一句话可能指向四种不同的问题,其中只有一种与钱有关:
- 提示词装不进上下文窗口。 每个模型都对输入加输出有上限。在 CheapTokens,DeepSeek-V4-Flash 是 380,000 个 token,GLM-5.3-Flash 是 390,000 个,MiniMax-M2.7 是 200,000 个。缩短历史或拆分文档。
- 回答触到了输出上限。 回复在句子中间停住。在模型的最大值范围内调高
max_tokens,或者要求更简短的回答。 - 余额用完了。 这是唯一一种充值就能解决的情况。
- 应用有自己的限制。 聊天服务常常按自己的规则限制用量,与模型本身无关。
如何统计你自己文本中的 token#
最可靠的数字来自 API:每个响应都包含一个 usage 块,其中有 prompt_tokens 和 completion_。
要在发送前估算,可以在本地运行模型的分词器。开放模型会在权重旁边发布自己的分词器。这段代码用 DeepSeek-V4-Flash-0731 分词器统计示例句子:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
对于 OpenAI 模型,有 tiktoken 库。请记住,来自一个分词器的计数对其他任何模型都只是估算。
你的下一步#
要估算预算,取一个典型的提示词和回答大小,乘以每百万 token 的价格。当前 CheapTokens 价格,以美元固定:
| 模型 | 上下文 | 输入 $/1M | 输出 $/1M | OpenRouter 输入 | OpenRouter 输出 |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning 暂时不可用 | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash 暂时不可用 | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 暂时不可用 | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
价格以每 100 万 token 的美元金额计算。OpenRouter 数据仅供参考,可能会有变动。


