¿Qué es un token en IA? Una explicación en lenguaje sencillo
Un token es el fragmento de texto que un modelo de IA lee y escribe. Mira cómo un tokenizador real divide una frase, cuántos tokens ocupa una palabra y cómo los tokens se convierten en una factura.
En esta página
Un token es un pequeño fragmento de texto con el que trabaja un modelo de lenguaje: una palabra completa, parte de una palabra, un signo de puntuación o una palabra junto con el espacio que la precede. Los modelos leen tu prompt como tokens, escriben la respuesta como tokens, y las APIs de IA facturan por token. Así que "cuántos tokens es esto" son en realidad dos preguntas: ¿cabe?, y ¿cuánto costará?
Cómo corta un modelo el texto en tokens#
Antes de que un modelo vea tu texto, un tokenizador lo divide en piezas de un vocabulario fijo y convierte cada pieza en un número. Las palabras frecuentes suelen recibir un solo token. Las palabras raras y largas se dividen en partes.
Aquí tienes un ejemplo real. Pasamos una frase por dos tokenizadores: el publicado con DeepSeek-V4-Flash-0731 y la codificación o200k_base de OpenAI.
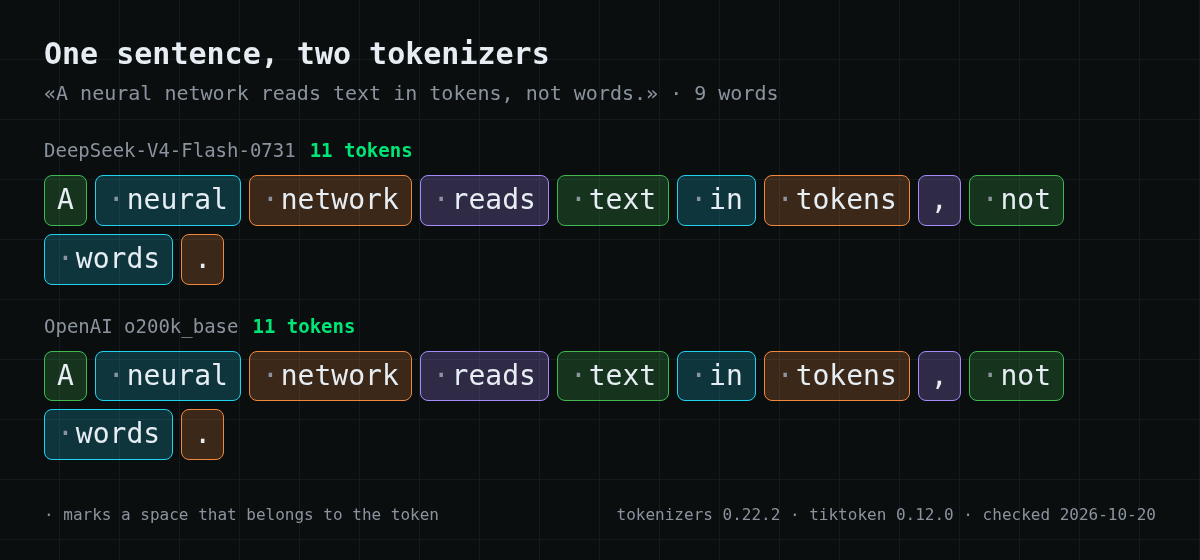
En inglés ambos tokenizadores coinciden: 9 palabras, 11 tokens. La coma y el punto son tokens propios, y la mayoría de las palabras llevan el espacio delante.
Las palabras largas son donde los tokenizadores empiezan a diferir. "tokenization" son dos tokens en ambos: token + ization. La palabra rusa «токенизация» son tres tokens para DeepSeek y cuatro para OpenAI. La misma palabra, distinto recuento.
Cuántos tokens es una palabra#
Una prueba rápida con un párrafo corto sobre tokens, en inglés y en ruso:
Desplaza la tabla hacia la derecha →
| Texto | Palabras | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Párrafo en inglés, 254 caracteres | 53 | 60 tokens | 60 tokens |
| El mismo párrafo en ruso, 255 caracteres | 42 | 73 tokens | 65 tokens |
Para texto en inglés, aproximadamente 1,1–1,2 tokens por palabra es una estimación razonable. Otros alfabetos suelen costar más: la versión en ruso dice lo mismo en menos palabras pero consume alrededor de un 20% más de tokens con el tokenizador de DeepSeek.
Toma esto como reglas generales. Cada familia de modelos tiene su propio tokenizador, y el recuento exacto para tu texto es el que devuelve la API.
Los tokens son lo que pagas#
Los precios de las APIs se cotizan por millón de tokens, por separado para entrada y salida:
- tokens de entrada — todo lo que envías: el prompt del sistema, el historial de chat, los documentos y tu pregunta;
- tokens de salida — todo lo que el modelo escribe de vuelta, incluido su razonamiento si el modelo razona antes de responder.
El coste de una petición es tokens de entrada × precio de entrada + tokens de salida × precio de salida.
Dos consecuencias prácticas. Un chat largo se vuelve más caro con cada mensaje, porque todo el historial vuelve al modelo como entrada cada vez. Y la salida suele costar varias veces más por token que la entrada, así que pedir respuestas más cortas ahorra dinero de verdad.
Cuatro cosas a las que la gente llama "token"#
La palabra está sobrecargada, y por eso buscarla resulta tan confuso:
Desplaza la tabla hacia la derecha →
| Dónde lo viste | Qué significa |
|---|---|
| Los límites o precios de un modelo | Fragmentos de texto, como se describe arriba |
| "API token", "access token" | Una clave secreta que permite a tu código llamar a la API. Te identifica; no es una cantidad de texto prepagada |
| Tokens dentro de una app de chat | A menudo son los créditos propios de la app. Cómo se relacionan con los tokens del modelo depende de la app |
| Tokens de criptomonedas | Un activo de blockchain, sin relación con los modelos de lenguaje |
Si estás respondiendo una pregunta de examen como "un token es…", para los modelos de lenguaje la respuesta correcta es un fragmento de texto: una palabra, parte de una palabra o un símbolo.
Por qué puedes ver "not enough tokens"#
La misma frase puede señalar cuatro problemas distintos, y solo uno de ellos tiene que ver con el dinero:
- El prompt no cabe en la ventana de contexto. Cada modelo tiene un límite de entrada más salida. En CheapTokens es de 380.000 tokens para DeepSeek-V4-Flash, 390.000 para GLM-5.3-Flash y 200.000 para MiniMax-M2.7. Acorta el historial o divide el documento.
- La respuesta alcanzó el límite de salida. La réplica se corta a mitad de frase. Sube
max_tokensdentro del máximo del modelo, o pide una respuesta más corta. - Se agotó el saldo. Este es el único caso en que recargar lo soluciona.
- La app tiene su propio límite. Los servicios de chat suelen limitar el uso según sus propias reglas, sin relación con el modelo en sí.
Cómo contar tokens en tu propio texto#
El número más fiable viene de la API: cada respuesta incluye un bloque usage con prompt_tokens y completion_.
Para estimar antes de enviar, ejecuta el tokenizador del modelo en local. Los modelos abiertos publican su tokenizador junto a los pesos. Este fragmento cuenta la frase de ejemplo con el tokenizador DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Para los modelos de OpenAI existe la librería tiktoken. Ten en cuenta que un recuento de un tokenizador es solo una estimación para cualquier otro modelo.
Tu siguiente paso#
Para estimar un presupuesto, toma un tamaño típico de prompt y respuesta y multiplícalo por el precio por millón de tokens. Precios actuales de CheapTokens, fijados en dólares estadounidenses:
| Modelo | Contexto | Entrada $/1M | Salida $/1M | OpenRouter entrada | OpenRouter salida |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning temporalmente no disponible | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash temporalmente no disponible | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 temporalmente no disponible | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Precios en USD por 1M de tokens. Las cifras de OpenRouter se muestran para comparación y pueden cambiar.


