AI cho người mớiHướng dẫn
Token trong AI là gì? Giải thích bằng ngôn ngữ đơn giản
Token là mẩu văn bản mà mô hình AI đọc và viết. Xem cách một tokenizer thực tế tách một câu, một từ tốn bao nhiêu token và cách token trở thành hóa đơn.
Trên trang này
Một token là một mẩu văn bản nhỏ mà mô hình ngôn ngữ xử lý: một từ trọn vẹn, một phần của từ, một dấu câu, hoặc một từ cùng với khoảng trắng đứng trước nó. Mô hình đọc prompt của bạn dưới dạng token, viết câu trả lời dưới dạng token, và các API AI tính phí theo token. Vậy nên "đoạn này có bao nhiêu token" thực ra là hai câu hỏi: nó có vừa không, và nó sẽ tốn bao nhiêu.
Cách mô hình cắt văn bản thành token#
Trước khi mô hình nhìn thấy văn bản của bạn, một tokenizer sẽ tách nó thành các mảnh từ một bộ từ vựng cố định và biến mỗi mảnh thành một con số. Những từ thường gặp thường chỉ chiếm một token. Những từ hiếm và dài bị tách thành nhiều phần.
Đây là một ví dụ thực tế. Chúng tôi chạy một câu qua hai tokenizer: tokenizer được công bố cùng DeepSeek-V4-Flash-0731 và bảng mã o200k_base của OpenAI.
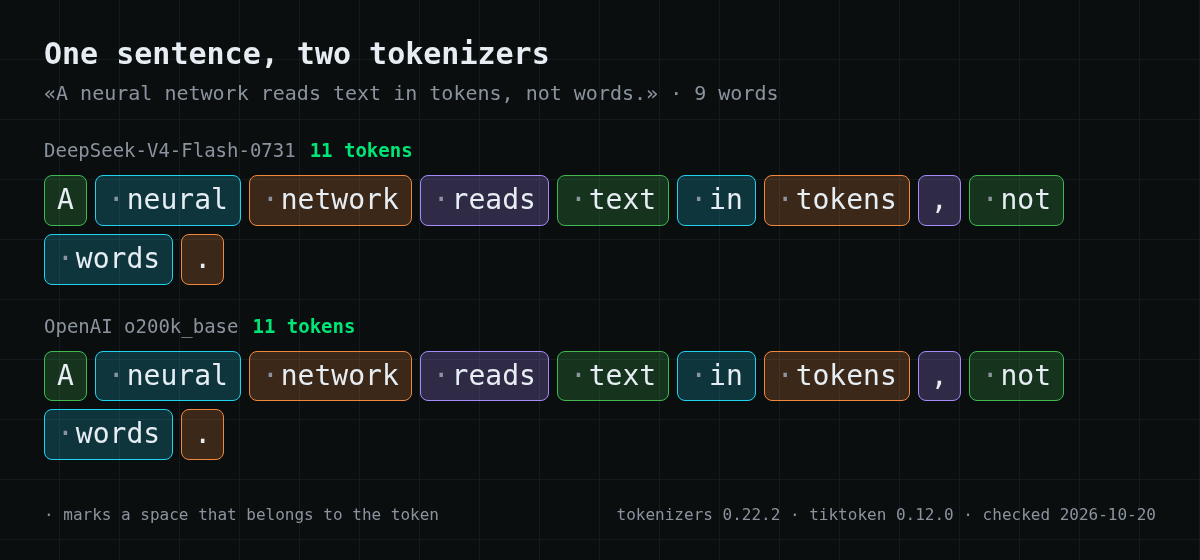
Với tiếng Anh, cả hai tokenizer đều đồng ý: 9 từ, 11 token. Dấu phẩy và dấu chấm là những token riêng, và hầu hết các từ mang theo khoảng trắng đứng trước chúng.
Từ dài là nơi các tokenizer bắt đầu khác nhau. "tokenization" là hai token trong cả hai: token + ization. Từ tiếng Nga «токенизация» là ba token với DeepSeek và bốn token với OpenAI. Cùng một từ, số lượng khác nhau.
Một từ có bao nhiêu token#
Một thử nghiệm nhanh với một đoạn ngắn về token, bằng tiếng Anh và tiếng Nga:
Cuộn bảng sang phải →
| Văn bản | Số từ | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Đoạn tiếng Anh, 254 ký tự | 53 | 60 token | 60 token |
| Cùng đoạn đó bằng tiếng Nga, 255 ký tự | 42 | 73 token | 65 token |
Với văn bản tiếng Anh, khoảng 1,1–1,2 token mỗi từ là một ước lượng hợp lý. Các hệ chữ khác thường tốn nhiều hơn: bản tiếng Nga nói cùng một điều với ít từ hơn nhưng tốn khoảng 20% token nhiều hơn với tokenizer của DeepSeek.
Hãy coi đây là những quy tắc kinh nghiệm. Mỗi họ mô hình có tokenizer riêng, và con số chính xác cho văn bản của bạn là con số mà API trả về.
Token là thứ bạn phải trả tiền#
Giá API được niêm yết trên mỗi triệu token, tách riêng cho đầu vào và đầu ra:
- token đầu vào — mọi thứ bạn gửi: system prompt, lịch sử trò chuyện, tài liệu và câu hỏi của bạn;
- token đầu ra — mọi thứ mô hình viết trả lại, kể cả phần suy luận nếu mô hình suy luận trước khi trả lời.
Chi phí của một yêu cầu là token đầu vào × giá đầu vào + token đầu ra × giá đầu ra.
Hai hệ quả thực tế. Một cuộc trò chuyện dài sẽ càng đắt hơn sau mỗi tin nhắn, vì toàn bộ lịch sử đều được gửi lại cho mô hình như đầu vào mỗi lần. Và đầu ra thường tốn vài lần giá mỗi token so với đầu vào, nên yêu cầu câu trả lời ngắn hơn giúp tiết kiệm tiền thật sự.
Bốn thứ mà người ta gọi là "token"#
Từ này bị dùng quá tải, đó là lý do việc tìm kiếm nó lại rối rắm đến vậy:
Cuộn bảng sang phải →
| Nơi bạn thấy nó | Nó có nghĩa là gì |
|---|---|
| Giới hạn hoặc giá của một mô hình | Các mẩu văn bản, như mô tả ở trên |
| "API token", "access token" | Một khóa bí mật cho phép mã của bạn gọi API. Nó định danh bạn; nó không phải là một lượng văn bản trả trước |
| Token bên trong một ứng dụng trò chuyện | Thường là tín dụng riêng của ứng dụng. Mối liên hệ của chúng với token của mô hình do ứng dụng quyết định |
| Token tiền mã hóa | Một tài sản blockchain, không liên quan đến mô hình ngôn ngữ |
Nếu bạn đang trả lời một câu hỏi trắc nghiệm kiểu "a token is…", thì với mô hình ngôn ngữ, câu trả lời đúng là một mẩu văn bản: một từ, một phần của từ hoặc một ký hiệu.
Vì sao bạn có thể thấy "không đủ token"#
Cùng một cụm từ có thể chỉ bốn vấn đề khác nhau, và chỉ một trong số đó liên quan đến tiền:
- Prompt không vừa với cửa sổ ngữ cảnh. Mỗi mô hình có một giới hạn cho đầu vào cộng đầu ra. Tại CheapTokens, con số này là 380.000 token với DeepSeek-V4-Flash, 390.000 với GLM-5.3-Flash và 200.000 với MiniMax-M2.7. Hãy rút ngắn lịch sử hoặc chia nhỏ tài liệu.
- Câu trả lời chạm giới hạn đầu ra. Phản hồi dừng giữa câu. Hãy tăng
max_tokenstrong phạm vi tối đa của mô hình, hoặc yêu cầu câu trả lời ngắn hơn. - Số dư đã hết. Đây là trường hợp duy nhất mà việc nạp tiền khắc phục được.
- Ứng dụng có giới hạn riêng. Các dịch vụ trò chuyện thường giới hạn mức sử dụng theo quy tắc riêng của họ, không liên quan đến bản thân mô hình.
Cách đếm token trong văn bản của chính bạn#
Con số đáng tin cậy nhất đến từ API: mọi phản hồi đều bao gồm một khối usage với prompt_tokens và completion_.
Để ước lượng trước khi gửi, hãy chạy tokenizer của mô hình ngay trên máy bạn. Các mô hình mở công bố tokenizer của chúng bên cạnh trọng số. Đoạn mã này đếm câu ví dụ bằng tokenizer DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Với các mô hình OpenAI thì có thư viện tiktoken. Hãy nhớ rằng con số đếm từ một tokenizer chỉ là ước lượng cho bất kỳ mô hình nào khác.
Bước tiếp theo của bạn#
Để ước lượng ngân sách, hãy lấy một prompt điển hình và kích thước câu trả lời rồi nhân với giá mỗi triệu token. Giá CheapTokens hiện tại, cố định bằng đô la Mỹ:
| Mô hình | Ngữ cảnh | Đầu vào $/1M | Đầu ra $/1M | OpenRouter vào | OpenRouter ra |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning tạm thời không khả dụng | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash tạm thời không khả dụng | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 tạm thời không khả dụng | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Giá tính bằng USD cho mỗi 1 triệu token. Các số liệu của OpenRouter được hiển thị để so sánh và có thể thay đổi.


