AI สำหรับผู้เริ่มต้นคู่มือ
โทเคนใน AI คืออะไร? คำอธิบายแบบเข้าใจง่าย
โทเคนคือชิ้นส่วนข้อความที่โมเดล AI อ่านและเขียน ดูว่าตัวตัดคำจริงแบ่งประโยคอย่างไร หนึ่งคำใช้กี่โทเคน และโทเคนกลายเป็นบิลได้อย่างไร
ในหน้านี้
โทเคนคือชิ้นส่วนข้อความเล็ก ๆ ที่โมเดลภาษาทำงานด้วย: ทั้งคำ ส่วนหนึ่งของคำ เครื่องหมายวรรคตอน หรือคำพร้อมช่องว่างข้างหน้า โมเดลอ่านพรอมป์ของคุณเป็นโทเคน เขียนคำตอบเป็นโทเคน และ API ของ AI คิดค่าบริการตามโทเคน ดังนั้น "ข้อความนี้มีกี่โทเคน" จริง ๆ แล้วเป็นสองคำถาม: จะพอดีกับขีดจำกัดไหม และจะเสียค่าใช้จ่ายเท่าไร
โมเดลตัดข้อความเป็นโทเคนอย่างไร#
ก่อนที่โมเดลจะเห็นข้อความของคุณ ตัวตัดคำ (tokenizer) จะแบ่งข้อความเป็นชิ้นส่วนจากคลังคำศัพท์คงที่ และแปลงแต่ละชิ้นเป็นตัวเลข คำที่พบบ่อยมักได้หนึ่งโทเคน คำที่หายากและยาวจะถูกแบ่งเป็นส่วน ๆ
นี่คือตัวอย่างจริง เราได้รันหนึ่งประโยคผ่านตัวตัดคำสองตัว: ตัวที่เผยแพร่พร้อมกับ DeepSeek-V4-Flash-0731 และการเข้ารหัส o200k_base ของ OpenAI
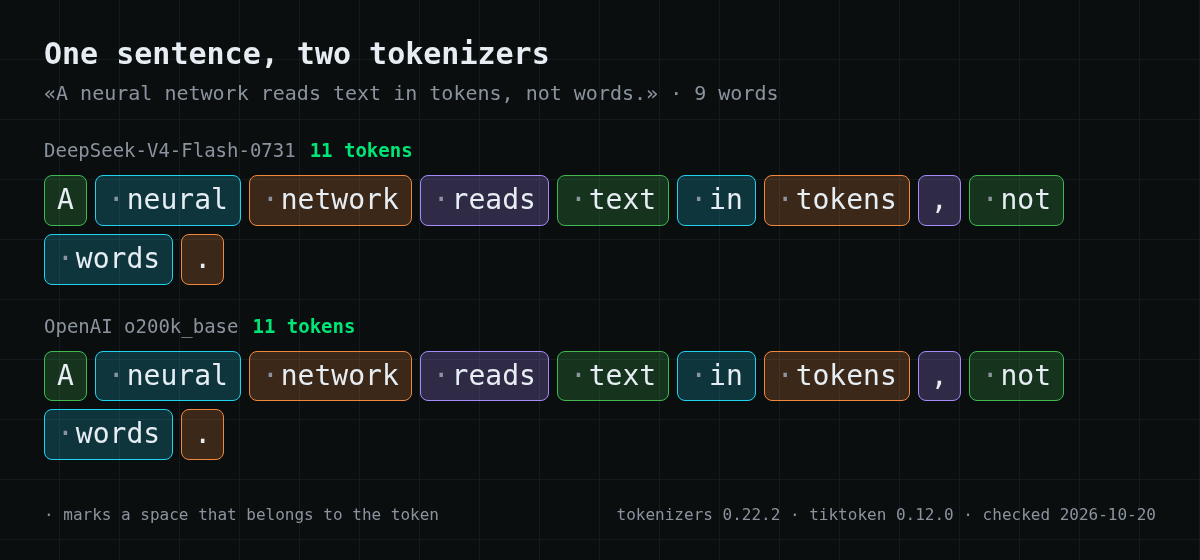
ในภาษาอังกฤษ ตัวตัดคำทั้งสองเห็นตรงกัน: 9 คำ 11 โทเคน เครื่องหมายจุลภาคและมหัพภาคเป็นโทเคนของตัวเอง และคำส่วนใหญ่มีช่องว่างนำหน้า
คำยาวคือจุดที่ตัวตัดคำเริ่มแตกต่างกัน "tokenization" เป็นสองโทเคนในทั้งสองตัว: token + ization คำภาษารัสเซีย «токенизация» เป็นสามโทเคนสำหรับ DeepSeek และสี่โทเคนสำหรับ OpenAI คำเดียวกัน จำนวนต่างกัน
หนึ่งคำมีกี่โทเคน#
การทดสอบเร็ว ๆ ด้วยย่อหน้าสั้นเกี่ยวกับโทเคน ทั้งในภาษาอังกฤษและภาษารัสเซีย:
เลื่อนตารางไปทางขวา →
| ข้อความ | คำ | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| ย่อหน้าภาษาอังกฤษ 254 ตัวอักษร | 53 | 60 โทเคน | 60 โทเคน |
| ย่อหน้าเดียวกันในภาษารัสเซีย 255 ตัวอักษร | 42 | 73 โทเคน | 65 โทเคน |
สำหรับข้อความภาษาอังกฤษ ประมาณ 1.1–1.2 โทเคนต่อคำเป็นค่าประมาณที่ใช้ได้ ระบบการเขียนอื่นมักมีค่าใช้จ่ายสูงกว่า: เวอร์ชันภาษารัสเซียพูดสิ่งเดียวกันด้วยคำที่น้อยกว่า แต่ใช้โทเคนมากกว่าประมาณ 20% กับตัวตัดคำของ DeepSeek
ถือว่าสิ่งเหล่านี้เป็นหลักคร่าว ๆ ทุกตระกูลโมเดลมีตัวตัดคำของตัวเอง และจำนวนที่แน่นอนสำหรับข้อความของคุณคือจำนวนที่ API รายงานกลับมา
โทเคนคือสิ่งที่คุณจ่าย#
ราคา API ถูกกำหนดต่อล้านโทเคน แยกสำหรับอินพุตและเอาต์พุต:
- โทเคนอินพุต — ทุกอย่างที่คุณส่ง: พรอมป์ระบบ ประวัติแชท เอกสาร และคำถามของคุณ;
- โทเคนเอาต์พุต — ทุกอย่างที่โมเดลเขียนกลับ รวมถึงการให้เหตุผลของมันหากโมเดลให้เหตุผลก่อนตอบ
ค่าใช้จ่ายของคำขอคือ โทเคนอินพุต × ราคาอินพุต + โทเคนเอาต์พุต × ราคาเอาต์พุต
ผลที่ตามมาในทางปฏิบัติสองประการ แชทที่ยาวขึ้นจะแพงขึ้นทุกข้อความ เพราะประวัติทั้งหมดถูกส่งกลับไปยังโมเดลเป็นอินพุตทุกครั้ง และเอาต์พุตมักมีค่าใช้จ่ายต่อโทเคนมากกว่าอินพุตหลายเท่า ดังนั้นการขอคำตอบที่สั้นลงจึงประหยัดเงินจริง
สี่สิ่งที่ผู้คนเรียกว่า "โทเคน"#
คำนี้มีความหมายหลายอย่าง ซึ่งเป็นเหตุผลว่าทำไมการค้นหาจึงสับสนมาก:
เลื่อนตารางไปทางขวา →
| ที่คุณเห็น | ความหมาย |
|---|---|
| ขีดจำกัดหรือราคาของโมเดล | ชิ้นส่วนข้อความ ตามที่อธิบายข้างต้น |
| "API token", "access token" | คีย์ลับที่ให้โค้ดของคุณเรียก API มันระบุตัวตนของคุณ ไม่ใช่จำนวนข้อความที่จ่ายล่วงหน้า |
| โทเคนในแอปแชท | มักเป็นเครดิตของแอปเอง ความสัมพันธ์กับโทเคนของโมเดลขึ้นอยู่กับแอป |
| โทเคนคริปโต | สินทรัพย์บนบล็อกเชน ไม่เกี่ยวข้องกับโมเดลภาษา |
หากคุณกำลังตอบคำถามแบบทดสอบเช่น "โทเคนคือ…" สำหรับโมเดลภาษา คำตอบที่ถูกต้องคือชิ้นส่วนข้อความ: คำ ส่วนหนึ่งของคำ หรือสัญลักษณ์
ทำไมคุณอาจเห็น "โทเคนไม่เพียงพอ"#
วลีเดียวกันสามารถชี้ไปที่ปัญหาสี่อย่างที่แตกต่างกัน และมีเพียงอย่างเดียวที่เกี่ยวกับเงิน:
- พรอมป์ไม่พอดีกับหน้าต่างบริบท ทุกโมเดลมีขีดจำกัดอินพุตบวกเอาต์พุต ที่ CheapTokens คือ 380,000 โทเคนสำหรับ DeepSeek-V4-Flash, 390,000 สำหรับ GLM-5.3-Flash และ 200,000 สำหรับ MiniMax-M2.7 ย่อประวัติหรือแบ่งเอกสาร
- คำตอบชนขีดจำกัดเอาต์พุต คำตอบหยุดกลางประโยค เพิ่ม
max_tokensภายในค่าสูงสุดของโมเดล หรือขอคำตอบที่สั้นลง - ยอดคงเหลือหมด นี่เป็นกรณีเดียวที่การเติมเงินแก้ได้
- แอปมีขีดจำกัดของตัวเอง บริการแชทมักจำกัดการใช้งานตามกฎของตัวเอง ซึ่งไม่เกี่ยวข้องกับโมเดลเอง
วิธีนับโทเคนในข้อความของคุณเอง#
ตัวเลขที่น่าเชื่อถือที่สุดมาจาก API: ทุกการตอบกลับมีบล็อก usage พร้อม prompt_tokens และ completion_
หากต้องการประมาณก่อนส่ง ให้รันตัวตัดคำของโมเดลในเครื่อง โมเดลเปิดเผยตัวตัดคำไว้ข้าง ๆ น้ำหนัก โค้ดสั้นนี้จะนับประโยคตัวอย่างด้วยตัวตัดคำ DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
สำหรับโมเดล OpenAI มีไลบรารี tiktoken โปรดจำไว้ว่าการนับจากตัวตัดคำหนึ่งเป็นเพียงการประมาณสำหรับโมเดลอื่น
ขั้นตอนต่อไปของคุณ#
หากต้องการประมาณงบประมาณ ให้นำพรอมป์ทั่วไปและขนาดคำตอบมาคูณกับราคาต่อล้านโทเคน ราคา CheapTokens ปัจจุบัน กำหนดเป็นดอลลาร์สหรัฐ:
| โมเดล | บริบท | Input $/1M | Output $/1M | OpenRouter เข้า | OpenRouter ออก |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning ไม่พร้อมใช้งานชั่วคราว | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash ไม่พร้อมใช้งานชั่วคราว | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 ไม่พร้อมใช้งานชั่วคราว | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
ราคาเป็น USD ต่อ 1 ล้านโทเค็น ตัวเลขของ OpenRouter แสดงไว้เพื่อเปรียบเทียบและอาจมีการเปลี่ยนแปลง


