AI dla początkującychPrzewodnik
Czym jest token w AI? Wyjaśnienie prostym językiem
Token to fragment tekstu, który model AI czyta i zapisuje. Zobacz, jak prawdziwy tokenizer dzieli zdanie, ile tokenów zajmuje słowo i jak tokeny zamieniają się w rachunek.
Na tej stronie
Token to mały fragment tekstu, z którym pracuje model językowy: całe słowo, część słowa, znak interpunkcyjny albo słowo razem ze spacją przed nim. Modele czytają Twój prompt jako tokeny, piszą odpowiedź jako tokeny, a API AI rozliczają się za token. Więc pytanie „ile to jest tokenów” to tak naprawdę dwa pytania: czy się zmieści i ile będzie kosztować.
Jak model tnie tekst na tokeny#
Zanim model zobaczy Twój tekst, tokenizer dzieli go na fragmenty ze stałego słownika i zamienia każdy fragment na liczbę. Częste słowa zwykle dostają jeden token. Rzadkie i długie słowa są dzielone na części.
Oto prawdziwy przykład. Przepuściliśmy jedno zdanie przez dwa tokenizery: ten opublikowany z DeepSeek-V4-Flash-0731 i kodowanie o200k_base OpenAI.
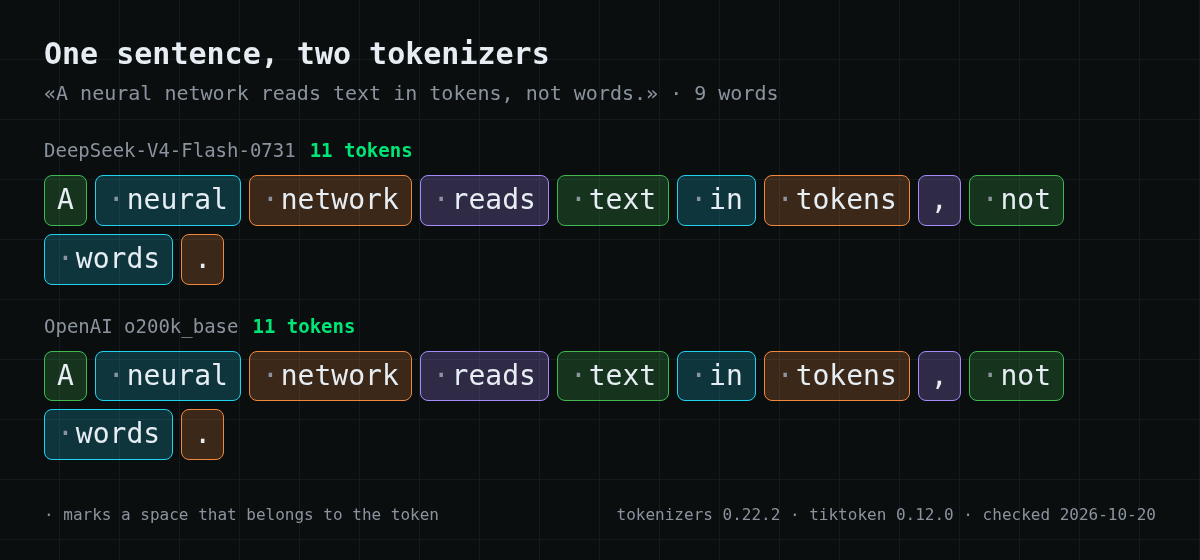
W angielskim oba tokenizery się zgadzają: 9 słów, 11 tokenów. Przecinek i kropka to osobne tokeny, a większość słów niesie ze sobą spację przed nimi.
Długie słowa to miejsce, gdzie tokenizery zaczynają się różnić. "tokenization" to dwa tokeny w obu: token + ization. Rosyjskie słowo «токенизация» to trzy tokeny dla DeepSeek i cztery dla OpenAI. To samo słowo, inna liczba.
Ile tokenów ma słowo#
Szybki test z krótkim akapitem o tokenach, po angielsku i po rosyjsku:
Przewiń tabelę w prawo →
| Tekst | Słowa | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Akapit angielski, 254 znaki | 53 | 60 tokenów | 60 tokenów |
| Ten sam akapit po rosyjsku, 255 znaków | 42 | 73 tokeny | 65 tokenów |
Dla tekstu angielskiego około 1,1–1,2 tokenu na słowo to rozsądne oszacowanie. Inne systemy pisma zwykle kosztują więcej: rosyjska wersja mówi to samo w mniejszej liczbie słów, ale zajmuje około 20% więcej tokenów z tokenizerem DeepSeek.
Traktuj te liczby jako reguły kciuka. Każda rodzina modeli ma własny tokenizer, a dokładna liczba dla Twojego tekstu to ta, którą zwraca API.
Tokeny to to, za co płacisz#
Ceny API podaje się za milion tokenów, osobno dla wejścia i wyjścia:
- tokeny wejściowe — wszystko, co wysyłasz: prompt systemowy, historię czatu, dokumenty i swoje pytanie;
- tokeny wyjściowe — wszystko, co model odpisuje, w tym jego rozumowanie, jeśli model rozumuje przed odpowiedzią.
Koszt żądania to tokeny wejściowe × cena wejścia + tokeny wyjściowe × cena wyjścia.
Dwie praktyczne konsekwencje. Długi czat staje się droższy z każdą wiadomością, bo cała historia wraca do modelu jako wejście za każdym razem. A wyjście zwykle kosztuje kilka razy więcej za token niż wejście, więc proszenie o krótsze odpowiedzi oszczędza realne pieniądze.
Cztery rzeczy, które ludzie nazywają „tokenem”#
To słowo jest przeciążone, dlatego szukanie go jest tak mylące:
Przewiń tabelę w prawo →
| Gdzie to widziałeś | Co to znaczy |
|---|---|
| Limity lub ceny modelu | Fragmenty tekstu, jak opisano powyżej |
| „Token API”, „token dostępu” | Tajny klucz, który pozwala Twojemu kodowi wywołać API. Identyfikuje Cię; to nie jest przedpłacona ilość tekstu |
| Tokeny w aplikacji czatu | Często własne kredyty aplikacji. To, jak odnoszą się do tokenów modelu, zależy od aplikacji |
| Tokeny kryptowalutowe | Zasób blockchain, niezwiązany z modelami językowymi |
Jeśli odpowiadasz na pytanie quizowe typu „token to…”, dla modeli językowych poprawna odpowiedź to fragment tekstu: słowo, część słowa lub symbol.
Dlaczego możesz zobaczyć „za mało tokenów”#
To samo zdanie może wskazywać na cztery różne problemy, a tylko jeden z nich dotyczy pieniędzy:
- Prompt nie mieści się w oknie kontekstu. Każdy model ma limit na wejście plus wyjście. W CheapTokens to 380 000 tokenów dla DeepSeek-V4-Flash, 390 000 dla GLM-5.3-Flash i 200 000 dla MiniMax-M2.7. Skróć historię albo podziel dokument.
- Odpowiedź trafiła w limit wyjścia. Odpowiedź urywa się w połowie zdania. Zwiększ
max_tokensw granicach maksimum modelu albo poproś o krótszą odpowiedź. - Skończyło się saldo. To jedyny przypadek, w którym doładowanie to naprawia.
- Aplikacja ma własny limit. Usługi czatu często ograniczają użycie według własnych zasad, niezależnie od samego modelu.
Jak liczyć tokeny we własnym tekście#
Najbardziej wiarygodna liczba pochodzi z API: każda odpowiedź zawiera blok usage z prompt_tokens i completion_.
Aby oszacować przed wysłaniem, uruchom tokenizer modelu lokalnie. Otwarte modele publikują swój tokenizer obok wag. Ten fragment kodu liczy przykładowe zdanie tokenizerem DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Dla modeli OpenAI jest biblioteka tiktoken. Pamiętaj, że liczba z jednego tokenizera to tylko oszacowanie dla każdego innego modelu.
Twój następny krok#
Aby oszacować budżet, weź typowy prompt i rozmiar odpowiedzi i pomnóż przez cenę za milion tokenów. Obecne ceny CheapTokens, ustalone w dolarach amerykańskich:
| Model | Kontekst | Wejście $/1M | Wyjście $/1M | OpenRouter wejście | OpenRouter wyjście |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning chwilowo niedostępny | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash chwilowo niedostępny | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 chwilowo niedostępny | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Ceny w USD za 1 mln tokenów. Dane OpenRouter służą do porównania i mogą ulec zmianie.


