Yeni başlayanlar için AIKılavuz
Yapay zekâda token nedir? Sade bir dille açıklama
Token, bir yapay zekâ modelinin okuyup yazdığı metin parçasıdır. Gerçek bir tokenizer'ın bir cümleyi nasıl böldüğünü, bir kelimenin kaç token tuttuğunu ve tokenların nasıl faturaya dönüştüğünü görün.
Bu sayfada
Token, bir dil modelinin üzerinde çalıştığı küçük bir metin parçasıdır: tam bir kelime, bir kelimenin parçası, bir noktalama işareti ya da önündeki boşlukla birlikte bir kelime. Modeller isteminizi token olarak okur, yanıtı token olarak yazar ve yapay zekâ API'leri token başına ücretlendirir. Yani "bu kaç token" sorusu aslında iki sorudur: sığar mı ve ne kadara mal olur.
Bir model metni nasıl tokenlara böler#
Bir model metninizi görmeden önce, bir tokenizer onu sabit bir sözlükten parçalara böler ve her parçayı bir sayıya dönüştürür. Sık kullanılan kelimeler genellikle tek bir token alır. Nadir ve uzun kelimeler parçalara ayrılır.
İşte gerçek bir örnek. Bir cümleyi iki tokenizer'dan geçirdik: DeepSeek-V4-Flash-0731 ile yayımlanan tokenizer ve OpenAI'nin o200k_base kodlaması.
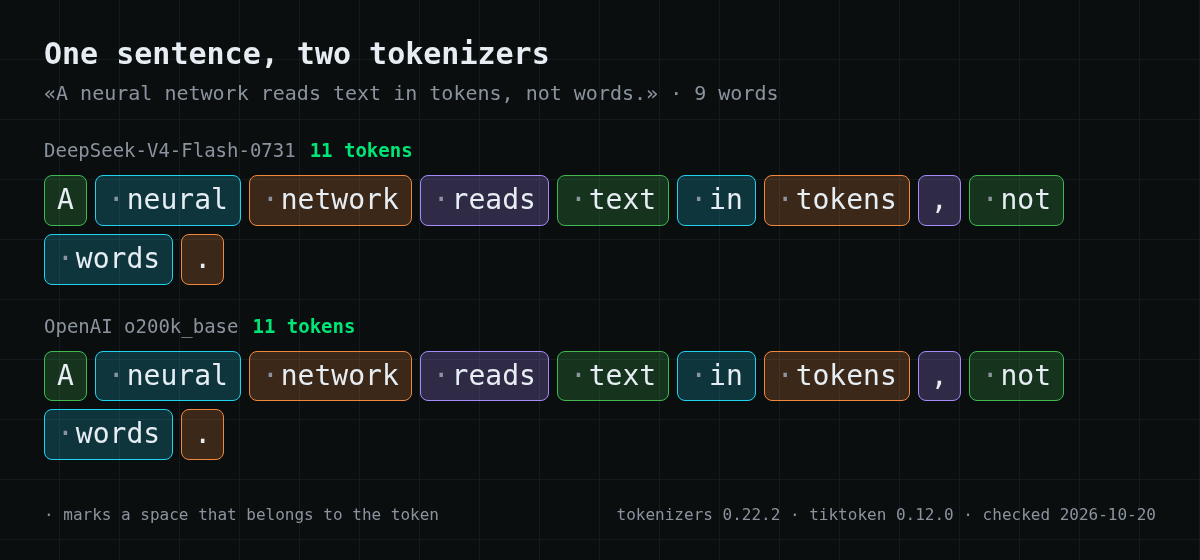
İngilizcede her iki tokenizer da aynı fikirde: 9 kelime, 11 token. Virgül ve nokta kendi başlarına birer tokendir ve çoğu kelime önündeki boşluğu taşır.
Uzun kelimeler tokenizer'ların ayrışmaya başladığı yerdir. "tokenization" her ikisinde de iki tokendir: token + ization. Rusça «токенизация» kelimesi DeepSeek için üç, OpenAI için dört tokendir. Aynı kelime, farklı sayı.
Bir kelime kaç tokendir#
Tokenlar hakkında kısa bir paragrafla, İngilizce ve Rusça hızlı bir test:
Tabloyu sağa kaydırın →
| Metin | Kelimeler | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| İngilizce paragraf, 254 karakter | 53 | 60 token | 60 token |
| Aynı paragrafın Rusçası, 255 karakter | 42 | 73 token | 65 token |
İngilizce metin için kelime başına yaklaşık 1,1–1,2 token makul bir tahmindir. Diğer yazı sistemleri genellikle daha pahalıya gelir: Rusça sürüm aynı şeyi daha az kelimeyle söyler ama DeepSeek'in tokenizer'ıyla yaklaşık %20 daha fazla token alır.
Bunları pratik kurallar olarak alın. Her model ailesinin kendi tokenizer'ı vardır ve metniniz için kesin sayı, API'nin geri bildirdiği sayıdır.
Ödediğiniz şey tokenlardır#
API fiyatları, girdi ve çıktı için ayrı ayrı, milyon token başına verilir:
- girdi tokenları — gönderdiğiniz her şey: sistem istemi, sohbet geçmişi, belgeler ve sorunuz;
- çıktı tokenları — modelin geri yazdığı her şey, yanıtlamadan önce akıl yürütüyorsa akıl yürütmesi dahil.
Bir isteğin maliyeti, girdi tokenları × girdi fiyatı + çıktı tokenları × çıktı fiyatıdır.
İki pratik sonuç. Uzun bir sohbet her mesajla daha pahalı hale gelir, çünkü tüm geçmiş her seferinde modele girdi olarak geri gider. Ve çıktı genellikle token başına girdiden birkaç kat daha pahalıdır, bu yüzden daha kısa yanıtlar istemek gerçek para tasarrufu sağlar.
İnsanların "token" dediği dört şey#
Kelime aşırı yüklü, bu yüzden onu aramak bu kadar kafa karıştırıcı:
Tabloyu sağa kaydırın →
| Gördüğünüz yer | Anlamı |
|---|---|
| Bir modelin sınırları veya fiyatları | Yukarıda açıklandığı gibi metin parçaları |
| "API token", "access token" | Kodunuzun API'yi çağırmasını sağlayan gizli anahtar. Sizi tanımlar; ön ödemeli bir metin miktarı değildir |
| Bir sohbet uygulamasının içindeki tokenlar | Genellikle uygulamanın kendi kredileridir. Model tokenlarıyla ilişkileri uygulamaya bağlıdır |
| Kripto tokenları | Dil modelleriyle ilgisi olmayan bir blokzincir varlığı |
"token nedir…" gibi bir sınav sorusunu yanıtlıyorsanız, dil modelleri için doğru yanıt bir metin parçasıdır: bir kelime, bir kelimenin parçası veya bir simge.
Neden "yeterli token yok" görebilirsiniz#
Aynı ifade dört farklı soruna işaret edebilir ve bunlardan yalnızca biri parayla ilgilidir:
- İstem bağlam penceresine sığmıyor. Her modelin girdi artı çıktı üzerinde bir sınırı vardır. CheapTokens'te bu, DeepSeek-V4-Flash için 380.000 token, GLM-5.3-Flash için 390.000 ve MiniMax-M2.7 için 200.000'dir. Geçmişi kısaltın veya belgeyi bölün.
- Yanıt çıktı sınırına takıldı. Yanıt cümle ortasında durur. Modelin maksimumu içinde
max_tokensdeğerini yükseltin ya da daha kısa bir yanıt isteyin. - Bakiye tükendi. Bunu yalnızca bakiye yüklemek düzeltir.
- Uygulamanın kendi sınırı var. Sohbet hizmetleri genellikle kullanımı modelin kendisiyle ilgisiz kendi kurallarıyla sınırlar.
Kendi metninizdeki tokenları nasıl sayarsınız#
En güvenilir sayı API'den gelir: her yanıt, prompt_tokens ve completion_ içeren bir usage bloğu içerir.
Göndermeden önce tahmin etmek için modelin tokenizer'ını yerel olarak çalıştırın. Açık modeller tokenizer'larını ağırlıkların yanında yayımlar. Bu kod parçası örnek cümleyi DeepSeek-V4-Flash-0731 tokenizer'ıyla sayar:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
OpenAI modelleri için tiktoken kütüphanesi vardır. Bir tokenizer'dan alınan sayının başka herhangi bir model için yalnızca bir tahmin olduğunu unutmayın.
Sıradaki adımınız#
Bir bütçe tahmin etmek için tipik bir istem ve yanıt boyutu alın ve milyon token başına fiyatla çarpın. ABD doları cinsinden sabitlenmiş güncel CheapTokens fiyatları:
| Model | Bağlam | Giriş $/1M | Çıkış $/1M | OpenRouter giriş | OpenRouter çıkış |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning geçici olarak kullanılamıyor | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash geçici olarak kullanılamıyor | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 geçici olarak kullanılamıyor | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Fiyatlar 1M token başına USD cinsindendir. OpenRouter rakamları karşılaştırma amaçlı gösterilmiştir ve değişebilir.


