AI 입문가이드
AI에서 토큰이란? 쉬운 영어로 설명
토큰은 AI 모델이 읽고 쓰는 텍스트 조각입니다. 실제 토크나이저가 문장을 나누는 방식, 단어 하나에 토큰이 몇 개 필요한지, 토큰이 어떻게 청구서가 되는지 알아보세요.
이 페이지의 내용
토큰은 언어 모델이 다루는 작은 텍스트 조각입니다. 단어 전체, 단어의 일부, 구두점, 또는 앞의 공백까지 포함한 단어일 수 있습니다. 모델은 프롬프트를 토큰으로 읽고, 답변을 토큰으로 쓰며, AI API는 토큰 단위로 과금합니다. 그래서 "이건 토큰이 몇 개인가"라는 질문은 사실 두 가지 질문입니다. 들어갈 수 있는가, 그리고 비용이 얼마인가.
모델이 텍스트를 토큰으로 자르는 방법#
모델이 텍스트를 보기 전에, 토크나이저가 고정된 어휘에서 조각들을 잘라내고 각 조각을 숫자로 바꿉니다. 자주 쓰이는 단어는 보통 하나의 토큰이 됩니다. 드물고 긴 단어는 여러 부분으로 나뉩니다.
실제 예시가 있습니다. 한 문장을 두 개의 토크나이저, 즉 DeepSeek-V4-Flash-0731과 함께 공개된 토크나이저와 OpenAI의 o200k_base 인코딩에 통과시켰습니다.
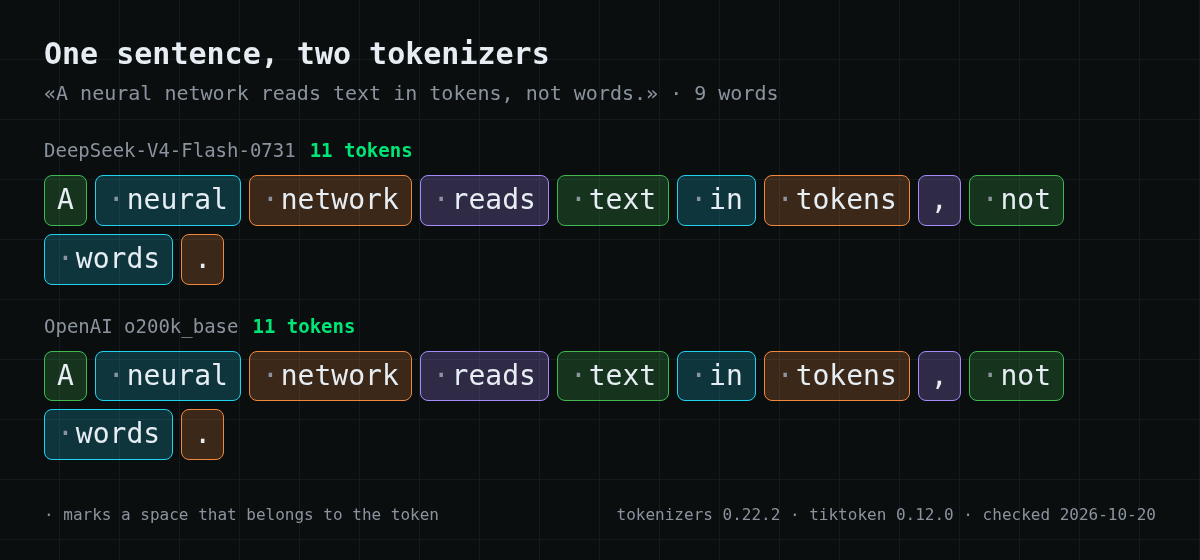
영어에서는 두 토크나이저가 일치합니다. 9개의 단어, 11개의 토큰입니다. 쉼표와 마침표는 각각 별도의 토큰이고, 대부분의 단어는 앞의 공백을 함께 가집니다.
긴 단어에서 토크나이저가 달라지기 시작합니다. "tokenization"은 둘 다에서 두 개의 토큰입니다: token + ization. 러시아어 단어 «токенизация»는 DeepSeek에서는 세 개, OpenAI에서는 네 개의 토큰입니다. 같은 단어, 다른 개수입니다.
한 단어는 토큰이 몇 개인가#
토큰에 관한 짧은 문단으로 영어와 러시아어에서 빠르게 테스트한 결과입니다:
표를 오른쪽으로 스크롤하세요 →
| 텍스트 | 단어 | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| 영어 문단, 254자 | 53 | 60 토큰 | 60 토큰 |
| 같은 문단의 러시아어 버전, 255자 | 42 | 73 토큰 | 65 토큰 |
영어 텍스트의 경우 단어당 약 1.1–1.2 토큰이 합리적인 추정치입니다. 다른 문자 체계는 보통 더 많이 듭니다. 러시아어 버전은 같은 내용을 더 적은 단어로 말하지만 DeepSeek의 토크나이저에서는 약 20% 더 많은 토큰을 사용합니다.
이것들은 경험 법칙으로 여기세요. 모든 모델 계열은 자체 토크나이저를 가지고 있으며, 여러분의 텍스트에 대한 정확한 개수는 API가 돌려주는 값입니다.
토큰은 곧 지불하는 대상입니다#
API 가격은 백만 토큰당으로, 입력과 출력에 대해 각각 따로 책정됩니다:
- 입력 토큰 — 보내는 모든 것: 시스템 프롬프트, 채팅 기록, 문서, 그리고 질문;
- 출력 토큰 — 모델이 되돌려 쓰는 모든 것, 답변 전에 추론한다면 그 추론도 포함.
요청 비용은 입력 토큰 × 입력 가격 + 출력 토큰 × 출력 가격입니다.
실용적인 결과 두 가지. 긴 채팅은 메시지마다 더 비싸집니다. 매번 전체 기록이 입력으로 모델에 다시 전달되기 때문입니다. 그리고 출력은 보통 토큰당 입력보다 몇 배 더 비쌉니다. 그래서 더 짧은 답변을 요청하면 실제로 돈이 절약됩니다.
사람들이 "토큰"이라고 부르는 네 가지#
이 단어는 의미가 겹쳐 있어서, 검색하면 혼란스러운 이유입니다:
표를 오른쪽으로 스크롤하세요 →
| 어디서 봤는지 | 의미 |
|---|---|
| 모델의 한도나 가격 | 위에서 설명한 텍스트 조각 |
| "API 토큰", "액세스 토큰" | 코드가 API를 호출할 수 있게 해주는 비밀 키. 여러분을 식별하며, 미리 결제된 텍스트 양이 아닙니다 |
| 채팅 앱 안의 토큰 | 흔히 앱 자체의 크레딧. 모델 토큰과의 관계는 앱에 달려 있습니다 |
| 암호화폐 토큰 | 언어 모델과 무관한 블록체인 자산 |
"토큰이란…" 같은 퀴즈 문제에 답한다면, 언어 모델의 경우 정답은 텍스트 조각입니다: 단어, 단어의 일부 또는 기호.
"토큰이 부족하다"는 메시지를 볼 수 있는 이유#
같은 문구가 네 가지 다른 문제를 가리킬 수 있으며, 그중 하나만 돈에 관한 것입니다:
- 프롬프트가 컨텍스트 윈도에 들어가지 않습니다. 모든 모델은 입력과 출력을 합친 한도가 있습니다. CheapTokens에서는 DeepSeek-V4-Flash가 380,000 토큰, GLM-5.3-Flash가 390,000, MiniMax-M2.7이 200,000입니다. 기록을 줄이거나 문서를 나누세요.
- 답변이 출력 한도에 걸렸습니다. 답변이 문장 중간에 멈춥니다. 모델의 최댓값 안에서
max_tokens을 높이거나, 더 짧은 답변을 요청하세요. - 잔액이 바닥났습니다. 충전으로 해결되는 유일한 경우입니다.
- 앱에 자체 한도가 있습니다. 채팅 서비스는 흔히 모델 자체와 무관한 자체 규칙으로 사용량을 제한합니다.
자신의 텍스트에서 토큰을 세는 방법#
가장 신뢰할 수 있는 숫자는 API에서 나옵니다. 모든 응답에는 prompt_tokens과 completion_가 담긴 usage 블록이 포함됩니다.
보내기 전에 추정하려면 모델의 토크나이저를 로컬에서 실행하세요. 오픈 모델은 가중치 옆에 토크나이저를 공개합니다. 이 스니펫은 DeepSeek-V4-Flash-0731 토크나이저로 예시 문장을 세는 코드입니다:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
OpenAI 모델에는 tiktoken 라이브러리가 있습니다. 한 토크나이저의 개수는 다른 모델에 대해서는 추정치일 뿐이라는 점을 기억하세요.
다음 단계#
예산을 추정하려면, 일반적인 프롬프트와 답변 크기를 잡고 백만 토큰당 가격을 곱하세요. 미국 달러로 고정된 현재 CheapTokens 가격:
| 모델 | 컨텍스트 | 입력 $/1M | 출력 $/1M | OpenRouter 입력 | OpenRouter 출력 |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning 일시적으로 사용할 수 없습니다 | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash 일시적으로 사용할 수 없습니다 | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 일시적으로 사용할 수 없습니다 | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
가격은 100만 토큰당 USD 기준입니다. OpenRouter 수치는 비교를 위해 표시되었으며 변경될 수 있습니다.


