AI per principiantiGuida
Cos'è un token nell'AI? Una spiegazione in parole semplici
Un token è il pezzo di testo che un modello AI legge e scrive. Scopri come un tokenizer reale divide una frase, quanti token richiede una parola e come i token diventano una fattura.
In questa pagina
Un token è un piccolo pezzo di testo con cui lavora un modello linguistico: una parola intera, parte di una parola, un segno di punteggiatura o una parola insieme allo spazio che la precede. I modelli leggono il tuo prompt come token, scrivono la risposta come token e le API di AI fatturano per token. Quindi "quanti token sono" è in realtà due domande: ci starà e quanto costerà.
Come un modello taglia il testo in token#
Prima che un modello veda il tuo testo, un tokenizer lo divide in pezzi da un vocabolario fisso e trasforma ogni pezzo in un numero. Le parole frequenti di solito ricevono un singolo token. Le parole rare e lunghe vengono divise in parti.
Ecco un esempio reale. Abbiamo fatto passare una frase attraverso due tokenizer: quello pubblicato con DeepSeek-V4-Flash-0731 e la codifica o200k_base di OpenAI.
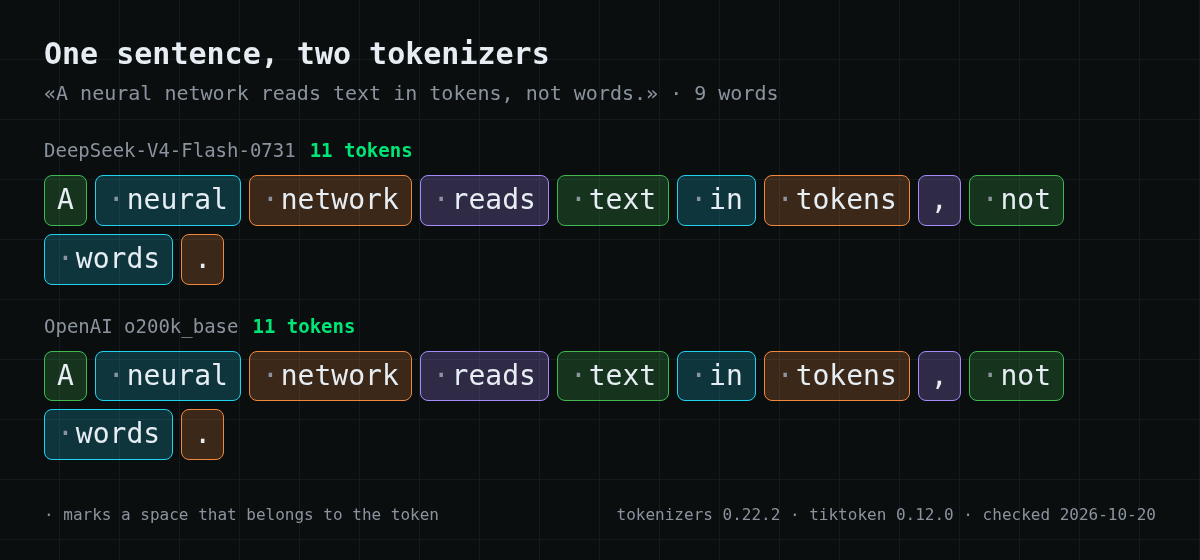
In inglese entrambi i tokenizer concordano: 9 parole, 11 token. La virgola e il punto sono token a sé stanti, e la maggior parte delle parole porta con sé lo spazio che le precede.
Le parole lunghe sono il punto in cui i tokenizer iniziano a differire. "tokenization" è due token in entrambi: token + ization. La parola russa «токенизация» è tre token per DeepSeek e quattro per OpenAI. Stessa parola, conteggio diverso.
Quanti token è una parola#
Un rapido test con un breve paragrafo sui token, in inglese e in russo:
Scorri la tabella verso destra →
| Testo | Parole | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Paragrafo in inglese, 254 caratteri | 53 | 60 token | 60 token |
| Lo stesso paragrafo in russo, 255 caratteri | 42 | 73 token | 65 token |
Per il testo inglese, circa 1,1–1,2 token per parola è una stima ragionevole. Altri sistemi di scrittura di solito costano di più: la versione russa dice la stessa cosa in meno parole ma richiede circa il 20% di token in più con il tokenizer di DeepSeek.
Considerale regole empiriche. Ogni famiglia di modelli ha il proprio tokenizer, e il conteggio esatto per il tuo testo è quello che l'API restituisce.
I token sono ciò per cui paghi#
I prezzi delle API sono indicati per milione di token, separatamente per input e output:
- token di input — tutto ciò che invii: il prompt di sistema, la cronologia della chat, i documenti e la tua domanda;
- token di output — tutto ciò che il modello scrive in risposta, incluso il suo ragionamento se il modello ragiona prima di rispondere.
Il costo di una richiesta è token di input × prezzo di input + token di output × prezzo di output.
Due conseguenze pratiche. Una chat lunga diventa più costosa a ogni messaggio, perché l'intera cronologia viene rimandata al modello come input ogni volta. E l'output di solito costa diverse volte di più per token rispetto all'input, quindi chiedere risposte più brevi fa risparmiare davvero.
Quattro cose che la gente chiama "token"#
La parola è sovraccarica, ed è per questo che cercarla è così confuso:
Scorri la tabella verso destra →
| Dove l'hai visto | Cosa significa |
|---|---|
| Limiti o prezzi di un modello | Pezzi di testo, come descritto sopra |
| "API token", "access token" | Una chiave segreta che permette al tuo codice di chiamare l'API. Ti identifica; non è una quantità prepagata di testo |
| Token all'interno di un'app di chat | Spesso i crediti dell'app stessa. Come si rapportano ai token del modello dipende dall'app |
| Token crypto | Un asset blockchain, senza relazione con i modelli linguistici |
Se stai rispondendo a una domanda di un quiz come "un token è…", per i modelli linguistici la risposta giusta è un pezzo di testo: una parola, parte di una parola o un simbolo.
Perché potresti vedere "token insufficienti"#
La stessa frase può indicare quattro problemi diversi, e solo uno riguarda il denaro:
- Il prompt non entra nella finestra di contesto. Ogni modello ha un limite su input più output. Su CheapTokens è 380.000 token per DeepSeek-V4-Flash, 390.000 per GLM-5.3-Flash e 200.000 per MiniMax-M2.7. Accorcia la cronologia o dividi il documento.
- La risposta ha raggiunto il limite di output. La risposta si interrompe a metà frase. Aumenta
max_tokensentro il massimo del modello, o chiedi una risposta più breve. - Il saldo è esaurito. Questo è l'unico caso in cui ricaricare risolve.
- L'app ha un proprio limite. I servizi di chat spesso limitano l'uso secondo le proprie regole, indipendentemente dal modello stesso.
Come contare i token nel tuo testo#
Il numero più affidabile viene dall'API: ogni risposta include un blocco usage con prompt_tokens e completion_.
Per stimare prima di inviare, esegui localmente il tokenizer del modello. I modelli aperti pubblicano il loro tokenizer accanto ai pesi. Questo snippet conta la frase di esempio con il tokenizer DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Per i modelli OpenAI c'è la libreria tiktoken. Tieni presente che un conteggio da un tokenizer è solo una stima per qualsiasi altro modello.
Il tuo prossimo passo#
Per stimare un budget, prendi una dimensione tipica di prompt e risposta e moltiplicala per il prezzo per milione di token. Prezzi attuali di CheapTokens, fissati in dollari USA:
| Modello | Contesto | Input $/1M | Output $/1M | OpenRouter in | OpenRouter out |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning temporaneamente non disponibile | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash temporaneamente non disponibile | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 temporaneamente non disponibile | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Prezzi in USD per 1M di token. Le cifre di OpenRouter sono mostrate a scopo di confronto e potrebbero variare.


