AI untuk pemulaPanduan
Apa itu token dalam AI? Penjelasan dengan bahasa sederhana
Token adalah potongan teks yang dibaca dan ditulis model AI. Lihat bagaimana tokenizer nyata memecah kalimat, berapa token untuk satu kata, dan bagaimana token menjadi tagihan.
Di halaman ini
Token adalah potongan kecil teks yang diproses oleh model bahasa: satu kata utuh, bagian dari kata, tanda baca, atau kata beserta spasi di depannya. Model membaca prompt Anda sebagai token, menulis jawaban sebagai token, dan API AI menagih berdasarkan token. Jadi "berapa token ini" sebenarnya adalah dua pertanyaan: apakah muat, dan berapa biayanya.
Bagaimana model memotong teks menjadi token#
Sebelum model melihat teks Anda, tokenizer memecahnya menjadi potongan-potongan dari kosakata tetap dan mengubah setiap potongan menjadi angka. Kata yang sering muncul biasanya mendapat satu token. Kata yang jarang dan panjang dipecah menjadi beberapa bagian.
Berikut contoh nyata. Kami menjalankan satu kalimat melalui dua tokenizer: yang diterbitkan bersama DeepSeek-V4-Flash-0731 dan encoding o200k_base dari OpenAI.
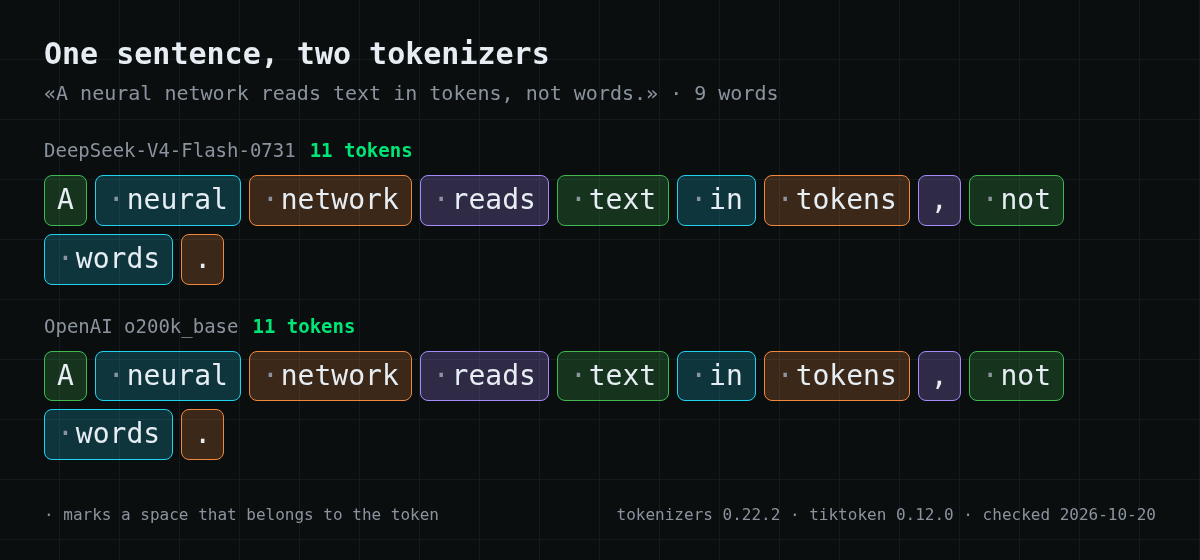
Dalam bahasa Inggris kedua tokenizer sepakat: 9 kata, 11 token. Koma dan titik adalah token tersendiri, dan sebagian besar kata membawa spasi di depannya.
Kata panjang adalah titik di mana tokenizer mulai berbeda. "tokenization" menjadi dua token di keduanya: token + ization. Kata Rusia «токенизация» menjadi tiga token untuk DeepSeek dan empat untuk OpenAI. Kata yang sama, jumlah berbeda.
Berapa token untuk satu kata#
Uji cepat dengan paragraf pendek tentang token, dalam bahasa Inggris dan Rusia:
Gulir tabel ke kanan →
| Teks | Kata | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Paragraf bahasa Inggris, 254 karakter | 53 | 60 token | 60 token |
| Paragraf yang sama dalam bahasa Rusia, 255 karakter | 42 | 73 token | 65 token |
Untuk teks bahasa Inggris, sekitar 1,1–1,2 token per kata adalah perkiraan yang wajar. Aksara lain biasanya lebih mahal: versi bahasa Rusia mengatakan hal yang sama dengan kata lebih sedikit tetapi memakan sekitar 20% lebih banyak token dengan tokenizer DeepSeek.
Anggap ini sebagai aturan praktis. Setiap keluarga model memiliki tokenizer sendiri, dan jumlah pasti untuk teks Anda adalah yang dilaporkan kembali oleh API.
Token adalah yang Anda bayar#
Harga API dikutip per juta token, terpisah untuk input dan output:
- token input — semua yang Anda kirim: system prompt, riwayat chat, dokumen, dan pertanyaan Anda;
- token output — semua yang ditulis model kembali, termasuk penalarannya jika model bernalar sebelum menjawab.
Biaya satu permintaan adalah token input × harga input + token output × harga output.
Dua konsekuensi praktis. Chat yang panjang menjadi lebih mahal dengan setiap pesan, karena seluruh riwayat dikirim kembali ke model sebagai input setiap kali. Dan output biasanya berbiaya beberapa kali lebih mahal per token daripada input, jadi meminta jawaban yang lebih pendek menghemat uang secara nyata.
Empat hal yang orang sebut "token"#
Kata ini bermakna ganda, itulah sebabnya mencarinya sangat membingungkan:
Gulir tabel ke kanan →
| Di mana Anda melihatnya | Artinya |
|---|---|
| Batas atau harga model | Potongan teks, seperti dijelaskan di atas |
| "API token", "access token" | Kunci rahasia yang memungkinkan kode Anda memanggil API. Ini mengidentifikasi Anda; ini bukan jumlah teks prabayar |
| Token di dalam aplikasi chat | Sering kali kredit milik aplikasi itu sendiri. Hubungannya dengan token model tergantung aplikasinya |
| Token kripto | Aset blockchain, tidak terkait dengan model bahasa |
Jika Anda menjawab pertanyaan kuis seperti "token adalah…", untuk model bahasa jawaban yang benar adalah potongan teks: sebuah kata, bagian dari kata, atau simbol.
Mengapa Anda mungkin melihat "token tidak cukup"#
Frasa yang sama bisa menunjuk ke empat masalah berbeda, dan hanya satu di antaranya tentang uang:
- Prompt tidak muat ke dalam context window. Setiap model memiliki batas untuk input ditambah output. Di CheapTokens batasnya 380.000 token untuk DeepSeek-V4-Flash, 390.000 untuk GLM-5.3-Flash, dan 200.000 untuk MiniMax-M2.7. Perpendek riwayat atau pisahkan dokumen.
- Jawaban mencapai batas output. Balasan berhenti di tengah kalimat. Naikkan
max_tokensdalam batas maksimum model, atau minta jawaban yang lebih pendek. - Saldo habis. Ini satu-satunya kasus di mana mengisi saldo memperbaikinya.
- Aplikasi memiliki batasnya sendiri. Layanan chat sering membatasi penggunaan dengan aturan mereka sendiri, tidak terkait dengan model itu sendiri.
Cara menghitung token dalam teks Anda sendiri#
Angka paling andal berasal dari API: setiap respons menyertakan blok usage dengan prompt_tokens dan completion_.
Untuk memperkirakan sebelum mengirim, jalankan tokenizer model secara lokal. Model terbuka menerbitkan tokenizer mereka bersama bobotnya. Cuplikan ini menghitung kalimat contoh dengan tokenizer DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Untuk model OpenAI ada pustaka tiktoken. Ingatlah bahwa hitungan dari satu tokenizer hanya perkiraan untuk model lain mana pun.
Langkah Anda berikutnya#
Untuk memperkirakan anggaran, ambil prompt dan ukuran jawaban yang tipikal dan kalikan dengan harga per juta token. Harga CheapTokens saat ini, dalam dolar AS tetap:
| Model | Konteks | Input $/1Jt | Output $/1Jt | OpenRouter in | OpenRouter out |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning untuk sementara tidak tersedia | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash untuk sementara tidak tersedia | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 untuk sementara tidak tersedia | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Harga dalam USD per 1 juta token. Angka OpenRouter ditampilkan sebagai perbandingan dan dapat berubah sewaktu-waktu.


