الذكاء الاصطناعي للمبتدئيندليل
ما هو الرمز (token) في الذكاء الاصطناعي؟ شرح بلغة واضحة
الرمز هو قطعة النص التي يقرأها ويكتبها نموذج الذكاء الاصطناعي. شاهد كيف يقسم مُرمِّز حقيقي جملة، وكم رمزاً تستهلك الكلمة، وكيف تتحول الرموز إلى فاتورة.
في هذه الصفحة
الرمز (token) هو قطعة صغيرة من النص يعمل بها نموذج اللغة: كلمة كاملة، أو جزء من كلمة، أو علامة ترقيم، أو كلمة مع المسافة التي تسبقها. تقرأ النماذج طلبك كرموز، وتكتب الإجابة كرموز، وتحتسب واجهات برمجة تطبيقات الذكاء الاصطناعي الفاتورة حسب الرمز. لذا فإن سؤال "كم عدد الرموز في هذا" هو في الحقيقة سؤالان: هل سيتسع، وكم سيكلف.
كيف يجزئ النموذج النص إلى رموز#
قبل أن يرى النموذج نصك، يقوم المُرمِّز (tokenizer) بتجزئته إلى قطع من مفردات ثابتة ويحوّل كل قطعة إلى رقم. عادةً ما تحصل الكلمات الشائعة على رمز واحد. أما الكلمات النادرة والطويلة فتُجزأ إلى أجزاء.
إليك مثالاً حقيقياً. مرّرنا جملة واحدة عبر مُرمِّزين: المُرمِّز المنشور مع DeepSeek-V4-Flash-0731 وترميز OpenAI o200k_base.
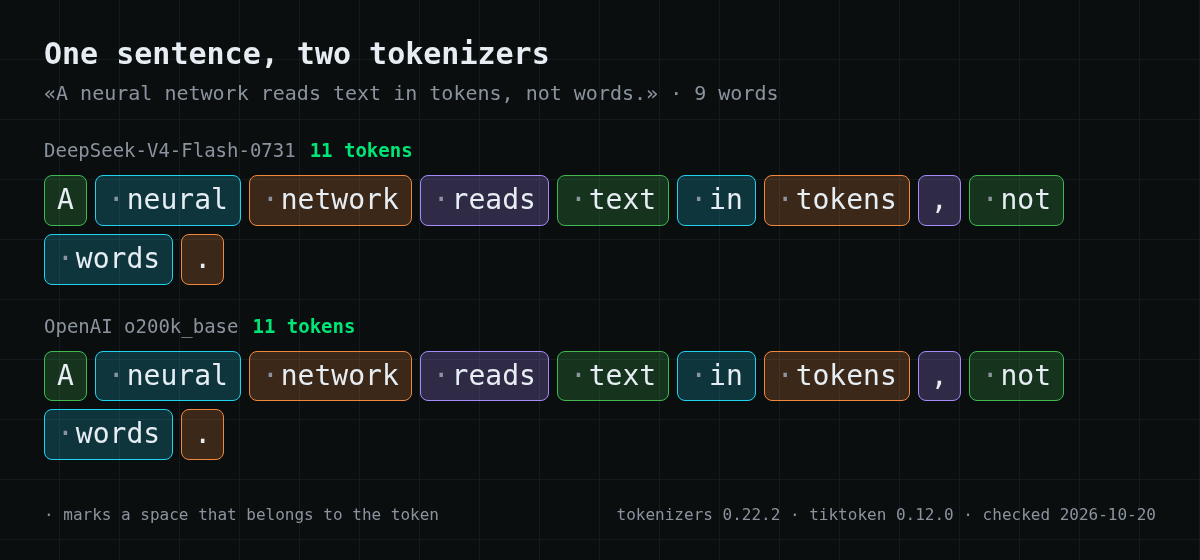
في الإنجليزية يتفق المُرمِّزان: 9 كلمات، 11 رمزاً. الفاصلة والنقطة رمزان مستقلان، ومعظم الكلمات تحمل المسافة التي تسبقها.
الكلمات الطويلة هي حيث يبدأ المُرمِّزون في الاختلاف. "tokenization" رمزان في كليهما: token + ization. الكلمة الروسية «токенизация» هي ثلاثة رموز لـ DeepSeek وأربعة لـ OpenAI. نفس الكلمة، عدد مختلف.
كم عدد الرموز في الكلمة#
اختبار سريع بفقرة قصيرة عن الرموز، بالإنجليزية والروسية:
قم بتمرير الجدول لليمين →
| النص | الكلمات | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| فقرة إنجليزية، 254 حرفاً | 53 | 60 رمزاً | 60 رمزاً |
| نفس الفقرة بالروسية، 255 حرفاً | 42 | 73 رمزاً | 65 رمزاً |
بالنسبة للنص الإنجليزي، فإن حوالي 1.1–1.2 رمز لكل كلمة هو تقدير معقول. عادةً ما تكلف الكتابات الأخرى أكثر: النسخة الروسية تقول الشيء نفسه بكلمات أقل لكنها تستهلك حوالي 20% رموزاً أكثر مع مُرمِّز DeepSeek.
اعتبر هذه قواعد تقريبية. كل عائلة نماذج لها مُرمِّزها الخاص، والعدد الدقيق لنصك هو ما تعيده واجهة البرمجة.
الرموز هي ما تدفع مقابله#
تُسعَّر واجهات البرمجة لكل مليون رمز، بشكل منفصل للمدخلات والمخرجات:
- رموز المدخلات — كل ما ترسله: موجه النظام، وسجل المحادثة، والمستندات، وسؤالك؛
- رموز المخرجات — كل ما يكتبه النموذج رداً، بما في ذلك استدلاله إذا كان النموذج يستدل قبل الإجابة.
تكلفة الطلب هي رموز المدخلات × سعر المدخلات + رموز المخرجات × سعر المخرجات.
نتيجتان عمليتان. المحادثة الطويلة تصبح أكثر تكلفة مع كل رسالة، لأن السجل الكامل يعود إلى النموذج كمدخلات في كل مرة. وعادةً ما تكلف المخرجات عدة أضعاف المدخلات لكل رمز، لذا فإن طلب إجابات أقصر يوفر مالاً حقيقياً.
أربعة أشياء يسميها الناس "رمزاً"#
الكلمة محمّلة بأكثر من معنى، ولهذا يكون البحث عنها مربكاً جداً:
قم بتمرير الجدول لليمين →
| أين رأيتها | ماذا تعني |
|---|---|
| حدود النموذج أو أسعاره | قطع من النص، كما هو موضح أعلاه |
| "API token"، "access token" | مفتاح سري يتيح لكودك استدعاء واجهة البرمجة. يحدد هويتك؛ وليس كمية نص مدفوعة مسبقاً |
| الرموز داخل تطبيق محادثة | غالباً أرصدة التطبيق نفسه. وعلاقتها برموز النموذج متروكة للتطبيق |
| رموز العملات المشفرة | أصل على سلسلة الكتل، لا علاقة له بنماذج اللغة |
إذا كنت تجيب على سؤال اختبار مثل "الرمز هو…"، فبالنسبة لنماذج اللغة الإجابة الصحيحة هي قطعة من النص: كلمة، أو جزء من كلمة، أو رمز.
لماذا قد ترى "رموز غير كافية"#
يمكن أن تشير العبارة نفسها إلى أربع مشكلات مختلفة، وواحدة فقط منها تتعلق بالمال:
- الطلب لا يتسع في نافذة السياق. لكل نموذج حد للمدخلات بالإضافة إلى المخرجات. في CheapTokens يبلغ 380,000 رمز لـ DeepSeek-V4-Flash، و 390,000 لـ GLM-5.3-Flash، و 200,000 لـ MiniMax-M2.7. اختصر السجل أو قسّم المستند.
- الإجابة بلغت حد المخرجات. يتوقف الرد في منتصف الجملة. ارفع
max_tokensضمن الحد الأقصى للنموذج، أو اطلب إجابة أقصر. - نفد الرصيد. هذه هي الحالة الوحيدة التي يعالجها الشحن.
- التطبيق له حده الخاص. غالباً ما تضع خدمات المحادثة سقفاً للاستخدام بقواعدها الخاصة، بمعزل عن النموذج نفسه.
كيف تحسب الرموز في نصك#
الرقم الأكثر موثوقية يأتي من واجهة البرمجة: كل استجابة تتضمن كتلة usage مع prompt_tokens و completion_.
للتقدير قبل الإرسال، شغّل مُرمِّز النموذج محلياً. تنشر النماذج المفتوحة مُرمِّزها بجانب الأوزان. هذه القطعة تحسب الجملة المثال بمُرمِّز DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
بالنسبة لنماذج OpenAI توجد مكتبة tiktoken. ضع في اعتبارك أن العد من مُرمِّز واحد هو مجرد تقدير لأي نموذج آخر.
خطوتك التالية#
لتقدير الميزانية، خذ طلباً نموذجياً وحجم إجابة نموذجياً واضربه في السعر لكل مليون رمز. أسعار CheapTokens الحالية، مثبتة بالدولار الأمريكي:
| النموذج | السياق | الإدخال $/1M | الإخراج $/1M | OpenRouter إدخال | OpenRouter إخراج |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning غير متاح مؤقتاً | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash غير متاح مؤقتاً | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 غير متاح مؤقتاً | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
الأسعار بالدولار الأمريكي لكل مليون رمز (token). أرقام OpenRouter معروضة للمقارنة وقد تتغير.


