KI für EinsteigerAnleitung
Was ist ein Token in der KI? Eine einfach erklärte Antwort
Ein Token ist das Stück Text, das ein KI-Modell liest und schreibt. Sieh, wie ein echter Tokenizer einen Satz zerlegt, wie viele Tokens ein Wort braucht und wie Tokens zu einer Rechnung werden.
Auf dieser Seite
Ein Token ist ein kleines Stück Text, mit dem ein Sprachmodell arbeitet: ein ganzes Wort, ein Teil eines Wortes, ein Satzzeichen oder ein Wort zusammen mit dem Leerzeichen davor. Modelle lesen deinen Prompt als Tokens, schreiben die Antwort als Tokens, und KI-APIs rechnen pro Token ab. Die Frage „Wie viele Tokens ist das“ ist also eigentlich zwei Fragen: Passt es hinein, und was wird es kosten.
Wie ein Modell Text in Tokens zerlegt#
Bevor ein Modell deinen Text sieht, zerlegt ein Tokenizer ihn in Stücke aus einem festen Vokabular und wandelt jedes Stück in eine Zahl um. Häufige Wörter bekommen meist ein einzelnes Token. Seltene und lange Wörter werden in Teile zerlegt.
Hier ist ein echtes Beispiel. Wir haben einen Satz durch zwei Tokenizer geschickt: den, der mit DeepSeek-V4-Flash-0731 veröffentlicht wurde, und OpenAIs o200k_base-Encoding.
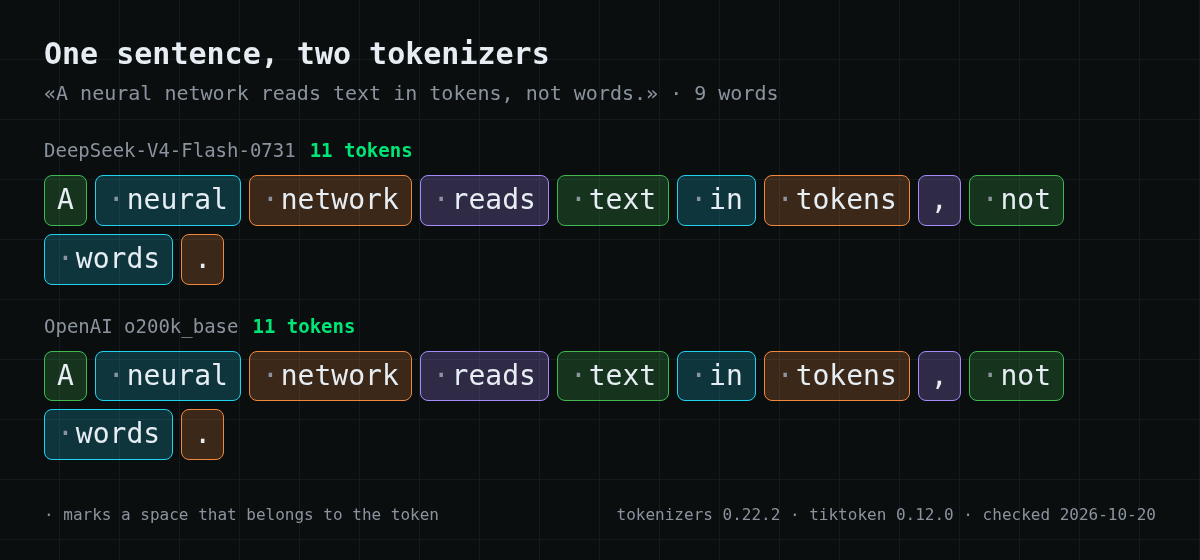
Im Englischen sind sich beide Tokenizer einig: 9 Wörter, 11 Tokens. Das Komma und der Punkt sind eigene Tokens, und die meisten Wörter tragen das Leerzeichen vor sich.
Bei langen Wörtern beginnen Tokenizer sich zu unterscheiden. „tokenization“ sind in beiden zwei Tokens: token + ization. Das russische Wort «токенизация» sind drei Tokens für DeepSeek und vier für OpenAI. Dasselbe Wort, unterschiedliche Anzahl.
Wie viele Tokens ein Wort ist#
Ein schneller Test mit einem kurzen Absatz über Tokens, auf Englisch und auf Russisch:
Tabelle nach rechts scrollen →
| Text | Wörter | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Englischer Absatz, 254 Zeichen | 53 | 60 Tokens | 60 Tokens |
| Derselbe Absatz auf Russisch, 255 Zeichen | 42 | 73 Tokens | 65 Tokens |
Für englischen Text ist etwa 1,1–1,2 Tokens pro Wort eine faire Schätzung. Andere Schriftsysteme kosten meist mehr: Die russische Version sagt dasselbe in weniger Wörtern, braucht aber mit DeepSeeks Tokenizer etwa 20 % mehr Tokens.
Betrachte das als Faustregeln. Jede Modellfamilie hat ihren eigenen Tokenizer, und die genaue Anzahl für deinen Text ist die, die die API zurückmeldet.
Tokens sind das, wofür du bezahlst#
API-Preise werden pro Million Tokens angegeben, getrennt für Input und Output:
- Input-Tokens — alles, was du sendest: der System-Prompt, der Chat-Verlauf, Dokumente und deine Frage;
- Output-Tokens — alles, was das Modell zurückschreibt, einschließlich seiner Überlegungen, wenn das Modell vor der Antwort nachdenkt.
Die Kosten einer Anfrage sind Input-Tokens × Input-Preis + Output-Tokens × Output-Preis.
Zwei praktische Konsequenzen. Ein langer Chat wird mit jeder Nachricht teurer, weil der gesamte Verlauf jedes Mal als Input zurück ans Modell geht. Und Output kostet pro Token meist ein Vielfaches von Input, also spart das Bitten um kürzere Antworten echtes Geld.
Vier Dinge, die man „Token“ nennt#
Das Wort ist überladen, weshalb die Suche danach so verwirrend ist:
Tabelle nach rechts scrollen →
| Wo du es gesehen hast | Was es bedeutet |
|---|---|
| Limits oder Preise eines Modells | Textstücke, wie oben beschrieben |
| „API-Token“, „Access Token“ | Ein geheimer Schlüssel, mit dem dein Code die API aufrufen kann. Er identifiziert dich; er ist keine vorausbezahlte Textmenge |
| Tokens in einer Chat-App | Oft die eigenen Credits der App. Wie sie sich zu Modell-Tokens verhalten, liegt an der App |
| Krypto-Tokens | Ein Blockchain-Asset, ohne Bezug zu Sprachmodellen |
Wenn du eine Quizfrage wie „ein Token ist…“ beantwortest, ist für Sprachmodelle die richtige Antwort ein Stück Text: ein Wort, ein Teil eines Wortes oder ein Symbol.
Warum du „nicht genug Tokens“ sehen könntest#
Dieselbe Formulierung kann auf vier verschiedene Probleme hinweisen, und nur eines davon betrifft Geld:
- Der Prompt passt nicht ins Kontextfenster. Jedes Modell hat ein Limit für Input plus Output. Bei CheapTokens sind es 380.000 Tokens für DeepSeek-V4-Flash, 390.000 für GLM-5.3-Flash und 200.000 für MiniMax-M2.7. Kürze den Verlauf oder teile das Dokument auf.
- Die Antwort hat das Output-Limit erreicht. Die Antwort bricht mitten im Satz ab. Erhöhe
max_tokensinnerhalb des Modell-Maximums oder bitte um eine kürzere Antwort. - Das Guthaben ist aufgebraucht. Das ist der einzige Fall, in dem Aufladen das Problem löst.
- Die App hat ihr eigenes Limit. Chat-Dienste begrenzen die Nutzung oft nach eigenen Regeln, unabhängig vom Modell selbst.
Wie du Tokens in deinem eigenen Text zählst#
Die zuverlässigste Zahl kommt von der API: Jede Antwort enthält einen usage-Block mit prompt_tokens und completion_.
Um vor dem Senden zu schätzen, führe den Tokenizer des Modells lokal aus. Offene Modelle veröffentlichen ihren Tokenizer neben den Gewichten. Dieses Snippet zählt den Beispielsatz mit dem DeepSeek-V4-Flash-0731-Tokenizer:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Für OpenAI-Modelle gibt es die tiktoken-Bibliothek. Denk daran, dass eine Zählung mit einem Tokenizer für jedes andere Modell nur eine Schätzung ist.
Dein nächster Schritt#
Um ein Budget zu schätzen, nimm eine typische Prompt- und Antwortgröße und multipliziere sie mit dem Preis pro Million Tokens. Aktuelle CheapTokens-Preise, festgelegt in US-Dollar:
| Modell | Kontext | Input $/1M | Output $/1M | OpenRouter Input | OpenRouter Output |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning vorübergehend nicht verfügbar | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash vorübergehend nicht verfügbar | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 vorübergehend nicht verfügbar | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Preise in USD pro 1 Mio. Token. OpenRouter-Zahlen dienen dem Vergleich und können sich ändern.


