AI入門ガイド
AIにおけるトークンとは? 平易な英語での説明
トークンとは AI モデルが読み書きするテキストの断片です。実際のトークナイザーが文をどう分割するか、1単語が何トークンになるか、トークンがどう請求になるかを見てみましょう。
このページの内容
トークンとは、言語モデルが扱うテキストの小さな断片です。単語全体、単語の一部、句読点、あるいは単語とその前の空白を合わせたものです。モデルはプロンプトをトークンとして読み、回答をトークンとして書き、AI API はトークン単位で課金します。つまり「これは何トークンか」という問いは、実は2つの問いです。収まるかどうか、そしていくらかかるかです。
モデルがテキストをトークンに分割する仕組み#
モデルがあなたのテキストを見る前に、トークナイザーが固定された語彙からテキストを断片に分割し、各断片を数値に変換します。頻出語は通常1つのトークンになります。珍しい語や長い語は部分に分割されます。
実際の例を挙げます。1つの文を2つのトークナイザー、DeepSeek-V4-Flash-0731 とともに公開されているものと OpenAI の o200k_base エンコーディングに通しました。
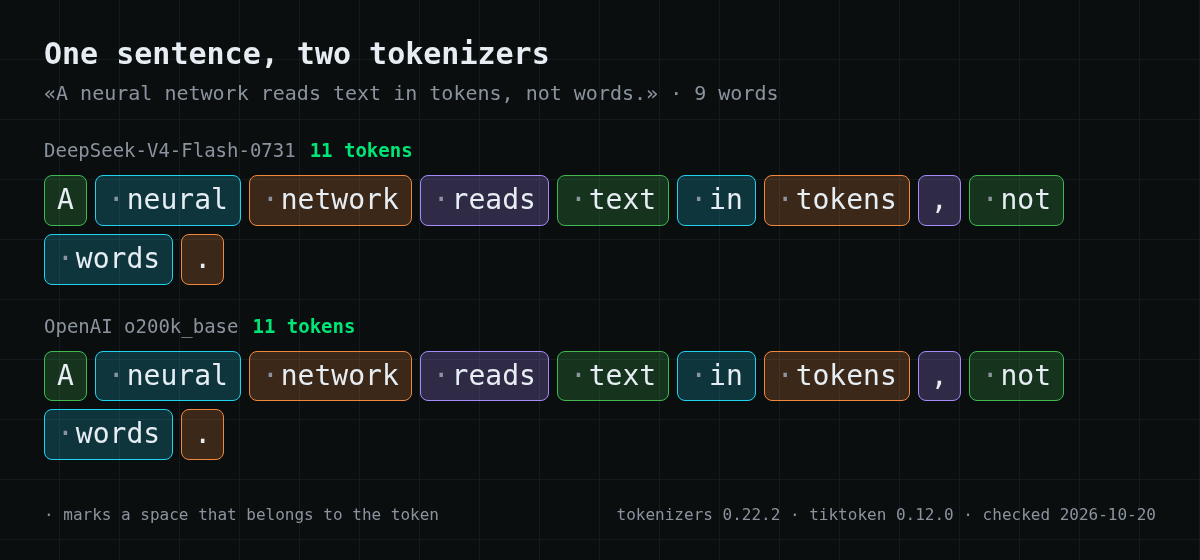
英語では両方のトークナイザーが一致します。9語、11トークンです。カンマとピリオドはそれぞれ独立したトークンで、ほとんどの単語は前の空白を伴います。
長い単語はトークナイザーが異なり始める場所です。「tokenization」はどちらでも2トークンです: token + ization。ロシア語の «токенизация» は DeepSeek では3トークン、OpenAI では4トークンです。同じ単語でも数が異なります。
1単語は何トークンか#
トークンに関する短い段落を使った簡単なテストを、英語とロシア語で行いました:
テーブルを右にスクロールしてください →
| テキスト | 単語数 | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| 英語の段落、254文字 | 53 | 60トークン | 60トークン |
| 同じ段落のロシア語版、255文字 | 42 | 73トークン | 65トークン |
英語のテキストでは、1単語あたり約1.1~1.2トークンが妥当な見積もりです。他の文字体系は通常もっとコストがかかります。ロシア語版は同じ内容をより少ない単語で表現していますが、DeepSeek のトークナイザーでは約20%多くのトークンを消費します。
これらは経験則として扱ってください。モデルファミリーごとに独自のトークナイザーがあり、あなたのテキストの正確な数は API が返すものです。
トークンは支払う対象#
API の価格は100万トークンあたりで、入力と出力で別々に提示されます:
- 入力トークン — 送信するすべて: システムプロンプト、チャット履歴、ドキュメント、そしてあなたの質問;
- 出力トークン — モデルが書き戻すすべて。モデルが回答前に推論する場合はその推論も含みます。
リクエストのコストは、入力トークン × 入力価格 + 出力トークン × 出力価格です。
実用的な帰結が2つあります。長いチャットはメッセージごとに高くなります。毎回、履歴全体が入力としてモデルに送り返されるからです。そして出力は通常、トークンあたりのコストが入力より数倍高いので、短い回答を求めることで実際にお金を節約できます。
人々が「トークン」と呼ぶ4つのもの#
この言葉は多義的で、だから検索するととても混乱します:
テーブルを右にスクロールしてください →
| 見かける場所 | 意味 |
|---|---|
| モデルの制限や価格 | 上記で説明したテキストの断片 |
| 「API トークン」「アクセストークン」 | コードが API を呼び出すための秘密鍵。あなたを識別するもので、前払いされたテキスト量ではありません |
| チャットアプリ内のトークン | 多くの場合、アプリ独自のクレジット。モデルのトークンとの関係はアプリ次第です |
| 暗号トークン | ブロックチェーンの資産で、言語モデルとは無関係 |
「トークンとは…」のようなクイズの答えを求めているなら、言語モデルに関しては正解はテキストの断片です: 単語、単語の一部、または記号です。
「トークンが足りない」と表示される理由#
同じフレーズが4つの異なる問題を指し、そのうちお金に関するものは1つだけです:
- プロンプトがコンテキストウィンドウに収まらない。 すべてのモデルには入力+出力の制限があります。CheapTokens では DeepSeek-V4-Flash が380,000トークン、GLM-5.3-Flash が390,000、MiniMax-M2.7 が200,000です。履歴を短くするか、ドキュメントを分割してください。
- 回答が出力制限に達した。 返信が文の途中で止まります。モデルの最大値の範囲内で
max_tokensを上げるか、短い回答を求めてください。 - 残高が尽きた。 チャージで解決するのはこのケースだけです。
- アプリに独自の制限がある。 チャットサービスはしばしば独自のルールで利用を制限し、モデル自体とは無関係です。
自分のテキストのトークンを数える方法#
最も信頼できる数は API から得られます。すべてのレスポンスには usage ブロックが含まれ、そこに prompt_tokens と completion_ があります。
送信前に見積もるには、モデルのトークナイザーをローカルで実行します。オープンモデルは重みと一緒にトークナイザーを公開しています。このスニペットは DeepSeek-V4-Flash-0731 トークナイザーで例の文を数えます:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
OpenAI モデルには tiktoken ライブラリがあります。あるトークナイザーでの数は、他のモデルにとっては見積もりにすぎないことを覚えておいてください。
次のステップ#
予算を見積もるには、典型的なプロンプトと回答のサイズを取り、100万トークンあたりの価格を掛けます。現在の CheapTokens 価格 (米ドル固定):
| モデル | コンテキスト | 入力 $/1M | 出力 $/1M | OpenRouter 入力 | OpenRouter 出力 |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning 一時的に利用できません | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash 一時的に利用できません | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 一時的に利用できません | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
価格は100万トークンあたりのUSD表記です。OpenRouterの数値は比較用であり、変更される可能性があります。


