O que é um token em IA? Uma explicação em linguagem simples
Um token é o pedaço de texto que um modelo de IA lê e escreve. Veja como um tokenizador real divide uma frase, quantos tokens uma palavra consome e como os tokens viram uma fatura.
Nesta página
Um token é um pequeno pedaço de texto com o qual um modelo de linguagem trabalha: uma palavra inteira, parte de uma palavra, um sinal de pontuação ou uma palavra junto com o espaço à sua frente. Os modelos leem seu prompt como tokens, escrevem a resposta como tokens, e as APIs de IA cobram por token. Então "quantos tokens isso tem" são na verdade duas perguntas: vai caber, e quanto vai custar.
Como um modelo corta o texto em tokens#
Antes de um modelo ver seu texto, um tokenizador o divide em pedaços de um vocabulário fixo e transforma cada pedaço em um número. Palavras frequentes geralmente recebem um único token. Palavras raras e longas são divididas em partes.
Aqui está um exemplo real. Passamos uma frase por dois tokenizadores: o publicado com o DeepSeek-V4-Flash-0731 e a codificação o200k_base da OpenAI.
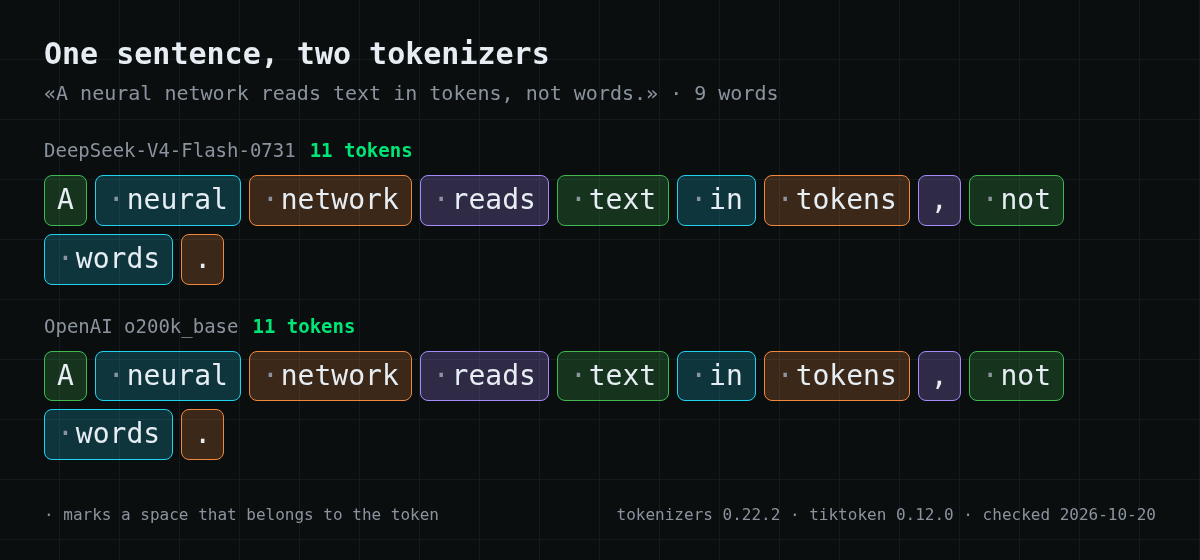
Em inglês, os dois tokenizadores concordam: 9 palavras, 11 tokens. A vírgula e o ponto final são tokens próprios, e a maioria das palavras carrega o espaço antes delas.
Palavras longas são onde os tokenizadores começam a divergir. "tokenization" são dois tokens em ambos: token + ization. A palavra russa «токенизация» são três tokens para o DeepSeek e quatro para a OpenAI. Mesma palavra, contagem diferente.
Quantos tokens tem uma palavra#
Um teste rápido com um parágrafo curto sobre tokens, em inglês e em russo:
Role a tabela para a direita →
| Texto | Palavras | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Parágrafo em inglês, 254 caracteres | 53 | 60 tokens | 60 tokens |
| O mesmo parágrafo em russo, 255 caracteres | 42 | 73 tokens | 65 tokens |
Para texto em inglês, cerca de 1,1–1,2 tokens por palavra é uma estimativa razoável. Outros alfabetos geralmente custam mais: a versão em russo diz a mesma coisa em menos palavras, mas consome cerca de 20% mais tokens com o tokenizador do DeepSeek.
Trate isso como regras práticas. Cada família de modelos tem seu próprio tokenizador, e a contagem exata para o seu texto é a que a API retorna.
Tokens são o que você paga#
Os preços das APIs são cotados por milhão de tokens, separadamente para entrada e saída:
- tokens de entrada — tudo o que você envia: o prompt de sistema, o histórico do chat, documentos e sua pergunta;
- tokens de saída — tudo o que o modelo escreve de volta, incluindo seu raciocínio se o modelo raciocina antes de responder.
O custo de uma requisição é tokens de entrada × preço de entrada + tokens de saída × preço de saída.
Duas consequências práticas. Um chat longo fica mais caro a cada mensagem, porque todo o histórico volta ao modelo como entrada a cada vez. E a saída geralmente custa várias vezes mais por token do que a entrada, então pedir respostas mais curtas economiza dinheiro de verdade.
Quatro coisas que as pessoas chamam de "token"#
A palavra tem vários significados, e é por isso que pesquisar por ela é tão confuso:
Role a tabela para a direita →
| Onde você viu | O que significa |
|---|---|
| Limites ou preços de um modelo | Pedaços de texto, como descrito acima |
| "Token de API", "token de acesso" | Uma chave secreta que permite seu código chamar a API. Ela identifica você; não é uma quantidade pré-paga de texto |
| Tokens dentro de um app de chat | Muitas vezes são os créditos do próprio app. Como eles se relacionam com tokens de modelo depende do app |
| Tokens de criptomoeda | Um ativo de blockchain, sem relação com modelos de linguagem |
Se você está respondendo a uma pergunta de quiz como "um token é…", para modelos de linguagem a resposta certa é um pedaço de texto: uma palavra, parte de uma palavra ou um símbolo.
Por que você pode ver "tokens insuficientes"#
A mesma frase pode apontar para quatro problemas diferentes, e só um deles é sobre dinheiro:
- O prompt não cabe na janela de contexto. Todo modelo tem um limite de entrada mais saída. Na CheapTokens é 380.000 tokens para o DeepSeek-V4-Flash, 390.000 para o GLM-5.3-Flash e 200.000 para o MiniMax-M2.7. Encurte o histórico ou divida o documento.
- A resposta atingiu o limite de saída. A resposta para no meio da frase. Aumente
max_tokensdentro do máximo do modelo, ou peça uma resposta mais curta. - O saldo acabou. Este é o único caso em que recarregar resolve.
- O app tem seu próprio limite. Serviços de chat muitas vezes limitam o uso por regras próprias, sem relação com o modelo em si.
Como contar tokens no seu próprio texto#
O número mais confiável vem da API: toda resposta inclui um bloco usage com prompt_tokens e completion_.
Para estimar antes de enviar, rode o tokenizador do modelo localmente. Modelos abertos publicam seu tokenizador junto com os pesos. Este trecho conta a frase de exemplo com o tokenizador DeepSeek-V4-Flash-0731:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Para modelos da OpenAI existe a biblioteca tiktoken. Lembre-se de que uma contagem de um tokenizador é apenas uma estimativa para qualquer outro modelo.
Seu próximo passo#
Para estimar um orçamento, pegue um prompt típico e um tamanho de resposta e multiplique pelo preço por milhão de tokens. Preços atuais da CheapTokens, fixados em dólares americanos:
| Modelo | Contexto | Entrada $/1M | Saída $/1M | OpenRouter entrada | OpenRouter saída |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning temporariamente indisponível | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash temporariamente indisponível | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 temporariamente indisponível | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Preços em USD por 1 milhão de tokens. Valores do OpenRouter exibidos para comparação e sujeitos a alterações.


