Ano ang token sa AI? Isang simpleng paliwanag sa Ingles
Ang token ay ang piraso ng teksto na binabasa at isinusulat ng isang AI model. Tingnan kung paano hinahati ng isang tunay na tokenizer ang isang pangungusap, ilang token ang isang salita at kung paano nagiging bill ang mga token.
Sa pahinang ito
Ang token ay isang maliit na piraso ng teksto na ginagamit ng isang language model: isang buong salita, bahagi ng salita, isang punctuation mark, o isang salita kasama ang espasyo sa harap nito. Binabasa ng mga modelo ang iyong prompt bilang mga token, isinusulat ang sagot bilang mga token, at ang mga AI API ay nagsisingil ayon sa token. Kaya ang "ilang token ba ito" ay talagang dalawang tanong: kasya ba ito, at magkano ang magagastos.
Paano hinahati ng isang modelo ang teksto sa mga token#
Bago makita ng isang modelo ang iyong teksto, hinahati ito ng isang tokenizer sa mga piraso mula sa isang fixed na vocabulary at ginagawang numero ang bawat piraso. Ang mga madalas na salita ay karaniwang nakakakuha ng isang token. Ang mga bihira at mahahabang salita ay hinahati sa mga bahagi.
Narito ang isang tunay na halimbawa. Pinadaan namin ang isang pangungusap sa dalawang tokenizer: ang isang inilathala kasama ng DeepSeek-V4-Flash-0731 at ang o200k_base encoding ng OpenAI.
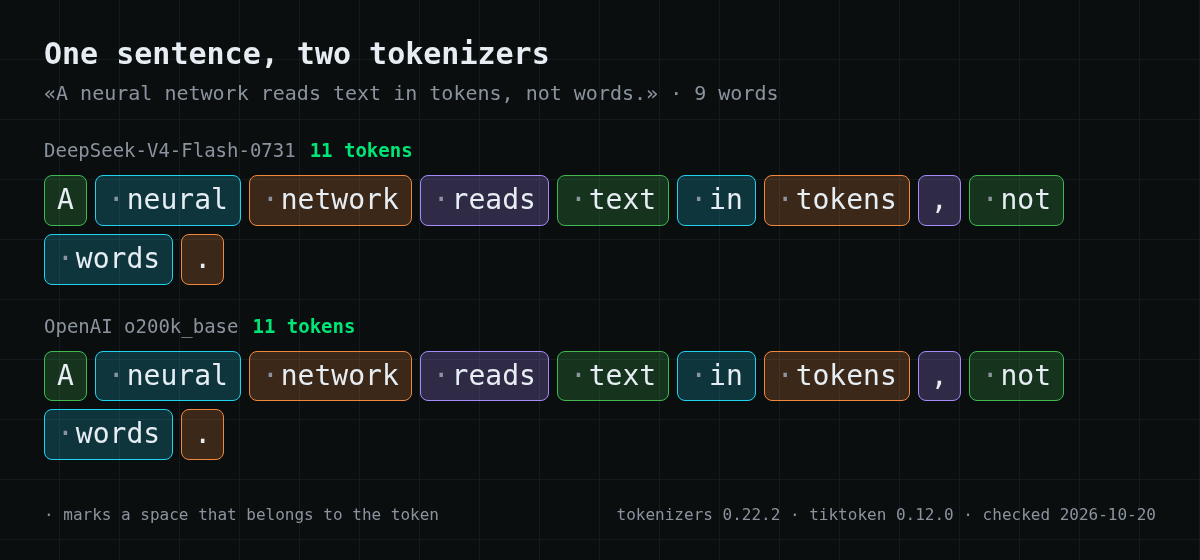
Sa Ingles, pareho ang dalawang tokenizer: 9 na salita, 11 token. Ang kuwit at ang tuldok ay mga token mismo, at karamihan sa mga salita ay may dalang espasyo sa harap nila.
Ang mahahabang salita ang pinag-iiba ng mga tokenizer. Ang "tokenization" ay dalawang token sa pareho: token + ization. Ang salitang Ruso na «токенизация» ay tatlong token para sa DeepSeek at apat para sa OpenAI. Parehong salita, magkaibang bilang.
Ilang token ang isang salita#
Isang mabilis na pagsubok gamit ang isang maikling talata tungkol sa mga token, sa Ingles at sa Ruso:
I-scroll ang table pakanan →
| Teksto | Mga Salita | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Talatang Ingles, 254 na character | 53 | 60 token | 60 token |
| Ang parehong talata sa Ruso, 255 na character | 42 | 73 token | 65 token |
Para sa tekstong Ingles, ang mga 1.1–1.2 token bawat salita ay isang makatwirang tantya. Ang ibang mga script ay karaniwang mas mahal: ang bersyong Ruso ay nagsasabi ng parehong bagay sa mas kaunting salita ngunit tumatagal ng mga 20% na mas maraming token sa tokenizer ng DeepSeek.
Ituring ang mga ito bilang mga rule of thumb. Bawat pamilya ng modelo ay may sariling tokenizer, at ang eksaktong bilang para sa iyong teksto ay ang iniuulat ng API.
Ang mga token ang binabayaran mo#
Ang mga presyo ng API ay sinipi kada milyong token, hiwalay para sa input at output:
- input tokens — lahat ng ipinapadala mo: ang system prompt, chat history, mga dokumento at ang iyong tanong;
- output tokens — lahat ng isinusulat pabalik ng modelo, kasama ang pag-iisip nito kung nag-iisip ang modelo bago sumagot.
Ang gastos ng isang request ay input tokens × input price + output tokens × output price.
Dalawang praktikal na kahihinatnan. Ang mahabang chat ay nagiging mas mahal sa bawat mensahe, dahil ang buong history ay bumabalik sa modelo bilang input sa bawat pagkakataon. At ang output ay karaniwang nagkakahalaga ng ilang beses na mas mahal kada token kaysa input, kaya ang paghingi ng mas maiikling sagot ay nakakatipid ng tunay na pera.
Apat na bagay na tinatawag na "token"#
Ang salita ay overloaded, kaya nakakalito ang paghahanap nito:
I-scroll ang table pakanan →
| Saan mo ito nakita | Ano ang ibig sabihin |
|---|---|
| Mga limitasyon o presyo ng modelo | Mga piraso ng teksto, gaya ng inilarawan sa itaas |
| "API token", "access token" | Isang secret key na nagpapahintulot sa iyong code na tumawag sa API. Kinikilala ka nito; hindi ito prepaid na halaga ng teksto |
| Mga token sa loob ng chat app | Kadalasan ang sariling credits ng app. Kung paano ito nauugnay sa mga token ng modelo ay nasa app |
| Crypto tokens | Isang blockchain asset, walang kaugnayan sa mga language model |
Kung sinasagot mo ang isang tanong sa quiz tulad ng "a token is…", para sa mga language model ang tamang sagot ay isang piraso ng teksto: isang salita, bahagi ng salita o isang simbolo.
Bakit maaari kang makakita ng "not enough tokens"#
Ang parehong parirala ay maaaring tumukoy sa apat na magkaibang problema, at isa lang sa kanila ang tungkol sa pera:
- Hindi kasya ang prompt sa context window. Bawat modelo ay may limitasyon sa input at output. Sa CheapTokens ito ay 380,000 token para sa DeepSeek-V4-Flash, 390,000 para sa GLM-5.3-Flash at 200,000 para sa MiniMax-M2.7. Paikliin ang history o hatiin ang dokumento.
- Naabot ng sagot ang output limit. Ang tugon ay humihinto sa gitna ng pangungusap. Itaas ang
max_tokenssa loob ng maximum ng modelo, o humingi ng mas maikling sagot. - Naubos ang balanse. Ito ang tanging kaso kung saan ang pag-top up ang nag-aayos nito.
- Ang app ay may sariling limitasyon. Ang mga chat service ay kadalasang naglilimita ng paggamit ayon sa kanilang sariling mga patakaran, walang kaugnayan sa modelo mismo.
Paano magbilang ng mga token sa iyong sariling teksto#
Ang pinaka-maaasahang numero ay nagmumula sa API: bawat tugon ay may kasamang usage block na may prompt_tokens at completion_.
Upang tantiyahin bago magpadala, patakbuhin ang tokenizer ng modelo nang lokal. Ang mga open model ay naglalathala ng kanilang tokenizer katabi ng mga weights. Binibilang ng snippet na ito ang halimbawang pangungusap gamit ang DeepSeek-V4-Flash-0731 tokenizer:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Para sa mga OpenAI model, mayroong tiktoken library. Tandaan na ang bilang mula sa isang tokenizer ay tantya lamang para sa anumang ibang modelo.
Ang iyong susunod na hakbang#
Upang tantiyahin ang isang budget, kumuha ng tipikal na prompt at laki ng sagot at i-multiply sa presyo kada milyong token. Kasalukuyang presyo ng CheapTokens, nakatakda sa US dollars:
| Modelo | Context | Input $/1M | Output $/1M | OpenRouter in | OpenRouter out |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning pansamantalang hindi magagamit | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash pansamantalang hindi magagamit | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 pansamantalang hindi magagamit | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Mga presyo sa USD bawat 1M token. Ang mga figure ng OpenRouter ay ipinapakita para sa paghahambing at maaaring magbago.


