نئے سیکھنے والوں کے لیے AIگائیڈ
AI میں ٹوکن کیا ہے؟ سادہ انگریزی میں وضاحت
ٹوکن متن کا وہ ٹکڑا ہے جو AI ماڈل پڑھتا اور لکھتا ہے۔ دیکھیں کہ ایک حقیقی ٹوکنائزر جملے کو کیسے تقسیم کرتا ہے، ایک لفظ کتنے ٹوکنز لیتا ہے اور ٹوکنز بل کیسے بنتے ہیں۔
اس صفحہ پر
ٹوکن متن کا ایک چھوٹا ٹکڑا ہے جس کے ساتھ لینگویج ماڈل کام کرتا ہے: ایک مکمل لفظ، لفظ کا ایک حصہ، ایک رموزِ اوقاف کا نشان، یا ایک لفظ اس سے پہلے کی جگہ کے ساتھ۔ ماڈلز آپ کے پرامپٹ کو ٹوکنز کے طور پر پڑھتے ہیں، جواب کو ٹوکنز کے طور پر لکھتے ہیں، اور AI APIs ٹوکن کے حساب سے بل کرتے ہیں۔ تو "یہ کتنے ٹوکنز ہے" دراصل دو سوالات ہیں: کیا یہ فٹ ہوگا، اور اس کی لاگت کتنی ہوگی۔
ماڈل متن کو ٹوکنز میں کیسے کاٹتا ہے#
اس سے پہلے کہ ماڈل آپ کا متن دیکھے، ایک ٹوکنائزر اسے ایک مقررہ ذخیرہ الفاظ سے ٹکڑوں میں تقسیم کرتا ہے اور ہر ٹکڑے کو ایک عدد میں بدل دیتا ہے۔ کثرت سے استعمال ہونے والے الفاظ عام طور پر ایک ہی ٹوکن لیتے ہیں۔ نایاب اور طویل الفاظ حصوں میں تقسیم ہو جاتے ہیں۔
یہاں ایک حقیقی مثال ہے۔ ہم نے ایک جملہ دو ٹوکنائزرز سے گزارا: وہ جو DeepSeek-V4-Flash-0731 کے ساتھ شائع ہوا اور OpenAI کی o200k_base انکوڈنگ۔
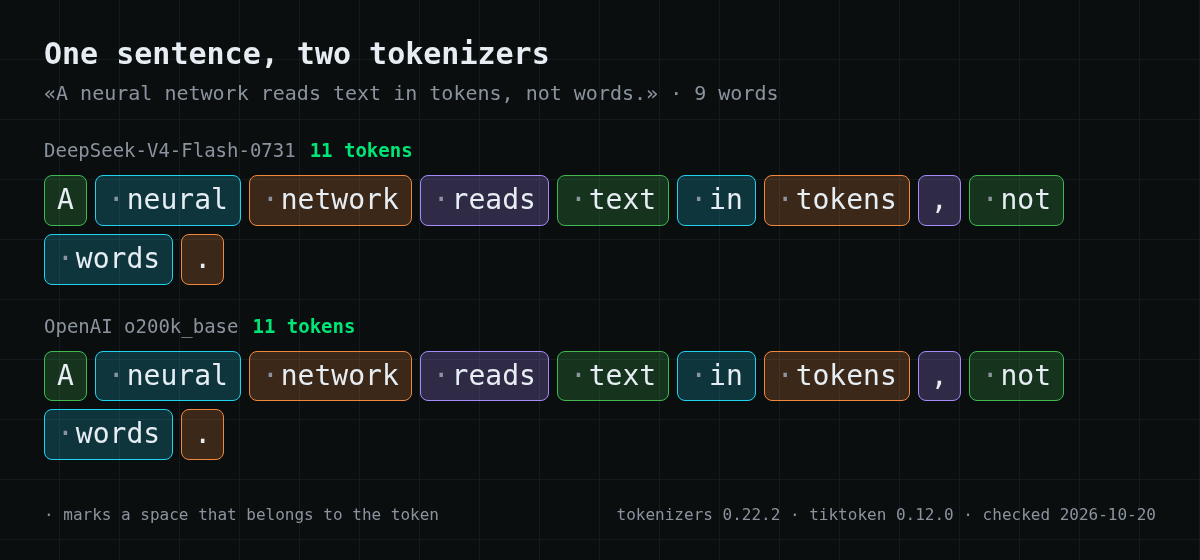
انگریزی میں دونوں ٹوکنائزرز متفق ہیں: 9 الفاظ، 11 ٹوکنز۔ کوما اور فل اسٹاپ اپنے الگ ٹوکنز ہیں، اور زیادہ تر الفاظ اپنے سامنے کی جگہ ساتھ لے کر چلتے ہیں۔
طویل الفاظ وہ جگہ ہیں جہاں ٹوکنائزرز مختلف ہونے لگتے ہیں۔ "tokenization" دونوں میں دو ٹوکنز ہے: token + ization۔ روسی لفظ «токенизация» DeepSeek کے لیے تین ٹوکنز اور OpenAI کے لیے چار ہے۔ ایک ہی لفظ، مختلف تعداد۔
ایک لفظ کتنے ٹوکنز ہے#
ٹوکنز کے بارے میں ایک مختصر پیراگراف کے ساتھ ایک فوری آزمائش، انگریزی اور روسی میں:
ٹیبل کو دائیں طرف اسکرول کریں →
| متن | الفاظ | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| انگریزی پیراگراف، 254 حروف | 53 | 60 ٹوکنز | 60 ٹوکنز |
| وہی پیراگراف روسی میں، 255 حروف | 42 | 73 ٹوکنز | 65 ٹوکنز |
انگریزی متن کے لیے، تقریباً 1.1–1.2 ٹوکنز فی لفظ ایک مناسب اندازہ ہے۔ دیگر رسم الخط عام طور پر زیادہ مہنگے ہوتے ہیں: روسی ورژن کم الفاظ میں وہی بات کہتا ہے لیکن DeepSeek کے ٹوکنائزر کے ساتھ تقریباً 20% زیادہ ٹوکنز لیتا ہے۔
انہیں انگوٹھے کے قواعد سمجھیں۔ ہر ماڈل فیملی کا اپنا ٹوکنائزر ہوتا ہے، اور آپ کے متن کی درست تعداد وہی ہے جو API واپس رپورٹ کرتا ہے۔
ٹوکنز وہ ہیں جن کی آپ ادائیگی کرتے ہیں#
API قیمتیں فی ملین ٹوکنز بتائی جاتی ہیں، ان پٹ اور آؤٹ پٹ کے لیے الگ الگ:
- ان پٹ ٹوکنز — وہ سب کچھ جو آپ بھیجتے ہیں: سسٹم پرامپٹ، چیٹ ہسٹری، دستاویزات اور آپ کا سوال؛
- آؤٹ پٹ ٹوکنز — وہ سب کچھ جو ماڈل واپس لکھتا ہے، بشمول اس کی استدلال اگر ماڈل جواب دینے سے پہلے استدلال کرتا ہے۔
ایک درخواست کی لاگت = ان پٹ ٹوکنز × ان پٹ قیمت + آؤٹ پٹ ٹوکنز × آؤٹ پٹ قیمت۔
دو عملی نتائج۔ ایک طویل چیٹ ہر پیغام کے ساتھ زیادہ مہنگی ہوتی جاتی ہے، کیونکہ ہر بار پوری ہسٹری ان پٹ کے طور پر ماڈل کو واپس جاتی ہے۔ اور آؤٹ پٹ عام طور پر فی ٹوکن ان پٹ سے کئی گنا زیادہ مہنگا ہوتا ہے، لہٰذا مختصر جوابات مانگنا حقیقی پیسے بچاتا ہے۔
چار چیزیں جنہیں لوگ "ٹوکن" کہتے ہیں#
یہ لفظ زیادہ بوجھ اٹھائے ہوئے ہے، اسی لیے اسے تلاش کرنا اتنا الجھا دینے والا ہے:
ٹیبل کو دائیں طرف اسکرول کریں →
| جہاں آپ نے اسے دیکھا | اس کا مطلب |
|---|---|
| ماڈل کی حدود یا قیمتیں | متن کے ٹکڑے، جیسا کہ اوپر بیان کیا گیا |
| "API token"، "access token" | ایک خفیہ کلید جو آپ کے کوڈ کو API کال کرنے دیتی ہے۔ یہ آپ کی شناخت کرتی ہے؛ یہ متن کی پیشگی ادائیگی شدہ مقدار نہیں ہے |
| چیٹ ایپ کے اندر ٹوکنز | اکثر ایپ کے اپنے کریڈٹس۔ ان کا ماڈل ٹوکنز سے تعلق ایپ پر منحصر ہے |
| کرپٹو ٹوکنز | ایک بلاک چین اثاثہ، لینگویج ماڈلز سے غیر متعلق |
اگر آپ کوئی کوئز سوال حل کر رہے ہیں جیسے "a token is…"، تو لینگویج ماڈلز کے لیے درست جواب متن کا ایک ٹکڑا ہے: ایک لفظ، لفظ کا ایک حصہ یا ایک علامت۔
آپ کو "not enough tokens" کیوں نظر آ سکتا ہے#
ایک ہی جملہ چار مختلف مسائل کی طرف اشارہ کر سکتا ہے، اور ان میں سے صرف ایک پیسے کے بارے میں ہے:
- پرامپٹ کانٹیکسٹ ونڈو میں فٹ نہیں ہوتا۔ ہر ماڈل کی ان پٹ جمع آؤٹ پٹ پر حد ہوتی ہے۔ CheapTokens پر یہ DeepSeek-V4-Flash کے لیے 380,000 ٹوکنز، GLM-5.3-Flash کے لیے 390,000 اور MiniMax-M2.7 کے لیے 200,000 ہے۔ ہسٹری مختصر کریں یا دستاویز تقسیم کریں۔
- جواب آؤٹ پٹ حد سے ٹکرا گیا۔ جواب درمیان میں رک جاتا ہے۔ ماڈل کی زیادہ سے زیادہ حد کے اندر
max_tokensبڑھائیں، یا مختصر جواب مانگیں۔ - بیلنس ختم ہو گیا۔ یہ واحد صورت ہے جہاں ٹاپ اپ اسے ٹھیک کرتا ہے۔
- ایپ کی اپنی حد ہے۔ چیٹ سروسز اکثر اپنے قواعد کے مطابق استعمال کو محدود کرتی ہیں، جو ماڈل سے غیر متعلق ہیں۔
اپنے متن میں ٹوکنز کی گنتی کیسے کریں#
سب سے قابل اعتماد عدد API سے آتا ہے: ہر جواب میں usage بلاک شامل ہوتا ہے جس میں prompt_tokens اور completion_ ہوتے ہیں۔
بھیجنے سے پہلے اندازہ لگانے کے لیے، ماڈل کا ٹوکنائزر مقامی طور پر چلائیں۔ اوپن ماڈلز اپنا ٹوکنائزر وزن کے ساتھ شائع کرتے ہیں۔ یہ اسنیپٹ مثال کا جملہ DeepSeek-V4-Flash-0731 ٹوکنائزر سے گنتا ہے:
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
OpenAI ماڈلز کے لیے tiktoken لائبریری ہے۔ ذہن میں رکھیں کہ ایک ٹوکنائزر سے گنتی کسی بھی دوسرے ماڈل کے لیے صرف ایک اندازہ ہے۔
آپ کا اگلا قدم#
بجٹ کا اندازہ لگانے کے لیے، ایک عام پرامپٹ اور جواب کا سائز لیں اور فی ملین ٹوکنز قیمت سے ضرب دیں۔ موجودہ CheapTokens قیمتیں، امریکی ڈالر میں مقرر:
| ماڈل | کانٹیکسٹ | ان پٹ $/1M | آؤٹ پٹ $/1M | OpenRouter ان پٹ | OpenRouter آؤٹ پٹ |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning عارضی طور پر دستیاب نہیں | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash عارضی طور پر دستیاب نہیں | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 عارضی طور پر دستیاب نہیں | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
قیمتیں USD میں فی 1M ٹوکن ہیں۔ OpenRouter کے اعداد و شمار موازنے کے لیے دکھائے گئے ہیں اور بدل سکتے ہیں۔


