IA pour débutantsGuide
Qu'est-ce qu'un token en IA ? Une explication en langage clair
Un token est le morceau de texte qu'un modèle d'IA lit et écrit. Découvrez comment un vrai tokenizer découpe une phrase, combien de tokens prend un mot et comment les tokens deviennent une facture.
Sur cette page
Un token est un petit morceau de texte avec lequel un modèle de langage travaille : un mot entier, une partie de mot, un signe de ponctuation, ou un mot accompagné de l'espace qui le précède. Les modèles lisent votre prompt sous forme de tokens, écrivent la réponse sous forme de tokens, et les API d'IA facturent au token. Donc « combien de tokens cela représente-t-il » recouvre en réalité deux questions : est-ce que ça rentre, et combien ça va coûter.
Comment un modèle découpe le texte en tokens#
Avant qu'un modèle ne voie votre texte, un tokenizer le découpe en morceaux issus d'un vocabulaire fixe et transforme chaque morceau en un nombre. Les mots fréquents obtiennent généralement un seul token. Les mots rares et longs sont découpés en plusieurs parties.
Voici un exemple réel. Nous avons fait passer une phrase dans deux tokenizers : celui publié avec DeepSeek-V4-Flash-0731 et l'encodage o200k_base d'OpenAI.
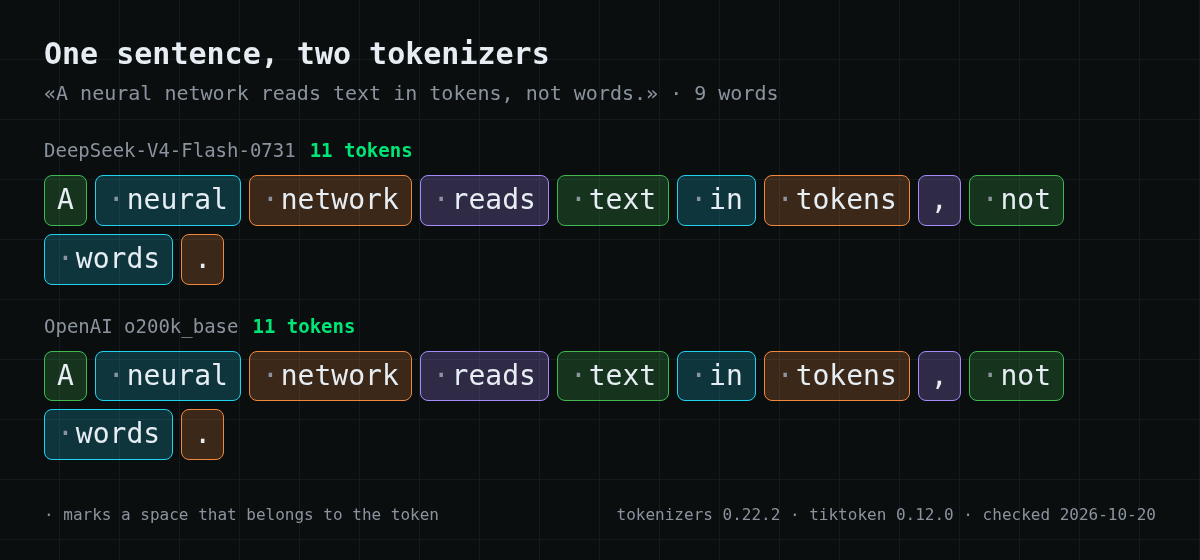
En anglais, les deux tokenizers sont d'accord : 9 mots, 11 tokens. La virgule et le point sont des tokens à part entière, et la plupart des mots portent l'espace qui les précède.
C'est sur les mots longs que les tokenizers commencent à diverger. « tokenization » fait deux tokens dans les deux cas : token + ization. Le mot russe « токенизация » fait trois tokens pour DeepSeek et quatre pour OpenAI. Même mot, nombre différent.
Combien de tokens représente un mot#
Un test rapide avec un court paragraphe sur les tokens, en anglais et en russe :
Faites défiler le tableau vers la droite →
| Texte | Mots | DeepSeek-V4-Flash | OpenAI o200k_base |
|---|---|---|---|
| Paragraphe anglais, 254 caractères | 53 | 60 tokens | 60 tokens |
| Le même paragraphe en russe, 255 caractères | 42 | 73 tokens | 65 tokens |
Pour un texte anglais, environ 1,1 à 1,2 token par mot est une estimation raisonnable. Les autres écritures coûtent généralement plus cher : la version russe dit la même chose en moins de mots mais consomme environ 20 % de tokens en plus avec le tokenizer de DeepSeek.
Considérez ces chiffres comme des ordres de grandeur. Chaque famille de modèles a son propre tokenizer, et le nombre exact pour votre texte est celui que l'API renvoie.
Les tokens sont ce que vous payez#
Les prix des API sont indiqués par million de tokens, séparément pour l'entrée et la sortie :
- tokens d'entrée — tout ce que vous envoyez : le prompt système, l'historique de conversation, les documents et votre question ;
- tokens de sortie — tout ce que le modèle écrit en retour, y compris son raisonnement si le modèle raisonne avant de répondre.
Le coût d'une requête est tokens d'entrée × prix d'entrée + tokens de sortie × prix de sortie.
Deux conséquences pratiques. Une longue conversation devient plus chère à chaque message, car tout l'historique est renvoyé au modèle en entrée à chaque fois. Et la sortie coûte généralement plusieurs fois plus cher par token que l'entrée, donc demander des réponses plus courtes permet d'économiser réellement.
Quatre choses que les gens appellent « token »#
Le mot est surchargé, c'est pourquoi le rechercher est si déroutant :
Faites défiler le tableau vers la droite →
| Où vous l'avez vu | Ce que cela signifie |
|---|---|
| Les limites ou les prix d'un modèle | Des morceaux de texte, comme décrit ci-dessus |
| « token d'API », « token d'accès » | Une clé secrète qui permet à votre code d'appeler l'API. Elle vous identifie ; ce n'est pas une quantité de texte prépayée |
| Les tokens dans une application de chat | Souvent les crédits propres à l'application. Leur rapport avec les tokens du modèle dépend de l'application |
| Les tokens crypto | Un actif de blockchain, sans rapport avec les modèles de langage |
Si vous répondez à une question de quiz du type « un token est… », pour les modèles de langage la bonne réponse est un morceau de texte : un mot, une partie de mot ou un symbole.
Pourquoi vous pouvez voir « pas assez de tokens »#
La même phrase peut désigner quatre problèmes différents, et un seul concerne l'argent :
- Le prompt ne rentre pas dans la fenêtre de contexte. Chaque modèle a une limite sur l'entrée plus la sortie. Chez CheapTokens, c'est 380 000 tokens pour DeepSeek-V4-Flash, 390 000 pour GLM-5.3-Flash et 200 000 pour MiniMax-M2.7. Raccourcissez l'historique ou découpez le document.
- La réponse a atteint la limite de sortie. La réponse s'arrête en milieu de phrase. Augmentez
max_tokensdans la limite maximale du modèle, ou demandez une réponse plus courte. - Le solde est épuisé. C'est le seul cas où une recharge résout le problème.
- L'application a sa propre limite. Les services de chat plafonnent souvent l'usage selon leurs propres règles, sans rapport avec le modèle lui-même.
Comment compter les tokens dans votre propre texte#
Le nombre le plus fiable vient de l'API : chaque réponse inclut un bloc usage avec prompt_tokens et completion_.
Pour estimer avant d'envoyer, exécutez le tokenizer du modèle en local. Les modèles ouverts publient leur tokenizer à côté des poids. Cet extrait compte la phrase d'exemple avec le tokenizer DeepSeek-V4-Flash-0731 :
# pip install tokenizers huggingface_hub
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

path = hf_hub_download("deepseek-ai/DeepSeek-V4-Flash-0731", "tokenizer.json")
tok = Tokenizer.from_file(path)

text = "A neural network reads text in tokens, not words."
enc = tok.encode(text, add_special_tokens=False)
print(len(enc.ids))  # 11
Pour les modèles OpenAI, il y a la bibliothèque tiktoken. Gardez à l'esprit qu'un comptage issu d'un tokenizer n'est qu'une estimation pour tout autre modèle.
Votre prochaine étape#
Pour estimer un budget, prenez un prompt typique et une taille de réponse typique et multipliez par le prix par million de tokens. Prix actuels de CheapTokens, fixés en dollars américains :
| Modèle | Contexte | Entrée $/1M | Sortie $/1M | OpenRouter entrée | OpenRouter sortie |
|---|---|---|---|---|---|
| GLM-5.3-Flash reasoning temporairement indisponible | 390K | $0.027 | $0.08 | $0.048 | $0.20 |
| DeepSeek-V4-Flash temporairement indisponible | 380K | $0.0221 | $0.10 | $0.016 | $0.64 |
| MiniMax-M2.7 temporairement indisponible | 200K | $0.05 | $0.15 | $0.30 | $1.20 |
Prix en USD pour 1 million de jetons. Les chiffres d'OpenRouter sont affichés à titre de comparaison et peuvent varier.


