AI dla początkującychPrzewodnik
Czym są open weights? Wyjaśnienie kwantyzacji 2-bit i 4-bit
Open weights oznaczają, że możesz pobrać pliki modelu. Kwantyzacja je zmniejsza: zobacz, ile wierności kosztują 2 bity i kiedy API jest prostsze.
Na tej stronie
Otwierasz ogłoszenie modelu i widzisz „open weights” obok pliku o nazwie UD-Q2_K_XL. Krótka odpowiedź: open weights oznacza, że deweloper opublikował pliki modelu, więc każdy może je pobrać i uruchomić. 2-bit oznacza, że każda liczba w środku jest zapisana na zaledwie dwóch bitach: plik staje się znacznie mniejszy, a model trochę mniej precyzyjny. Jeśli wolisz pominąć pobieranie, możesz wywoływać modele przez API; dokumentacja CheapTokens pokazuje pierwsze zapytanie.
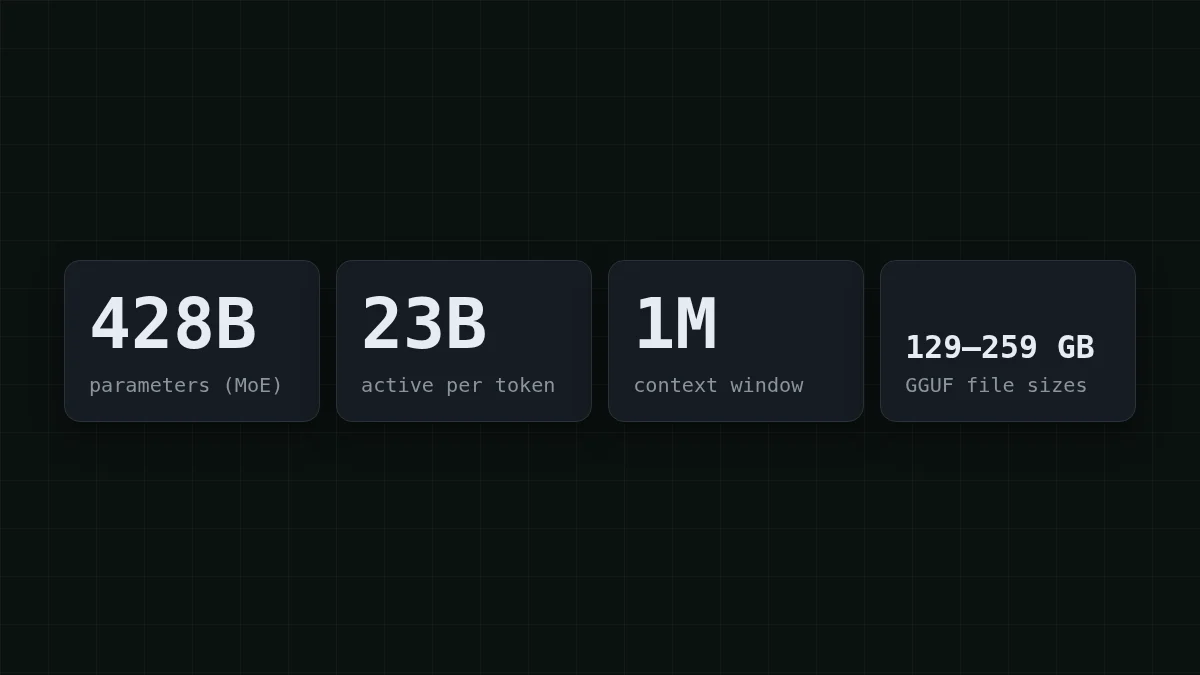
Poniższy przykład jest prawdziwy. Strona modelu MiniMax-M3.1-Flash w Unsloth (bez daty; sprawdzona 27 października 2026) wymienia pliki GGUF od 129,4 GB do 259,1 GB dla modelu, który opisaliśmy w poście o premierze M3.1 Flash. Każdy rozmiar i każda wartość pamięci pochodzą z tej strony.
Słowa, które wciąż spotykasz#
Wyobraź sobie pulpit mikserski z 428 miliardami pokręteł. Trening delikatnie reguluje każde pokrętło, aż dźwięk na wyjściu brzmi dobrze. Ostateczne położenie wszystkich pokręteł to wagi modelu. Opublikuj tę listę, a masz model open-weight; trzymaj ją na własnych serwerach, a jedynym wejściem jest API.
Fiszki
Słowa, które spotkasz w każdym ogłoszeniu
Dotknij kartę, aby ją odwrócić
Dwie pułapki dla początkujących. „Open-weight” nie oznacza automatycznie „darmowy do dowolnego użytku”: decyduje licencja, a strona Unsloth jej nie podaje, więc przeczytaj kartę modelu (MiniMaxAI/ na Hugging Face), zanim zbudujesz cokolwiek komercyjnego. A „darmowy do pobrania” to nie „darmowy w uruchomieniu”, co pokazują kolejne sekcje.
Dlaczego jeden model to pobranie 130–260 GB#
Każda z tych 428 miliardów wag to liczba, a liczby zajmują miejsce. Zasada to liczba × bity ÷ 8 = bajty. Spróbuj przed dalszą lekturą.
Zgadnij liczbę
Ile GB zajmuje 8 miliardów wag, gdy każda jest zapisana na 4 bitach?
Twoje przypuszczenie
016
Pokaż odpowiedź
Odpowiedź: 4
4 bity to pół bajtu, więc 8 miliardów × 0,5 bajtu = 4 GB.
Teraz skalujemy w górę. Nawet przy 2 bitach na wagę 428 × 2 ÷ 8 = 107 GB to dolna granica dla całego modelu. Rzeczywisty plik 2-bitowy ma 143,9 GB, nieco powyżej tej granicy, więc liczba bitów w nazwie pliku to etykieta, a nie dokładny licznik.
Wartość „23B aktywnych” dotyczy szybkości, nie przechowywania. Tylko wycinek modelu pracuje nad każdym tokenem, co czyni go szybkim, ale wycinek zmienia się z tokena na token, więc wszystkie 428B wag musi być załadowanych i czekać.
Co faktycznie robią 2 bity i 4 bity#
Pomyśl o linijce. Bity decydują, ile ma znaczków: 2 bity dają 4 znaczki, 4 bity dają 16, 8 bitów daje 256, a zwykłe 16 bitów daje 65 536. Kwantyzacja zaokrągla każdą wagę do najbliższego znaczka. Mniej znaczków oznacza mniejszy plik i większy błąd zaokrąglenia na każdej liczbie.
Oto oferta Unsloth dla tego modelu wraz z pamięcią (RAM plus VRAM), jakiej potrzebuje przy kontekście 16K dla jednej sesji. Rozmiary podano w GB dziesiętnych.
Przewiń tabelę w prawo →
| Poziom | Pliki (rozmiar) | Potrzebna pamięć |
|---|---|---|
| 1-bit | UD-IQ1_M (129,4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134,9 GB), UD-Q2_K_XL (143,9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160,0 GB), UD-IQ3_S (175,5 GB), UD-Q3_K_XL (194,0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249,4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259,1 GB) | ~272 GB |
Jak czytać nazwę: UD-Q2_K_XL to kompilacja Unsloth Dynamic przy około 2 bitach; cyfra to poziom, a litery to warianty. Nie wykonuj obliczeń na cyfrze. Plik 8-bitowy ma tylko około 1,8 razy więcej niż 2-bitowy (259,1 ÷ 143,9 ≈ 1,8), a nie 4 razy. Rozmiar odczytaj ze strony pobierania.
Spróbuj samSpróbuj: twoja maszyna ma łącznie 128 GB pamięci. Czy któryś z tych plików się zmieści?Pokaż odpowiedź
Nie. Nawet najmniejszy, UD-IQ1_M, potrzebuje około 134 GB RAM plus VRAM przy kontekście 16K, więc 128 GB to za mało. Pliki 2-bitowe potrzebują około 150–160+ GB.
Z czego rezygnujesz przy 2 bitach#
Porównaj to z zapisaniem zdjęcia jako mniejszego JPEG: większość obrazu przetrwa, a uszkodzenia widać w drobnych szczegółach. Unsloth podaje, że jego plik 2-bitowy (143,9 GB) osiąga 91,5% ważonej zgodności z oryginalnym modelem w siedmiu kategoriach: kodowanie, matematyka, czat, narzędzia, wielojęzyczność, rozumowanie i działanie agentowe.
Przeczytaj tę liczbę uważnie. To własna miara Unsloth, a strona nie precyzuje punktu odniesienia ani sposobu ważenia, więc traktuj ją jako przybliżony wskaźnik, a nie niezależny test. Zgodność to też nie dokładność: mówi, jak blisko mały plik zachowuje się jak duży, a nie jak często którykolwiek ma rację. Małe różnice mogą się sumować w długim łańcuchu kroków, na przykład gdy agent wykonuje dwadzieścia wywołań narzędzi, więc wypróbuj kwant na własnym zadaniu, zanim na nim polegniesz. Wyższe poziomy pozostają bliżej oryginału i kosztują więcej pamięci.
Pobrać czy wywołać API?#
Załóżmy, że chcesz wypróbować model po przeczytaniu ogłoszenia. Wybierz wiersz, który brzmi jak ty.
Wybierz swój przypadek
Który opis pasuje do ciebie?
Wybierz opcję, aby zobaczyć odpowiedź
Laptop z 16–32 GB pamięci
Droga lokalna jest zamknięta: nawet plik 1-bitowy potrzebuje około 134 GB RAM plus VRAM. Zamiast tego wywołaj model przez API.
Stacja robocza z około 192 GB pamięci
Pliki 2-bitowe (potrzebne około 150–160+ GB) mieszczą się z zapasem. Pliki 3-bitowe potrzebują 176–208 GB w zależności od pliku, więc sprawdź dokładną wartość dla wybranego pliku przed pobraniem. Najpierw sprawdź licencję.
Chcę po prostu wypróbować model przez API
Pomiń pobieranie. Wywołanie API działa w modelu pay-as-you-go: wysyłasz tekst i dostajesz odpowiedź, bez pliku 130 GB na dysku.
Dla trzeciego wiersza jedno zapytanie wystarczy, by poczuć, jak to działa. To zapytanie trafia do DeepSeek-V4-Flash, który ma okno kontekstu 380K i odpowiada do 32 768 tokenów, w jednej cenie o każdej porze dnia:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
Odpowiedź wraca w choices[0]., a pole usage mówi, za ile tokenów zapłaciłeś. Nie wiesz, czym jest token? Wyjaśnienie prostym językiem zajmuje pięć minut. MiniMax-M2.7 jest dostępny w ten sam sposób, z oknem kontekstu 180K i do 8192 tokenów na odpowiedź. Oba używają API zgodnego z OpenAI/Anthropic, a jedno saldo obejmuje każdy model.
Jak to wygląda na rachunku? Załóżmy, że mały bot wsparcia wysyła 2000 zapytań dziennie, każde z 1500 tokenami na wejściu i 500 na wyjściu. Jedno takie zapytanie kosztuje $0.00015 w MiniMax-M2.7. Oto cały dzień dla każdego modelu, obok OpenRouter:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 2000 żądań | OpenRouter, 2000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1500 tokenów wejściowych i 500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Łącznie, licząc wejście i wyjście razem, CheapTokens wypada taniej niż OpenRouter. Aktualne ceny każdego modelu są na stronie cennika.
Jeśli masz sprzęt i chcesz porównać szybkość oraz koszty uruchomienia, Uruchom DeepSeek lokalnie lub użyj API przeprowadza przez to. A spodziewaj się tych słów wkrótce znowu: otwarte wagi dla Kimi K3.1 Pro mają pojawić się 4 listopada, jak wyjaśnia nasz post o premierze.


