IA pour débutantsGuide
Que sont les poids ouverts ? La quantification 2-bit et 4-bit expliquée
Les poids ouverts signifient que vous pouvez télécharger les fichiers du modèle. La quantification les réduit : voyez ce que coûte le 2-bit en fidélité et quand une API est plus simple.
Sur cette page
Vous ouvrez l'annonce d'un modèle et vous voyez « open weights » à côté d'un fichier appelé UD-Q2_K_XL. En bref : open weights signifie que le développeur a publié les fichiers du modèle, donc n'importe qui peut les télécharger et les exécuter. 2-bit signifie que chaque nombre à l'intérieur est stocké sur seulement deux bits : le fichier devient bien plus petit et le modèle un peu plus flou. Si vous préférez éviter le téléchargement, vous pouvez appeler les modèles via une API ; la documentation CheapTokens montre la première requête.
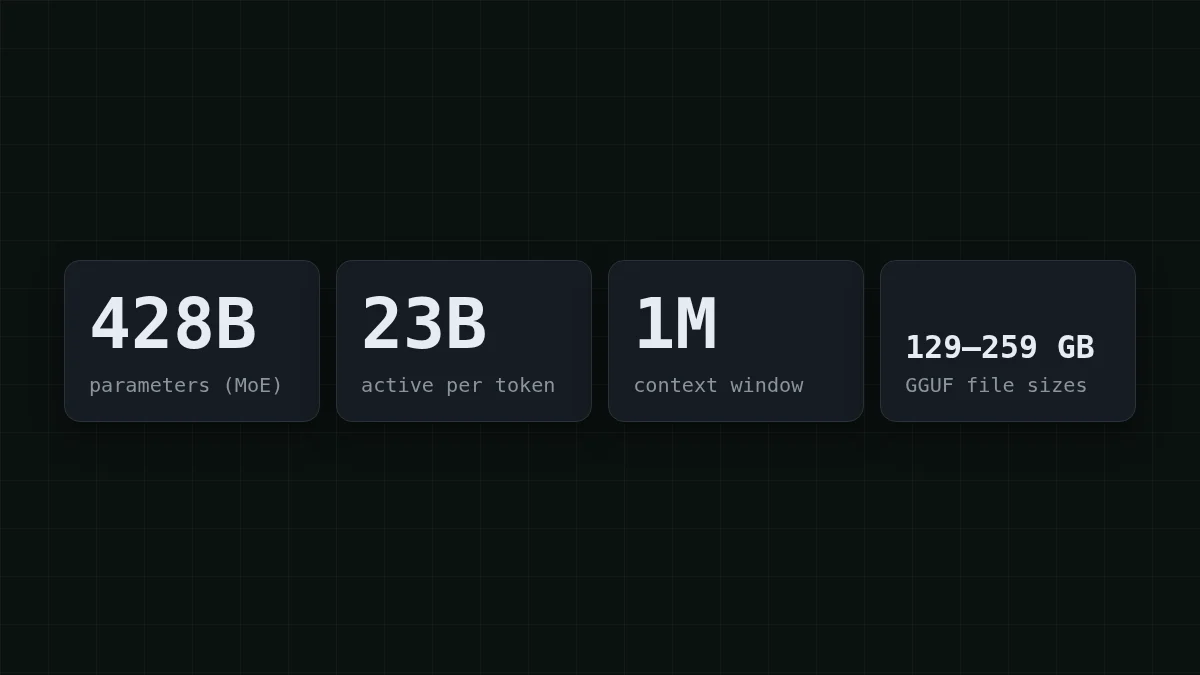
L'exemple ci-dessous est réel. La page du modèle MiniMax-M3.1-Flash chez Unsloth (non datée ; vérifiée le 27 octobre 2026) liste des fichiers GGUF de 129,4 Go à 259,1 Go pour un modèle que nous avons couvert dans l'article de lancement de M3.1 Flash. Toutes les tailles et chiffres de mémoire ici proviennent de cette page.
Les mots que vous ne cessez de croiser#
Imaginez une table de mixage avec 428 milliards de potentiomètres. L'entraînement ajuste chaque potentiomètre jusqu'à ce que la sortie sonne juste. La position finale de tous les potentiomètres, ce sont les poids du modèle. Publiez cette liste et vous avez un modèle à poids ouverts ; gardez-la sur vos propres serveurs et le seul accès est une API.
Cartes mémo
Les mots que vous croiserez dans chaque annonce
Touchez une carte pour la retourner
Deux pièges pour les débutants. « Open-weight » ne veut pas automatiquement dire « libre pour tout usage » : la licence décide, et la page d'Unsloth ne la précise pas, donc lisez la fiche du modèle (MiniMaxAI/ sur Hugging Face) avant de construire quoi que ce soit de commercial. Et « gratuit à télécharger » ne veut pas dire « gratuit à exécuter », ce que montrent les sections suivantes.
Pourquoi un seul modèle pèse un téléchargement de 130 à 260 Go#
Chacun de ces 428 milliards de poids est un nombre, et les nombres prennent de la place. La règle empirique est nombre × bits ÷ 8 = octets. Essayez avant de lire la suite.
Devinez le nombre
Combien de Go prennent 8 milliards de poids quand chacun est stocké sur 4 bits ?
Votre estimation
016
Afficher la réponse
Réponse: 4
4 bits font un demi-octet, donc 8 milliards × 0,5 octet = 4 Go.
Passons à l'échelle. Même à 2 bits par poids, 428 × 2 ÷ 8 = 107 Go est le plancher pour le modèle entier. Le vrai fichier 2-bit fait 143,9 Go, un peu au-dessus du plancher, donc le nombre de bits dans un nom de fichier est une étiquette plutôt qu'un compte exact.
Le chiffre « 23B actifs » concerne la vitesse, pas le stockage. Seule une tranche du modèle travaille sur chaque token, ce qui le rend rapide, mais la tranche change d'un token à l'autre, donc les 428B de poids doivent tous être chargés et en attente.
Ce que font réellement 2 bits et 4 bits#
Pensez à une règle graduée. Les bits décident du nombre de graduations : 2 bits donnent 4 graduations, 4 bits en donnent 16, 8 bits en donnent 256, et les 16 bits habituels en donnent 65 536. La quantification arrondit chaque poids à la graduation la plus proche. Moins de graduations signifie un fichier plus petit et une erreur d'arrondi plus grande sur chaque nombre.
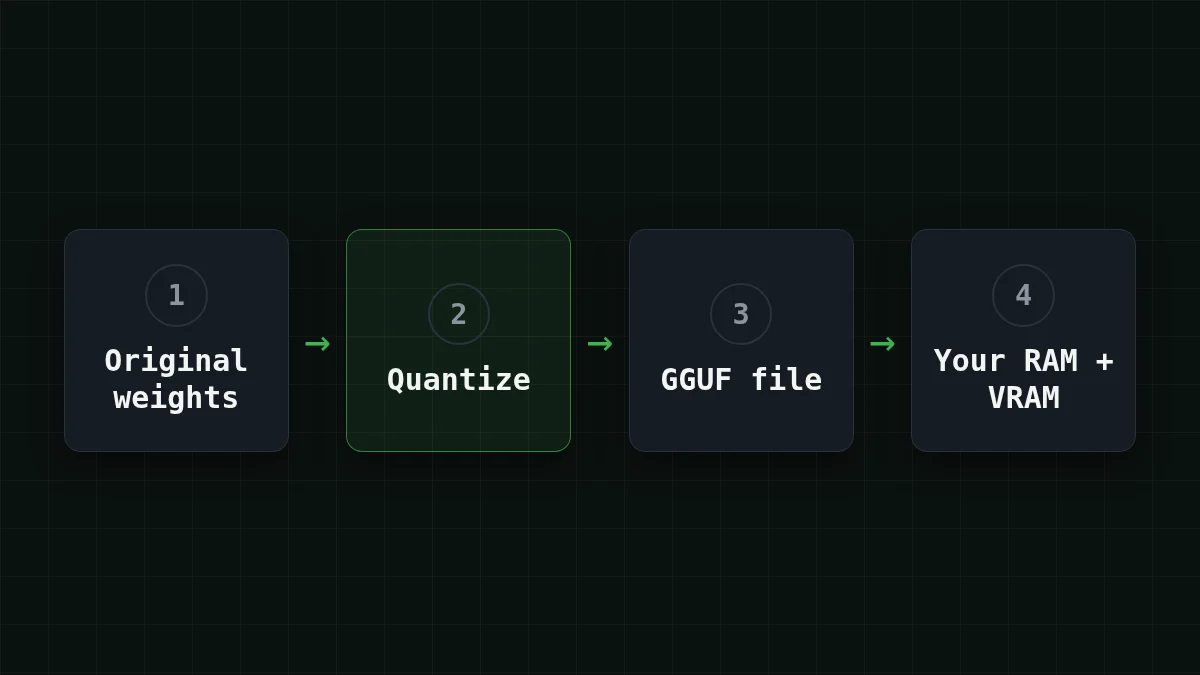
Voici la gamme d'Unsloth pour le modèle, avec la mémoire (RAM plus VRAM) nécessaire à un contexte de 16K pour une session. Les tailles sont en Go décimaux.
Faites défiler le tableau vers la droite →
| Niveau | Fichiers (taille) | Mémoire nécessaire |
|---|---|---|
| 1-bit | UD-IQ1_M (129,4 Go) | ~134 Go |
| 2-bit | UD-IQ2_XXS (134,9 Go), UD-Q2_K_XL (143,9 Go) | ~150–160+ Go |
| 3-bit | UD-IQ3_XXS (160,0 Go), UD-IQ3_S (175,5 Go), UD-Q3_K_XL (194,0 Go) | 176–208 Go |
| 4-bit | UD-Q4_K_XL (249,4 Go) | ~256 Go |
| 8-bit | UD-Q8_K_XL (259,1 Go) | ~272 Go |
Lire un nom : UD-Q2_K_XL est une build Unsloth Dynamic à environ 2 bits ; le chiffre est le niveau et les lettres sont des variantes. Ne faites pas d'arithmétique avec le chiffre. Le fichier 8-bit ne fait qu'environ 1,8 fois le 2-bit (259,1 ÷ 143,9 ≈ 1,8), pas 4 fois. Lisez la taille sur la page de téléchargement.
Essayez vous-mêmeEssayez : votre machine a 128 Go de mémoire au total. L'un de ces fichiers tient-il ?Afficher la réponse
Non. Même le plus petit, UD-IQ1_M, nécessite environ 134 Go de RAM plus VRAM à un contexte de 16K, donc 128 Go ne suffisent pas. Les fichiers 2-bit nécessitent environ 150–160+ Go.
Ce que vous perdez à 2 bits#
Comparez à l'enregistrement d'une photo en JPEG plus petit : l'essentiel de l'image survit, et les dégâts se voient dans les détails fins. Unsloth rapporte que son fichier 2-bit (143,9 Go) atteint 91,5 % d'accord pondéré avec le modèle d'origine sur sept catégories : code, maths, chat, outils, multilingue, raisonnement et agentique.
Lisez ce chiffre attentivement. C'est la mesure d'Unsloth elle-même, et la page ne précise ni la référence ni la pondération, donc traitez-la comme un guide approximatif et non comme un test indépendant. L'accord n'est pas non plus la précision : il dit à quel point le petit fichier se comporte comme le grand, pas à quelle fréquence l'un ou l'autre a raison. De petites différences peuvent s'accumuler sur une longue chaîne d'étapes, comme un agent exécutant vingt appels d'outils, donc essayez un quant sur votre propre tâche avant de vous y fier. Les niveaux plus élevés restent plus proches de l'original et coûtent plus de mémoire.
Télécharger ou appeler une API ?#
Disons que vous voulez essayer le modèle après avoir lu l'annonce. Choisissez la ligne qui vous ressemble.
Choisissez votre cas
Laquelle vous décrit ?
Choisissez une option pour voir la réponse
Un portable avec 16–32 Go de mémoire
La voie locale est fermée : même le fichier 1-bit nécessite environ 134 Go de RAM plus VRAM. Appelez plutôt un modèle via une API.
Une station de travail avec environ 192 Go de mémoire
Les fichiers 2-bit (environ 150–160+ Go nécessaires) tiennent avec de la marge. Les 3-bit nécessitent 176–208 Go selon le fichier, donc vérifiez le chiffre exact du fichier voulu avant de télécharger. Vérifiez d'abord la licence.
Je veux juste essayer un modèle via une API
Sautez le téléchargement. Un appel d'API est à l'usage : vous envoyez du texte et recevez une réponse, sans fichier de 130 Go sur le disque.
Pour la troisième ligne, une requête suffit pour voir ce que ça donne. Celle-ci va à DeepSeek-V4-Flash, qui a une fenêtre de contexte de 380K et répond jusqu'à 32 768 tokens, à un prix unique à toute heure du jour :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
La réponse revient dans choices[0]., et le champ usage vous indique combien de tokens vous avez payés. Vous ne savez pas ce qu'est un token ? L'explication en langage clair prend cinq minutes. MiniMax-M2.7 est disponible de la même façon, avec une fenêtre de contexte de 180K et jusqu'à 8 192 tokens par réponse. Les deux utilisent une API compatible OpenAI/Anthropic, et un seul solde couvre tous les modèles.
À quoi cela ressemble sur une facture ? Disons qu'un petit bot de support envoie 2 000 requêtes par jour, chacune avec 1 500 tokens en entrée et 500 en sortie. Une telle requête coûte $0.00015 sur MiniMax-M2.7. Voici la journée entière pour chaque modèle, à côté d'OpenRouter :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 2 000 requêtes | OpenRouter, 2 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1 500 tokens d'entrée et 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, en comptant entrée et sortie ensemble, CheapTokens revient moins cher qu'OpenRouter. Les prix actuels de chaque modèle sont sur la page de tarifs.
Si vous avez le matériel et voulez comparer vitesse et coûts d'exécution, Exécuter DeepSeek en local ou utiliser une API en fait le tour. Et attendez-vous à revoir ces mots bientôt : les poids ouverts de Kimi K3.1 Pro sont prévus le 4 novembre, comme l'explique notre article de lancement.


