AI per principiantiGuida
Cosa sono gli open weights? Spiegazione della quantizzazione 2-bit e 4-bit
Open weights significa che puoi scaricare i file del modello. La quantizzazione li riduce: scopri quanto costa in fedeltà il 2-bit e quando un'API è più semplice.
In questa pagina
Apri l'annuncio di un modello e vedi "open weights" accanto a un file chiamato UD-Q2_K_XL. In breve: open weights significa che lo sviluppatore ha pubblicato i file del modello, così chiunque può scaricarli ed eseguirli. 2-bit significa che ogni numero al suo interno è memorizzato con soli due bit: il file diventa molto più piccolo e il modello un po' più sfocato. Se preferisci evitare il download, puoi chiamare i modelli tramite un'API; la documentazione di CheapTokens mostra la prima richiesta.
L'esempio qui sotto è reale. La pagina del modello di Unsloth per MiniMax-M3.1-Flash (senza data; verificata il 27 ottobre 2026) elenca file GGUF da 129,4 GB a 259,1 GB per un modello che abbiamo trattato nel post di lancio di M3.1 Flash. Ogni dimensione e cifra di memoria qui proviene da quella pagina.
Le parole che continui a incontrare#
Immagina un mixer con 428 miliardi di manopole. L'addestramento regola ogni manopola finché l'output non suona bene. La posizione finale di tutte le manopole sono i pesi del modello. Pubblica quella lista e hai un modello open-weight; tienila sui tuoi server e l'unico modo per accedervi è un'API.
Flashcard
Parole che incontrerai in ogni annuncio
Tocca una carta per girarla
Due trappole per principianti. "Open-weight" non è automaticamente "libero per qualsiasi uso": decide la licenza, e la pagina di Unsloth non la indica, quindi leggi la model card (MiniMaxAI/ su Hugging Face) prima di costruire qualsiasi cosa commerciale. E "libero da scaricare" non è "libero da eseguire", come mostrano le sezioni successive.
Perché un modello è un download da 130–260 GB#
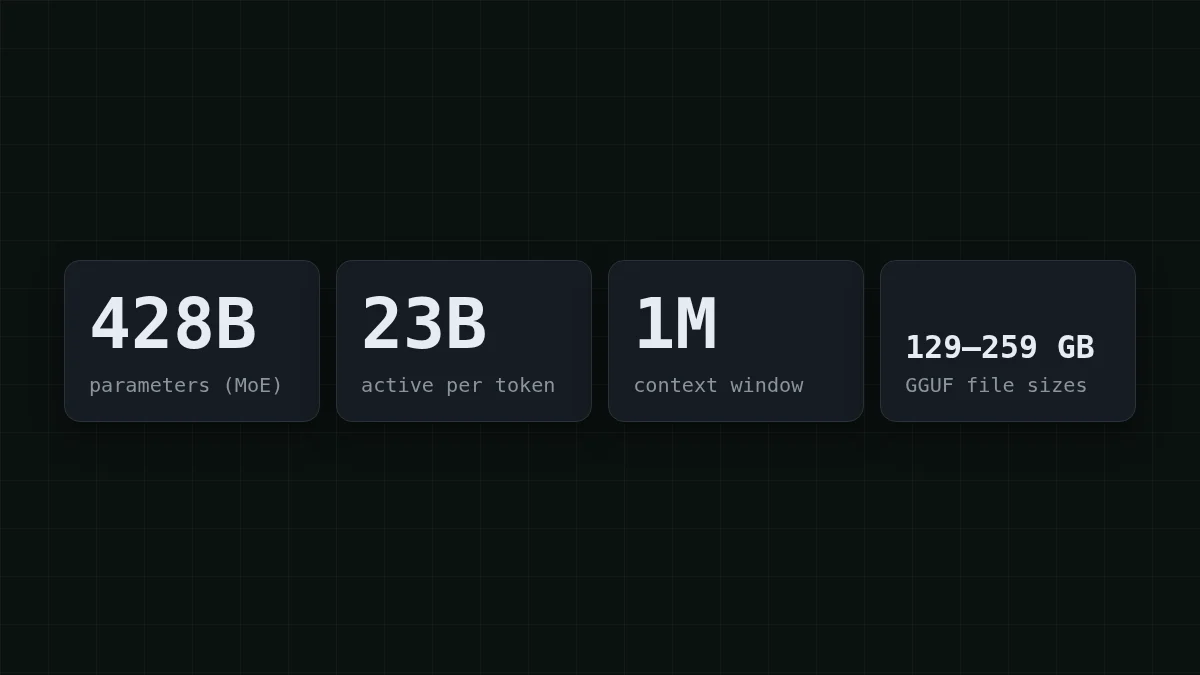
Ognuno di quei 428 miliardi di pesi è un numero, e i numeri occupano spazio. La regola pratica è conteggio × bit ÷ 8 = byte. Provala prima di continuare a leggere.
Indovina il numero
Quanti GB occupano 8 miliardi di pesi quando ognuno è memorizzato in 4 bit?
La tua risposta
016
Mostra risposta
Risposta: 4
4 bit sono mezzo byte, quindi 8 miliardi × 0,5 byte = 4 GB.
Ora aumenta la scala. Anche a 2 bit per peso, 428 × 2 ÷ 8 = 107 GB è il minimo per l'intero modello. Il vero file a 2 bit è 143,9 GB, un po' sopra il minimo, quindi il numero di bit nel nome di un file è un'etichetta più che un conteggio esatto.
La cifra "23B attivi" riguarda la velocità, non l'archiviazione. Solo una porzione del modello lavora su ogni token, il che lo rende veloce, ma la porzione cambia da token a token, quindi tutti i 428B di pesi devono essere caricati e in attesa.
Cosa fanno davvero 2-bit e 4-bit#
Pensa a un righello. I bit decidono quante tacche ha: 2 bit danno 4 tacche, 4 bit danno 16, 8 bit danno 256, e i soliti 16 bit danno 65.536. La quantizzazione arrotonda ogni peso alla tacca più vicina. Meno tacche significa un file più piccolo e un errore di arrotondamento maggiore su ogni numero.
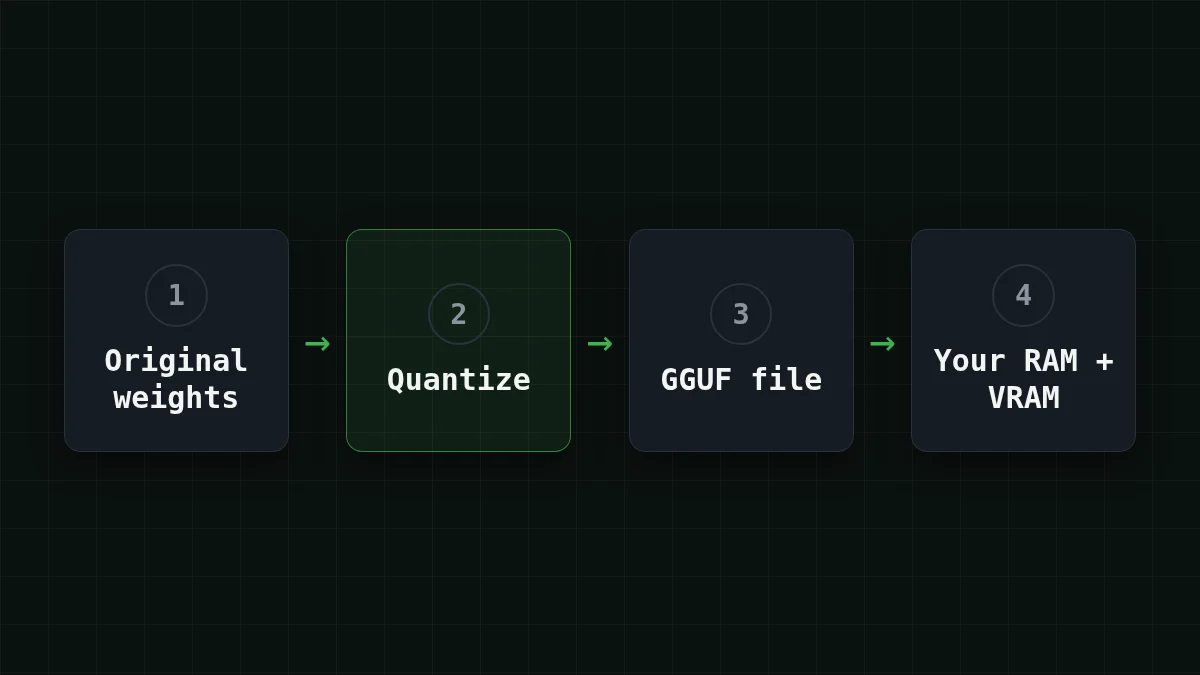
Ecco la gamma di Unsloth per il modello, con la memoria (RAM più VRAM) necessaria a contesto 16K per una sessione. Le dimensioni sono in GB decimali.
Scorri la tabella verso destra →
| Livello | File (dimensione) | Memoria necessaria |
|---|---|---|
| 1-bit | UD-IQ1_M (129,4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134,9 GB), UD-Q2_K_XL (143,9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160,0 GB), UD-IQ3_S (175,5 GB), UD-Q3_K_XL (194,0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249,4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259,1 GB) | ~272 GB |
Leggere un nome: UD-Q2_K_XL è una build Unsloth Dynamic a circa 2 bit; la cifra è il livello e le lettere sono le varianti. Non fare aritmetica con la cifra. Il file a 8 bit è solo circa 1,8 volte quello a 2 bit (259,1 ÷ 143,9 ≈ 1,8), non 4 volte. Leggi la dimensione dalla pagina di download.
Provalo tu stessoProva: la tua macchina ha 128 GB di memoria in totale. Qualcuno di questi file entra?Mostra risposta
No. Anche il più piccolo, UD-IQ1_M, richiede circa 134 GB di RAM più VRAM a contesto 16K, quindi 128 GB non bastano. I file a 2 bit richiedono circa 150–160+ GB.
Cosa perdi a 2 bit#
Confrontalo con il salvare una foto come JPEG più piccolo: la maggior parte dell'immagine sopravvive, e il danno si vede nei dettagli fini. Unsloth riporta che il suo file a 2 bit (143,9 GB) raggiunge una concordanza ponderata del 91,5% con il modello originale su sette categorie: coding, matematica, chat, strumenti, multilingua, ragionamento e agentico.
Leggi quel numero con attenzione. È una misura di Unsloth stesso, e la pagina non specifica la baseline né la ponderazione, quindi trattalo come una guida approssimativa e non come un test indipendente. La concordanza non è nemmeno accuratezza: dice quanto il file piccolo si comporta come quello grande, non quanto spesso l'uno o l'altro ha ragione. Piccole differenze possono sommarsi lungo una lunga catena di passaggi, come un agente che esegue venti chiamate a strumenti, quindi prova una quantizzazione sul tuo compito prima di affidarti ad essa. I livelli più alti restano più vicini all'originale e costano più memoria.
Scaricare o chiamare un'API?#
Diciamo che vuoi provare il modello dopo aver letto l'annuncio. Scegli la riga che ti somiglia.
Scegli il tuo caso
Quale ti descrive?
Scegli un'opzione per vedere la risposta
Un laptop con 16–32 GB di memoria
La via locale è chiusa: anche il file a 1 bit richiede circa 134 GB di RAM più VRAM. Chiama un modello tramite un'API invece.
Una workstation con circa 192 GB di memoria
I file a 2 bit (circa 150–160+ GB necessari) entrano con spazio a sufficienza. Quelli a 3 bit richiedono 176–208 GB a seconda del file, quindi controlla la cifra esatta per il file che vuoi prima di scaricare. Controlla prima la licenza.
Voglio solo provare un modello tramite un'API
Salta il download. Una chiamata API è pay-as-you-go: invii testo e ricevi una risposta, senza un file da 130 GB sul disco.
Per la terza riga, una richiesta basta per vedere come ci si sente. Questa va a DeepSeek-V4-Flash, che ha una finestra di contesto di 380K e risponde fino a 32.768 token, a un prezzo unico a qualsiasi ora del giorno:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
La risposta torna in choices[0]., e il campo usage ti dice per quanti token hai pagato. Non sai cos'è un token? La spiegazione in parole semplici richiede cinque minuti. MiniMax-M2.7 è disponibile allo stesso modo, con una finestra di contesto di 180K e fino a 8.192 token per risposta. Entrambi usano un'API compatibile OpenAI/Anthropic, e un solo saldo copre ogni modello.
Come appare in bolletta? Diciamo che un piccolo bot di supporto invia 2.000 richieste al giorno, ognuna con 1.500 token in ingresso e 500 in uscita. Una tale richiesta costa $0.00015 su MiniMax-M2.7. Ecco l'intera giornata per ogni modello, accanto a OpenRouter:
| Modello | Input $/1M | Output $/1M | Per richiesta | 2000 richieste | OpenRouter, 2000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1500 token di input e 500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In totale, contando insieme input e output, CheapTokens risulta più economico di OpenRouter. I prezzi attuali per ogni modello sono sulla pagina dei prezzi.
Se hai l'hardware e vuoi confrontare velocità e costi di esecuzione, Eseguire DeepSeek localmente o usare un'API lo analizza. E aspettati di rivedere queste parole presto: i pesi aperti per Kimi K3.1 Pro sono previsti per il 4 novembre, come spiega il nostro post di lancio.


