¿Qué son los pesos abiertos? La cuantización de 2 bits y 4 bits explicada
Los pesos abiertos significan que puedes descargar los archivos del modelo. La cuantización los reduce: descubre qué cuesta 2 bits en fidelidad y cuándo una API es más sencilla.
En esta página
Abres el anuncio de un modelo y ves «open weights» junto a un archivo llamado UD-Q2_K_XL. Respuesta corta: open weights significa que el desarrollador publicó los archivos del modelo, así que cualquiera puede descargarlos y ejecutarlos. 2-bit significa que cada número interno se almacena con solo dos bits: el archivo se vuelve mucho más pequeño y el modelo un poco más borroso. Si prefieres saltarte la descarga, puedes llamar a los modelos a través de una API; la documentación de CheapTokens muestra la primera petición.
El ejemplo siguiente es real. La página del modelo de Unsloth para MiniMax-M3.1-Flash (sin fecha; consultada el 27 de octubre de 2026) lista archivos GGUF desde 129,4 GB hasta 259,1 GB para un modelo que cubrimos en la entrada de lanzamiento de M3.1 Flash. Cada cifra de tamaño y memoria aquí proviene de esa página.
Las palabras que no dejas de encontrar#
Imagina una mesa de mezclas con 428 mil millones de diales. El entrenamiento ajusta cada dial hasta que la salida suena bien. La posición final de todos los diales son los pesos del modelo. Publica esa lista y tienes un modelo de pesos abiertos; mantenla en tus propios servidores y la única forma de entrar es una API.
Tarjetas de memoria
Palabras que encontrarás en cada anuncio
Toca una tarjeta para voltearla
Dos trampas para principiantes. «Pesos abiertos» no significa automáticamente «gratis para cualquier uso»: lo decide la licencia, y la página de Unsloth no la indica, así que lee la ficha del modelo (MiniMaxAI/ en Hugging Face) antes de construir nada comercial. Y «gratis para descargar» no es «gratis para ejecutar», como muestran las secciones siguientes.
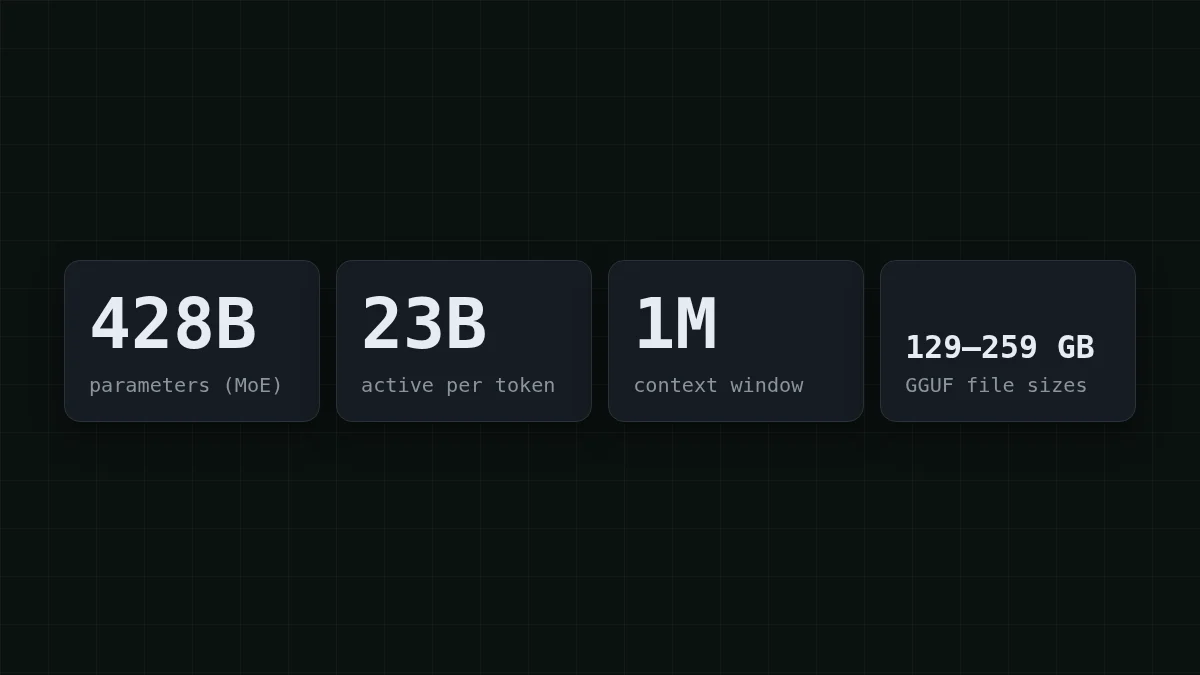
Por qué un solo modelo es una descarga de 130–260 GB#
Cada uno de esos 428 mil millones de pesos es un número, y los números ocupan espacio. La regla general es cantidad × bits ÷ 8 = bytes. Pruébalo antes de seguir leyendo.
Adivina el número
¿Cuántos GB ocupan 8 mil millones de pesos cuando cada uno se almacena en 4 bits?
Tu respuesta
016
Mostrar respuesta
Respuesta: 4
4 bits es medio byte, así que 8 mil millones × 0,5 byte = 4 GB.
Ahora escala. Incluso a 2 bits por peso, 428 × 2 ÷ 8 = 107 GB es el mínimo para todo el modelo. El archivo real de 2 bits es de 143,9 GB, algo por encima del mínimo, así que el número de bits en el nombre de un archivo es una etiqueta más que un recuento exacto.
La cifra «23B activos» tiene que ver con la velocidad, no con el almacenamiento. Solo una porción del modelo trabaja en cada token, lo que lo hace rápido, pero la porción cambia de un token a otro, así que los 428B de pesos tienen que estar cargados y esperando.
Qué hacen realmente 2 bits y 4 bits#
Piensa en una regla. Los bits deciden cuántas marcas tiene: 2 bits dan 4 marcas, 4 bits dan 16, 8 bits dan 256, y los habituales 16 bits dan 65.536. La cuantización redondea cada peso a la marca más cercana. Menos marcas significa un archivo más pequeño y un error de redondeo mayor en cada número.
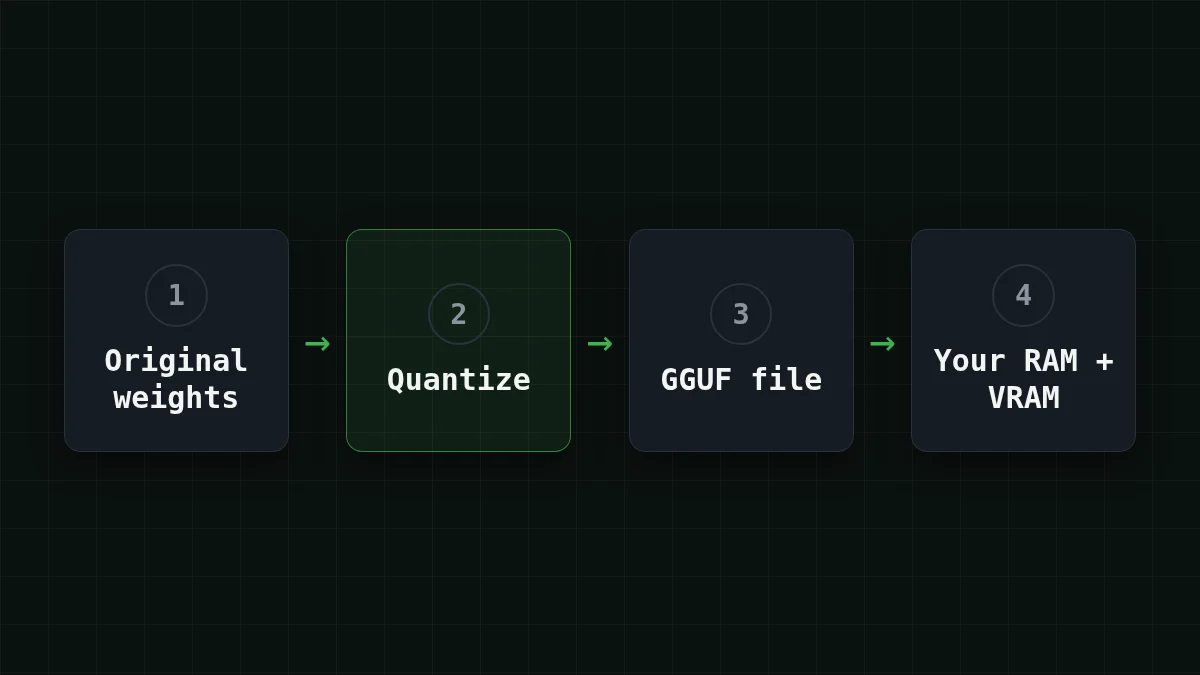
Aquí está la línea de Unsloth para el modelo, con la memoria (RAM más VRAM) que necesita a contexto de 16K para una sesión. Los tamaños están en GB decimales.
Desplaza la tabla hacia la derecha →
| Nivel | Archivos (tamaño) | Memoria necesaria |
|---|---|---|
| 1-bit | UD-IQ1_M (129,4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134,9 GB), UD-Q2_K_XL (143,9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160,0 GB), UD-IQ3_S (175,5 GB), UD-Q3_K_XL (194,0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249,4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259,1 GB) | ~272 GB |
Cómo leer un nombre: UD-Q2_K_XL es una compilación Dynamic de Unsloth de aproximadamente 2 bits; el dígito es el nivel y las letras son variantes. No hagas aritmética con el dígito. El archivo de 8 bits es solo unas 1,8 veces el de 2 bits (259,1 ÷ 143,9 ≈ 1,8), no 4 veces. Lee el tamaño en la página de descarga.
Pruébalo tú mismoPruébalo: tu máquina tiene 128 GB de memoria en total. ¿Cabe alguno de estos archivos?Mostrar respuesta
No. Incluso el más pequeño, UD-IQ1_M, necesita unos 134 GB de RAM más VRAM a contexto de 16K, así que 128 GB se queda corto. Los archivos de 2 bits necesitan unos 150–160+ GB.
Qué sacrificas a 2 bits#
Compáralo con guardar una foto como un JPEG más pequeño: la mayor parte de la imagen sobrevive, y el daño aparece en el detalle fino. Unsloth informa que su archivo de 2 bits (143,9 GB) alcanza un 91,5 % de concordancia ponderada con el modelo original en siete categorías: programación, matemáticas, chat, herramientas, multilingüe, razonamiento y agéntico.
Lee esa cifra con cuidado. Es una medida del propio Unsloth, y la página no detalla la línea base ni la ponderación, así que tómala como una guía aproximada y no como una prueba independiente. La concordancia tampoco es precisión: indica cuánto se parece el comportamiento del archivo pequeño al del grande, no con qué frecuencia acierta uno u otro. Las diferencias pequeñas pueden acumularse a lo largo de una cadena larga de pasos, como un agente que ejecuta veinte llamadas a herramientas, así que prueba un quant en tu propia tarea antes de confiar en él. Los niveles más altos se mantienen más cerca del original y cuestan más memoria.
¿Descargar o llamar a una API?#
Supón que quieres probar el modelo después de leer el anuncio. Elige la línea que se parezca a ti.
Elige tu caso
¿Cuál te describe?
Elige una opción para ver la respuesta
Un portátil con 16–32 GB de memoria
La vía local está cerrada: incluso el archivo de 1 bit necesita unos 134 GB de RAM más VRAM. Llama a un modelo a través de una API.
Una estación de trabajo con unos 192 GB de memoria
Los archivos de 2 bits (unos 150–160+ GB necesarios) caben con espacio de sobra. Los de 3 bits necesitan 176–208 GB según el archivo, así que comprueba la cifra exacta del archivo que quieres antes de descargarlo. Revisa primero la licencia.
Solo quiero probar un modelo a través de una API
Sáltate la descarga. Una llamada a la API es pago por uso: envías texto y recibes una respuesta, sin un archivo de 130 GB en el disco.
Para la tercera línea, una petición basta para ver cómo se siente. Esta va a DeepSeek-V4-Flash, que tiene una ventana de contexto de 380K y responde con hasta 32.768 tokens de longitud, a un precio a cualquier hora del día:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
La respuesta vuelve en choices[0]., y el campo usage te dice por cuántos tokens pagaste. ¿No tienes claro qué es un token? La explicación en lenguaje sencillo tarda cinco minutos. MiniMax-M2.7 está disponible de la misma forma, con una ventana de contexto de 180K y hasta 8.192 tokens por respuesta. Ambos usan una API compatible con OpenAI/Anthropic, y un solo saldo cubre todos los modelos.
¿Cómo se ve eso en una factura? Supón que un pequeño bot de soporte envía 2.000 peticiones al día, cada una con 1.500 tokens de entrada y 500 de salida. Una petición así cuesta $0.00015 en MiniMax-M2.7. Aquí está el día completo para cada modelo, junto a OpenRouter:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 2000 solicitudes | OpenRouter, 2000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1500 tokens de entrada y 500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En total, contando entrada y salida juntas, CheapTokens sale más barato que OpenRouter. Los precios actuales de cada modelo están en la página de precios.
Si tienes el hardware y quieres comparar velocidad y costes de ejecución, Ejecutar DeepSeek en local o usar una API lo repasa. Y espera estas palabras de nuevo pronto: los pesos abiertos de Kimi K3.1 Pro llegan el 4 de noviembre, como explica nuestra entrada de lanzamiento.


