نئے سیکھنے والوں کے لیے AIگائیڈ
open weights کیا ہیں؟ 2-bit اور 4-bit quantization کی وضاحت
Open weights کا مطلب ہے آپ ماڈل کی فائلیں ڈاؤن لوڈ کر سکتے ہیں۔ Quantization انہیں چھوٹا کرتا ہے: دیکھیں 2-bit وفاداری میں کیا خرچ کرتا ہے اور API کب آسان ہے۔
اس صفحہ پر
آپ ایک ماڈل کے اعلان کو کھولتے ہیں اور UD-Q2_K_XL نام کی فائل کے ساتھ "open weights" دیکھتے ہیں۔ مختصر جواب: open weights کا مطلب ہے کہ ڈویلپر نے ماڈل کی فائلیں شائع کی ہیں، لہٰذا کوئی بھی انہیں ڈاؤن لوڈ کر کے چلا سکتا ہے۔ 2-bit کا مطلب ہے کہ اندر کا ہر عدد صرف دو بٹس میں محفوظ ہے: فائل کافی چھوٹی ہو جاتی ہے اور ماڈل تھوڑا دھندلا ہو جاتا ہے۔ اگر آپ ڈاؤن لوڈ سے بچنا چاہیں تو آپ API کے ذریعے ماڈلز کو کال کر سکتے ہیں؛ CheapTokens docs پہلی درخواست دکھاتے ہیں۔
نیچے دی گئی مثال حقیقی ہے۔ MiniMax-M3.1-Flash کے لیے Unsloth کا ماڈل صفحہ (بغیر تاریخ؛ 27 اکتوبر 2026 کو چیک کیا گیا) ایک ایسے ماڈل کے لیے 129.4 GB سے 259.1 GB تک GGUF فائلیں درج کرتا ہے جس کا ہم نے M3.1 Flash launch post میں احاطہ کیا تھا۔ یہاں ہر سائز اور میموری کا عدد اسی صفحے سے ہے۔
وہ الفاظ جو آپ بار بار سنتے ہیں#
428 ارب ڈائلز والے مکسنگ ڈیسک کا تصور کریں۔ ٹریننگ ہر ڈائل کو اس وقت تک ہلکا سا موڑتی ہے جب تک آؤٹ پٹ درست نہ لگے۔ تمام ڈائلز کی آخری پوزیشن ماڈل کے weights ہیں۔ وہ فہرست شائع کریں اور آپ کے پاس open-weight ماڈل ہے؛ اسے اپنے سرورز پر رکھیں اور داخل ہونے کا واحد راستہ API ہے۔
فلیش کارڈز
وہ الفاظ جو آپ ہر اعلان میں دیکھیں گے
پلٹنے کے لیے کارڈ پر ٹیپ کریں
نئے لوگوں کے لیے دو پھندے۔ "Open-weight" خود بخود "کسی بھی استعمال کے لیے مفت" نہیں: لائسنس فیصلہ کرتا ہے، اور Unsloth کا صفحہ اسے بیان نہیں کرتا، لہٰذا کچھ تجارتی بنانے سے پہلے ماڈل کارڈ (Hugging Face پر MiniMaxAI/) پڑھیں۔ اور "ڈاؤن لوڈ کے لیے مفت" کا مطلب "چلانے کے لیے مفت" نہیں، جو اگلے حصے دکھاتے ہیں۔
ایک ماڈل 130–260 GB کا ڈاؤن لوڈ کیوں ہے#
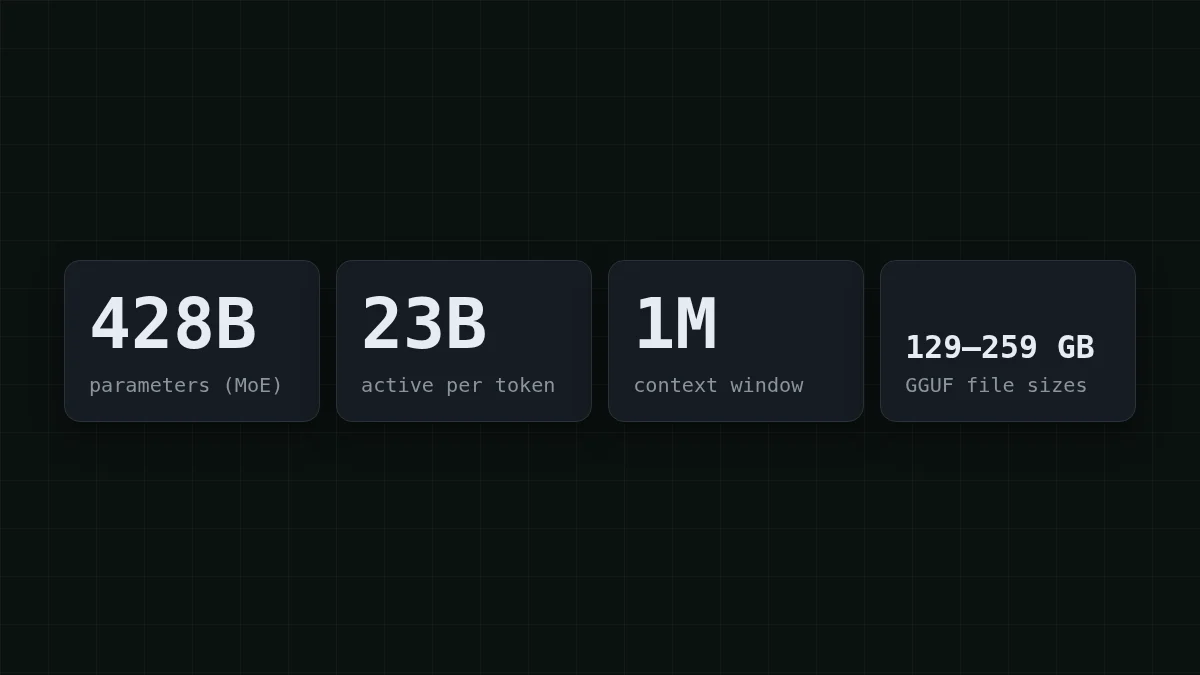
ان 428 ارب weights میں سے ہر ایک ایک عدد ہے، اور اعداد جگہ لیتے ہیں۔ قاعدہ یہ ہے: تعداد × بٹس ÷ 8 = بائٹس۔ آگے پڑھنے سے پہلے اسے آزمائیں۔
نمبر کا اندازہ لگائیں
8 ارب weights کتنے GB لیتے ہیں جب ہر ایک 4 بٹس میں محفوظ ہو؟
آپ کا اندازہ
016
جواب دکھائیں
جواب: 4
4 بٹس آدھا بائٹ ہے، لہٰذا 8 ارب × 0.5 بائٹ = 4 GB۔
اب بڑا پیمانہ لیں۔ فی weight 2 بٹس پر بھی، 428 × 2 ÷ 8 = 107 GB پورے ماڈل کی کم از کم حد ہے۔ اصل 2-bit فائل 143.9 GB ہے، حد سے تھوڑی اوپر، لہٰذا فائل کے نام میں بٹ کا عدد ایک لیبل ہے، درست گنتی نہیں۔
"23B active" کا عدد رفتار کے بارے میں ہے، اسٹوریج کے بارے میں نہیں۔ ہر ٹوکن پر ماڈل کا صرف ایک حصہ کام کرتا ہے، جو اسے تیز بناتا ہے، لیکن یہ حصہ ہر ٹوکن پر بدلتا ہے، لہٰذا تمام 428B weights لوڈ اور منتظر رہنے چاہئیں۔
2-bit اور 4-bit اصل میں کیا کرتے ہیں#
ایک پیمانے کا تصور کریں۔ بٹس طے کرتے ہیں کہ اس پر کتنے نشان ہیں: 2 بٹس 4 نشان دیتے ہیں، 4 بٹس 16، 8 بٹس 256، اور معمول کے 16 بٹس 65,536۔ Quantization ہر weight کو قریب ترین نشان پر گول کرتا ہے۔ کم نشان کا مطلب چھوٹی فائل اور ہر عدد پر بڑی گولائی کی غلطی۔
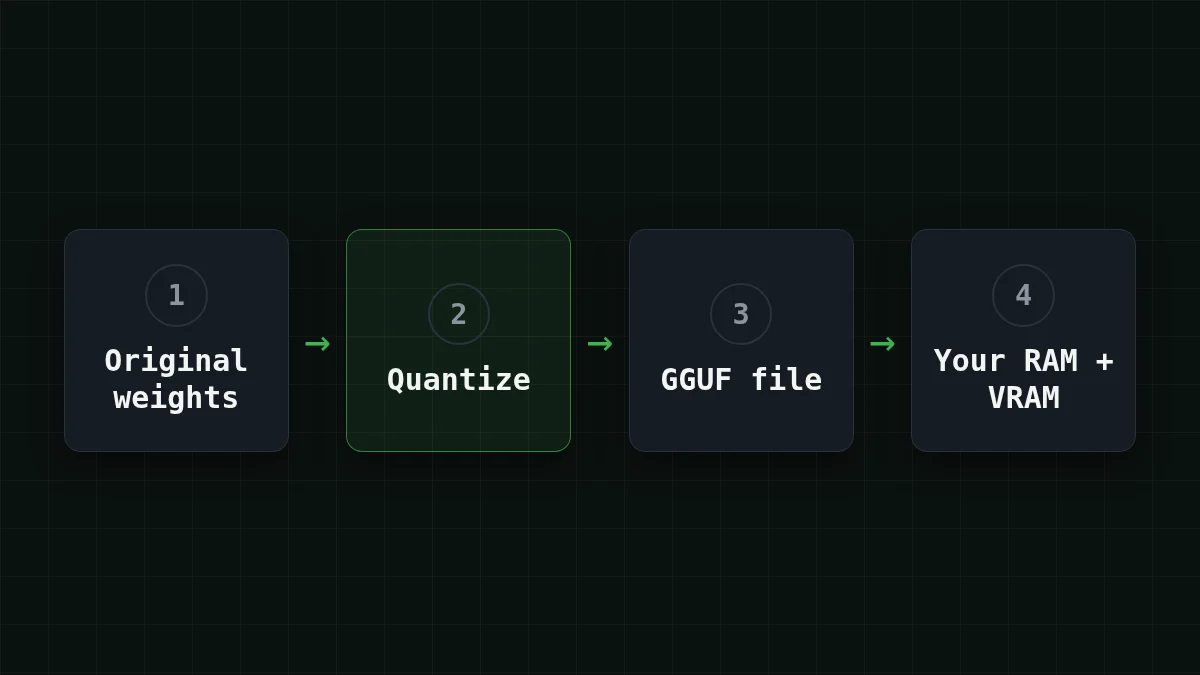
یہاں اس ماڈل کے لیے Unsloth کی لائن اپ ہے، اس میموری (RAM جمع VRAM) کے ساتھ جو ایک سیشن کے لیے 16K context پر درکار ہے۔ سائز اعشاری GB میں ہیں۔
ٹیبل کو دائیں طرف اسکرول کریں →
| Level | Files (size) | Memory needed |
|---|---|---|
| 1-bit | UD-IQ1_M (129.4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249.4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259.1 GB) | ~272 GB |
نام پڑھنا: UD-Q2_K_XL تقریباً 2 بٹس پر ایک Unsloth Dynamic build ہے؛ ہندسہ سطح ہے اور حروف مختلف قسمیں ہیں۔ ہندسے سے حساب نہ لگائیں۔ 8-bit فائل 2-bit والی سے صرف تقریباً 1.8 گنا ہے (259.1 ÷ 143.9 ≈ 1.8)، 4 گنا نہیں۔ سائز ڈاؤن لوڈ صفحے سے پڑھیں۔
خود آزمائیںآزمائیں: آپ کی مشین میں کل 128 GB میموری ہے۔ کیا ان میں سے کوئی فائل فٹ ہوتی ہے؟جواب دکھائیں
نہیں۔ سب سے چھوٹی، UD-IQ1_M، کو بھی 16K context پر تقریباً 134 GB RAM جمع VRAM درکار ہے، لہٰذا 128 GB کم ہے۔ 2-bit فائلوں کو تقریباً 150–160+ GB درکار ہے۔
2 بٹس پر آپ کیا کھو دیتے ہیں#
اسے تصویر کو چھوٹی JPEG کے طور پر محفوظ کرنے سے موازنہ کریں: تصویر کا زیادہ تر حصہ بچ جاتا ہے، اور نقصان باریک تفصیل میں ظاہر ہوتا ہے۔ Unsloth بتاتا ہے کہ اس کی 2-bit فائل (143.9 GB) سات زمروں—کوڈنگ، ریاضی، چیٹ، ٹولز، کثیراللسانی، استدلال اور ایجنٹک—میں اصل ماڈل کے ساتھ 91.5% وزنی اتفاق تک پہنچتی ہے۔
یہ عدد غور سے پڑھیں۔ یہ Unsloth کا اپنا پیمانہ ہے، اور صفحہ بنیادی خط اور وزن کاری واضح نہیں کرتا، لہٰذا اسے کھردری رہنمائی سمجھیں، آزاد جانچ نہیں۔ اتفاق درستگی بھی نہیں: یہ بتاتا ہے کہ چھوٹی فائل بڑی کی طرح کتنی قریب سے برتاؤ کرتی ہے، نہ یہ کہ کوئی کتنی بار درست ہے۔ چھوٹے فرق قدموں کی لمبی زنجیر میں جمع ہو سکتے ہیں، جیسے بیس ٹول کالز چلانے والا ایجنٹ، لہٰذا کسی quant پر انحصار کرنے سے پہلے اسے اپنے کام پر آزمائیں۔ زیادہ سطحیں اصل کے قریب رہتی ہیں اور زیادہ میموری لیتی ہیں۔
ڈاؤن لوڈ کریں یا API کال کریں؟#
فرض کریں آپ اعلان پڑھنے کے بعد ماڈل آزمایا چاہتے ہیں۔ وہ سطر چنیں جو آپ جیسے لگے۔
اپنا کیس منتخب کریں
کون سی آپ کو بیان کرتی ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
16–32 GB میموری والا لیپ ٹاپ
لوکل راستہ بند ہے: 1-bit فائل کو بھی تقریباً 134 GB RAM جمع VRAM درکار ہے۔ اس کے بجائے API کے ذریعے ماڈل کال کریں۔
تقریباً 192 GB میموری والا ورک سٹیشن
2-bit فائلیں (تقریباً 150–160+ GB درکار) کافی جگہ کے ساتھ فٹ ہو جاتی ہیں۔ 3-bit والیوں کو فائل کے مطابق 176–208 GB درکار ہے، لہٰذا ڈاؤن لوڈ سے پہلے اپنی مطلوبہ فائل کا درست عدد چیک کریں۔ پہلے لائسنس چیک کریں۔
میں صرف API کے ذریعے ماڈل آزمانا چاہتا ہوں
ڈاؤن لوڈ چھوڑ دیں۔ API کال pay-as-you-go ہے: آپ متن بھیجتے ہیں اور جواب پاتے ہیں، ڈسک پر 130 GB فائل کے بغیر۔
تیسری سطر کے لیے، یہ دیکھنے کے لیے ایک درخواست کافی ہے کہ یہ کیسا لگتا ہے۔ یہ والی DeepSeek-V4-Flash کو جاتی ہے، جس کی 380K context window ہے اور جو 32,768 ٹوکنز تک لمبے جواب دیتا ہے، دن کے کسی بھی وقت ایک ہی قیمت پر:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
جواب choices[0]. میں واپس آتا ہے، اور usage فیلڈ بتاتا ہے کہ آپ نے کتنے ٹوکنز کی ادائیگی کی۔ ٹوکن کیا ہے، یقین نہیں؟ plain-English explanation پانچ منٹ لیتی ہے۔ MiniMax-M2.7 اسی طرح دستیاب ہے، 180K context window اور فی جواب 8,192 ٹوکنز تک کے ساتھ۔ دونوں OpenAI/Anthropic-compatible API استعمال کرتے ہیں، اور ایک بیلنس ہر ماڈل کو کور کرتا ہے۔
بل پر یہ کیسا لگتا ہے؟ فرض کریں ایک چھوٹا سپورٹ بوٹ روزانہ 2,000 درخواستیں بھیجتا ہے، ہر ایک میں 1,500 ٹوکنز اندر اور 500 باہر۔ MiniMax-M2.7 پر ایسی ایک درخواست کی قیمت $0.00015 ہے۔ یہاں ہر ماڈل کے لیے پورا دن، OpenRouter کے ساتھ:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 2,000 درخواستیں | OpenRouter، 2,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
فی درخواست 1,500 ان پٹ اور 500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
مجموعی طور پر، ان پٹ اور آؤٹ پٹ کو ملا کر، CheapTokens OpenRouter سے سستا نکلتا ہے۔ ہر ماڈل کی موجودہ قیمتیں pricing page پر ہیں۔
اگر آپ کے پاس ہارڈ ویئر ہے اور رفتار اور چلانے کے اخراجات کا موازنہ کرنا چاہتے ہیں تو Run DeepSeek locally or use an API اس پر گزرتا ہے۔ اور توقع رکھیں کہ یہ الفاظ جلد پھر آئیں گے: Kimi K3.1 Pro کے open weights 4 نومبر کو متوقع ہیں، جیسا کہ ہماری launch post بیان کرتی ہے۔


