AI 入门指南
什么是开放权重?2-bit 和 4-bit 量化解释
开放权重意味着你可以下载模型文件。量化会缩小它们:看看 2-bit 在保真度上要付出什么代价,以及何时用 API 更简单。
你打开一则模型公告,看到名为 UD-Q2_K_XL 的文件旁边写着“开放权重”。简短回答:开放权重意味着开发者公开了模型文件,任何人都可以下载并运行。2-bit 意味着其中的每个数字只用两位来存储:文件会小得多,模型也会稍微模糊一些。如果你不想下载,也可以改为通过 API 调用模型;CheapTokens 文档展示了第一个请求。
下面的例子是真实的。Unsloth 的 MiniMax-M3.1-Flash 模型页面(未注明日期;2026 年 10 月 27 日核查)列出了从 129.4 GB 到 259.1 GB 的 GGUF 文件,这个模型我们在 M3.1 Flash 发布文章中介绍过。这里的每个大小和内存数字都来自该页面。
你会反复遇到的词#
想象一台有 4280 亿个旋钮的调音台。训练会微调每个旋钮,直到输出听起来正确。所有旋钮的最终位置就是模型的权重。公开这份列表,你就得到了一个开放权重模型;把它留在自己的服务器上,唯一的进入方式就是 API。
闪卡
每则公告里都会遇到的词
点击卡片翻转
初学者有两个陷阱。“开放权重”并不自动等于“可免费用于任何用途”:许可证说了算,而 Unsloth 的页面没有说明,所以在构建任何商业用途之前,请阅读模型卡(Hugging Face 上的 MiniMaxAI/)。而“可免费下载”也不等于“可免费运行”,接下来的章节会说明。
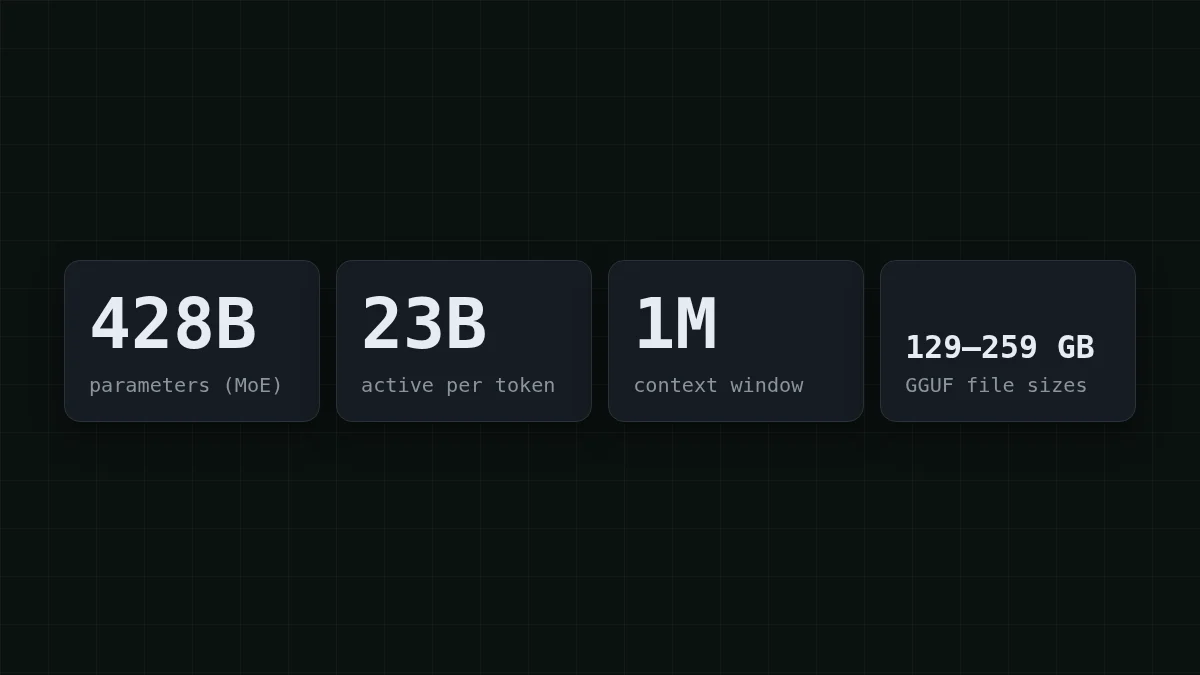
为什么一个模型要下载 130–260 GB#
这 4280 亿个权重中的每一个都是一个数字,而数字需要空间。经验法则是数量 × 位数 ÷ 8 = 字节数。在继续阅读之前先试一试。
猜数字
当每个权重以 4 位存储时,80 亿个权重占多少 GB?
你的猜测
016
显示答案
答案: 4
4 位是半个字节,所以 80 亿 × 0.5 字节 = 4 GB。
现在扩大规模。即使每个权重 2 位,428 × 2 ÷ 8 = 107 GB 也是整个模型的下限。实际的 2-bit 文件是 143.9 GB,略高于下限,所以文件名中的位数是一个标签,而不是精确计数。
“23B 激活”这个数字关乎速度,而非存储。每个 token 只有模型的一部分在工作,这使它很快,但这一部分会随 token 变化,所以全部 428B 权重都必须加载并待命。
2-bit 和 4-bit 实际做了什么#
想象一把尺子。位数决定它有多少个刻度:2 位给出 4 个刻度,4 位给出 16 个,8 位给出 256 个,而通常的 16 位给出 65,536 个。量化会把每个权重舍入到最近的刻度。刻度越少,文件越小,每个数字的舍入误差也越大。
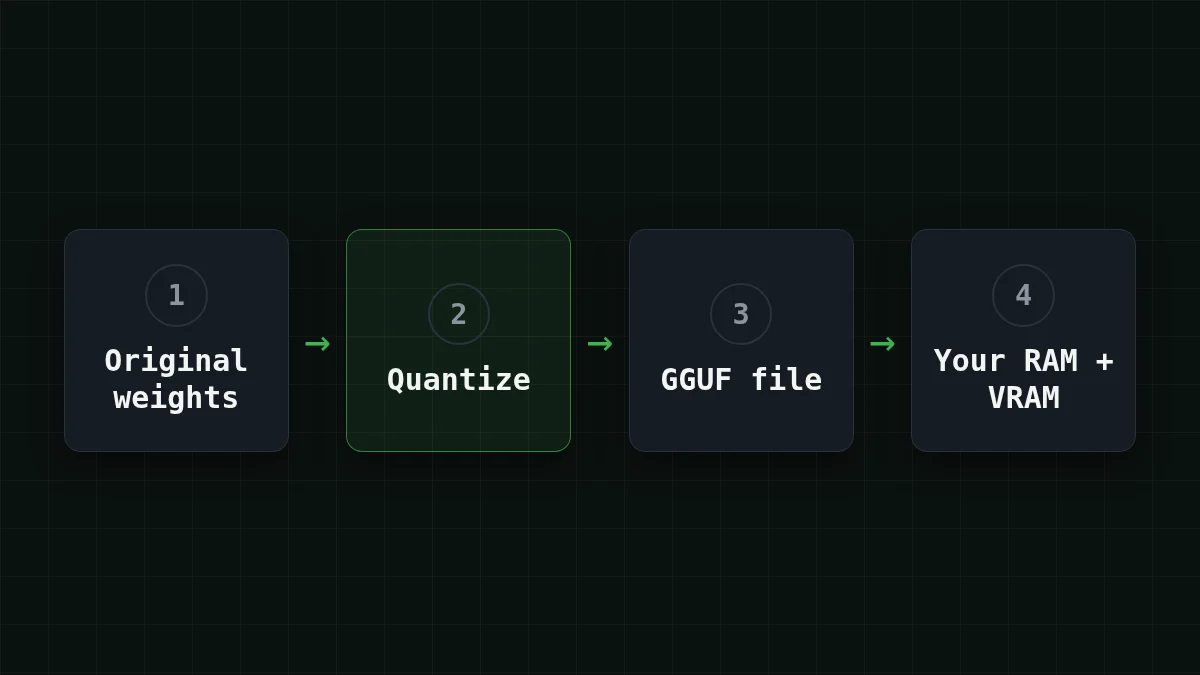
以下是 Unsloth 为该模型提供的产品线,以及在 16K 上下文、单次会话下所需的内存(RAM 加 VRAM)。大小以十进制 GB 表示。
向右滚动表格 →
| 级别 | 文件(大小) | 所需内存 |
|---|---|---|
| 1-bit | UD-IQ1_M (129.4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249.4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259.1 GB) | ~272 GB |
读名字:UD-Q2_K_XL 是 Unsloth Dynamic 构建,大约 2 位;数字是级别,字母是变体。不要用数字做算术。8-bit 文件大约只是 2-bit 文件的 1.8 倍(259.1 ÷ 143.9 ≈ 1.8),而不是 4 倍。从下载页面读取大小。
自己试试试一试:你的机器总共有 128 GB 内存。这些文件中有任何一个能装下吗?显示答案
不能。即使是最小的 UD-IQ1_M,在 16K 上下文下也需要约 134 GB 的 RAM 加 VRAM,所以 128 GB 不够。2-bit 文件需要约 150–160+ GB。
2 位时你放弃了什么#
把它比作把照片保存为更小的 JPEG:大部分画面保留下来,损坏体现在细节上。Unsloth 报告称,其 2-bit 文件(143.9 GB)在七个类别(编码、数学、聊天、工具、多语言、推理和智能体)上与原始模型达到 91.5% 的加权一致率。
仔细读这个数字。这是 Unsloth 自己的度量,页面没有说明基线或加权方式,所以把它当作粗略参考,而不是独立测试。一致率也不等于准确率:它说明小文件的行为与大文件有多接近,而不是两者中任何一个有多经常正确。小差异可能在长步骤链中累积,例如一个智能体运行二十次工具调用,所以在依赖某个量化版本之前,先在你自己的任务上试一试。更高级别更接近原始模型,但需要更多内存。
下载还是调用 API?#
假设你读完公告后想试试这个模型。选择听起来像你的那一行。
选择你的情况
哪一项描述了你?
选择一个选项以查看答案
一台有 16–32 GB 内存的笔记本电脑
本地路线行不通:即使 1-bit 文件也需要约 134 GB 的 RAM 加 VRAM。改为通过 API 调用模型。
一台约 192 GB 内存的工作站
2-bit 文件(需要约 150–160+ GB)装得下还有余量。3-bit 文件根据文件不同需要 176–208 GB,所以下载前要核对你想要文件的确切数字。先检查许可证。
我只想通过 API 试试模型
跳过下载。API 调用是按量付费:你发送文本并得到答案,磁盘上没有 130 GB 的文件。
对于第三行,一个请求就足以感受它。这个请求发往 DeepSeek-V4-Flash,它有 380K 上下文窗口,回答最长可达 32,768 个 token,全天任何时段价格相同:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
答案在 choices[0]. 中返回,usage 字段告诉你为多少 token 付费。不确定 token 是什么?通俗解释只需五分钟。MiniMax-M2.7 也以同样方式提供,具有 180K 上下文窗口,每次回答最多 8,192 个 token。两者都使用兼容 OpenAI/Anthropic 的 API,一个余额覆盖所有模型。
这在账单上是什么样子?假设一个小型支持机器人每天发送 2,000 个请求,每个请求输入 1,500 个 token、输出 500 个 token。在 MiniMax-M2.7 上,这样一个请求花费 $0.00015。以下是每个模型一整天的费用,与 OpenRouter 并列:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 2,000 次请求 | OpenRouter,2,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
每次请求 1,500 个输入 token 和 500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
总的来说,把输入和输出加在一起计算,CheapTokens 比 OpenRouter 更便宜。每个模型的最新价格在定价页面上。
如果你确实有硬件,想比较速度和运行成本,本地运行 DeepSeek 或使用 API会带你走一遍。而且预计很快会再次看到这些词:Kimi K3.1 Pro 的开放权重定于 11 月 4 日发布,正如我们的发布文章所解释的。


