AI 입문가이드
open weights란? 2비트와 4비트 양자화 설명
open weights는 모델 파일을 내려받을 수 있다는 뜻입니다. 양자화는 파일을 줄입니다. 2비트가 정확도에서 무엇을 포기하는지, API가 더 간단한 경우를 확인하세요.
모델 발표 글을 열면 UD-Q2_K_XL라는 파일 옆에 “open weights”라는 말이 보입니다. 짧게 답하면, open weights는 개발자가 모델 파일을 공개해서 누구나 내려받아 실행할 수 있다는 뜻입니다. 2-bit는 모델 안의 모든 숫자를 단 2비트로 저장한다는 뜻으로, 파일은 훨씬 작아지고 모델은 조금 더 흐릿해집니다. 내려받기를 건너뛰고 싶다면 API로 모델을 호출하면 됩니다. CheapTokens 문서에서 첫 요청 방법을 확인할 수 있습니다.
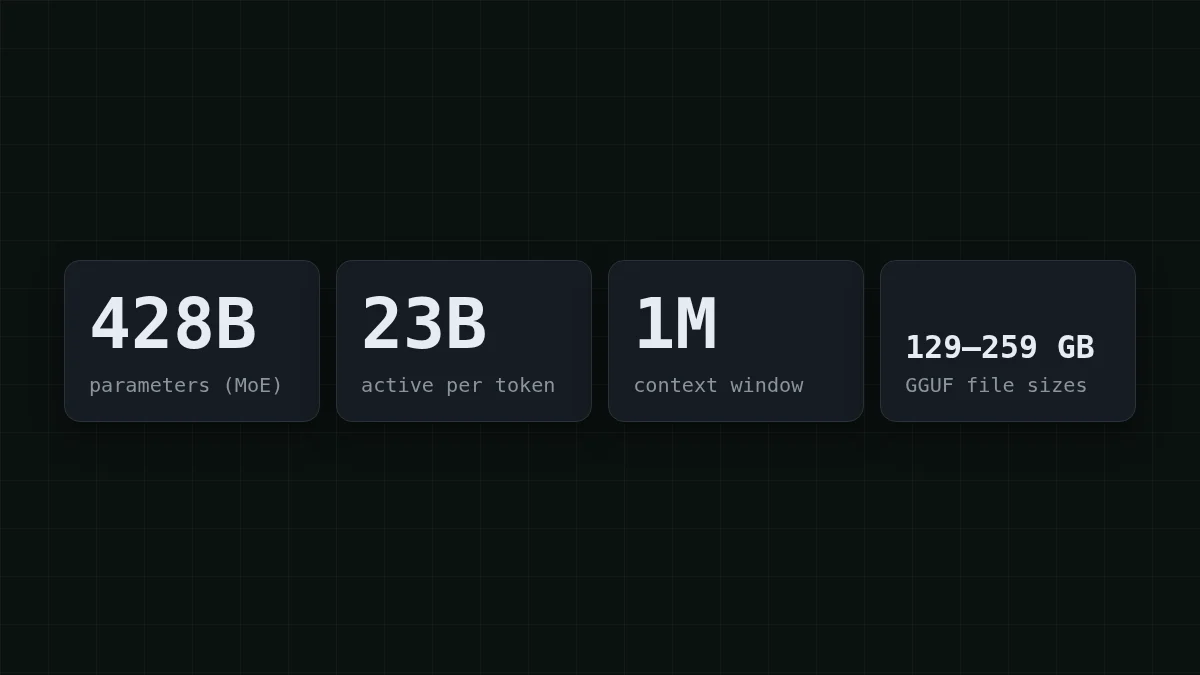
아래 예시는 실제 사례입니다. MiniMax-M3.1-Flash의 Unsloth 모델 페이지(날짜 미표기, 2026년 10월 27일 확인)에는 M3.1 Flash 출시 글에서 다룬 모델의 GGUF 파일이 129.4 GB에서 259.1 GB까지 나열되어 있습니다. 여기 나오는 모든 크기와 메모리 수치는 해당 페이지에서 가져온 것입니다.
계속 마주치는 용어들#
4280억 개의 다이얼이 달린 믹싱 콘솔을 상상해 보세요. 학습은 출력이 제대로 들릴 때까지 모든 다이얼을 조금씩 돌립니다. 모든 다이얼의 최종 위치가 모델의 **가중치(weights)**입니다. 이 목록을 공개하면 open-weight 모델이 되고, 자체 서버에 보관하면 API로만 접근할 수 있습니다.
플래시카드
모든 발표 글에서 만나게 될 용어
카드를 탭하여 뒤집기
초보자가 빠지기 쉬운 두 가지 함정이 있습니다. “Open-weight”가 자동으로 “어떤 용도로든 무료”를 뜻하지는 않습니다. 라이선스가 결정하며, Unsloth 페이지에는 라이선스가 명시되어 있지 않으므로 상업적으로 무엇이든 만들기 전에 모델 카드(Hugging Face의 MiniMaxAI/)를 읽어 보세요. 그리고 “무료로 내려받기”가 “무료로 실행하기”를 뜻하지도 않으며, 이는 다음 섹션들에서 보여 줍니다.
모델 하나가 130–260 GB 다운로드인 이유#
4280억 개의 가중치 각각은 숫자이고, 숫자는 공간을 차지합니다. 경험칙은 개수 × 비트 ÷ 8 = 바이트입니다. 계속 읽기 전에 직접 계산해 보세요.
숫자 맞히기
80억 개의 가중치를 각각 4비트로 저장하면 몇 GB가 될까요?
내 추측
016
정답 보기
정답: 4
4비트는 0.5바이트이므로 80억 × 0.5바이트 = 4 GB입니다.
이제 규모를 키워 봅시다. 가중치당 2비트라 해도 428 × 2 ÷ 8 = 107 GB가 전체 모델의 하한입니다. 실제 2비트 파일은 143.9 GB로 하한보다 조금 크므로, 파일 이름의 비트 수는 정확한 개수가 아니라 라벨에 가깝습니다.
“23B 활성” 수치는 저장 공간이 아니라 속도에 관한 것입니다. 토큰마다 모델의 일부만 동작하므로 빠르지만, 그 일부는 토큰마다 달라지므로 428B 가중치 전부가 메모리에 올라와 대기해야 합니다.
2비트와 4비트가 실제로 하는 일#
자를 떠올려 보세요. 비트는 자에 몇 개의 눈금이 있는지를 정합니다. 2비트면 4개, 4비트면 16개, 8비트면 256개, 일반적인 16비트면 65,536개입니다. 양자화는 모든 가중치를 가장 가까운 눈금으로 반올림합니다. 눈금이 적을수록 파일은 작아지고 각 숫자의 반올림 오차는 커집니다.
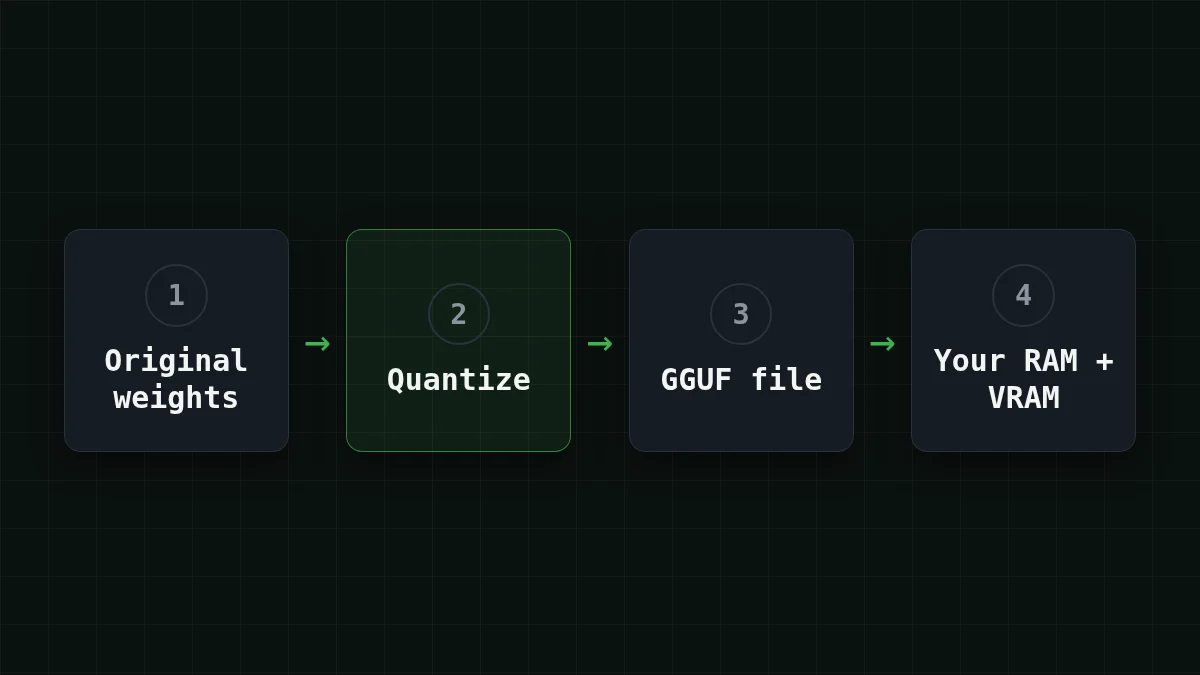
다음은 이 모델의 Unsloth 라인업으로, 한 세션에 16K 컨텍스트를 사용할 때 필요한 메모리(RAM + VRAM)를 보여 줍니다. 크기는 십진 GB입니다.
표를 오른쪽으로 스크롤하세요 →
| 레벨 | 파일 (크기) | 필요한 메모리 |
|---|---|---|
| 1-bit | UD-IQ1_M (129.4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134.9 GB), UD-Q2_K_XL (143.9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160.0 GB), UD-IQ3_S (175.5 GB), UD-Q3_K_XL (194.0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249.4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259.1 GB) | ~272 GB |
이름 읽는 법: UD-Q2_K_XL은 대략 2비트의 Unsloth Dynamic 빌드이며, 숫자는 레벨이고 문자는 변형입니다. 숫자로 산수를 하지 마세요. 8비트 파일은 2비트 파일의 약 1.8배(259.1 ÷ 143.9 ≈ 1.8)일 뿐, 4배가 아닙니다. 크기는 다운로드 페이지에서 확인하세요.
직접 해보기직접 해 보기: 여러분의 머신에는 총 128 GB의 메모리가 있습니다. 이 파일 중 하나라도 들어갈까요?정답 보기
아니요. 가장 작은 UD-IQ1_M조차 16K 컨텍스트에서 약 134 GB의 RAM과 VRAM이 필요하므로 128 GB로는 부족합니다. 2비트 파일은 약 150–160+ GB가 필요합니다.
2비트에서 포기하는 것#
사진을 더 작은 JPEG로 저장하는 것과 비교해 보세요. 그림의 대부분은 살아남고 손상은 세부 묘사에서 드러납니다. Unsloth에 따르면 2비트 파일(143.9 GB)은 코딩, 수학, 채팅, 도구, 다국어, 추론, 에이전트의 일곱 범주에서 원본 모델과 91.5%의 가중 일치율을 보입니다.
이 숫자를 주의 깊게 읽으세요. Unsloth 자체 측정치이며, 페이지에 기준선이나 가중치 방식이 명시되어 있지 않으므로 독립적인 테스트가 아니라 대략적인 지침으로 받아들여야 합니다. 일치율은 정확도와도 다릅니다. 작은 파일이 큰 파일처럼 얼마나 가깝게 동작하는지를 말할 뿐, 둘 중 어느 쪽이 얼마나 자주 맞는지를 말하지는 않습니다. 에이전트가 도구를 스무 번 호출하는 것처럼 긴 단계의 연쇄에서는 작은 차이가 누적될 수 있으므로, 양자화 모델에 의존하기 전에 자신의 작업에서 시험해 보세요. 더 높은 레벨은 원본에 더 가깝게 유지되지만 메모리를 더 많이 씁니다.
다운로드할까, API를 호출할까?#
발표 글을 읽고 모델을 시험해 보고 싶다고 해 봅시다. 자신에게 해당하는 줄을 고르세요.
사례 선택하기
어떤 상황인가요?
답을 보려면 옵션을 선택하세요
메모리 16–32 GB의 노트북
로컬 경로는 닫혀 있습니다. 1비트 파일조차 약 134 GB의 RAM과 VRAM이 필요합니다. 대신 API로 모델을 호출하세요.
메모리 약 192 GB의 워크스테이션
2비트 파일(약 150–160+ GB 필요)은 여유 있게 들어갑니다. 3비트 파일은 파일에 따라 176–208 GB가 필요하므로, 내려받기 전에 원하는 파일의 정확한 수치를 확인하세요. 라이선스를 먼저 확인하세요.
API로 모델을 시험해 보고 싶을 뿐
내려받기를 건너뛰세요. API 호출은 사용한 만큼 지불하는 방식으로, 텍스트를 보내면 답을 받고 디스크에 130 GB 파일이 남지 않습니다.
세 번째 경우라면 요청 한 번으로 느낌을 알 수 있습니다. 다음 요청은 380K 컨텍스트 윈도우를 갖고 최대 32,768 토큰 길이로 답하며 하루 중 어느 시간에도 같은 가격인 DeepSeek-V4-Flash로 갑니다.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
답은 choices[0].로 돌아오고, usage 필드가 지불한 토큰 수를 알려 줍니다. 토큰이 무엇인지 모르겠다면 쉬운 설명이 5분이면 충분합니다. MiniMax-M2.7도 같은 방식으로 사용할 수 있으며, 180K 컨텍스트 윈도우와 답변당 최대 8,192 토큰을 제공합니다. 둘 다 OpenAI/Anthropic 호환 API를 사용하며, 하나의 잔액으로 모든 모델을 이용할 수 있습니다.
청구서에서는 어떻게 보일까요? 작은 지원 봇이 하루에 2,000건의 요청을 보내고, 각 요청이 입력 1,500 토큰과 출력 500 토큰이라고 해 봅시다. MiniMax-M2.7에서 이런 요청 하나의 비용은 $0.00015입니다. 다음은 각 모델의 하루 전체 비용을 OpenRouter와 나란히 비교한 것입니다.
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 2,000회 요청 | OpenRouter, 2,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
요청당 입력 1,500개 및 출력 500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
입력과 출력을 합산한 총액에서 CheapTokens가 OpenRouter보다 저렴합니다. 모든 모델의 현재 가격은 가격 페이지에서 확인할 수 있습니다.
하드웨어가 있고 속도와 실행 비용을 비교하고 싶다면 DeepSeek을 로컬에서 실행하거나 API 사용하기에서 자세히 다룹니다. 그리고 곧 이 용어들을 다시 만나게 될 것입니다. Kimi K3.1 Pro의 open weights가 11월 4일에 공개될 예정이며, 자세한 내용은 출시 글에 나와 있습니다.


