AI untuk pemulaPanduan
Apa itu open weights? Penjelasan quantization 2-bit dan 4-bit
Open weights berarti Anda dapat mengunduh file model. Quantization mengecilkannya: lihat apa yang dikorbankan 2-bit dalam hal fidelitas dan kapan API lebih sederhana.
Di halaman ini
Anda membuka pengumuman model dan melihat “open weights” di samping file bernama UD-Q2_K_XL. Jawaban singkatnya: open weights berarti pengembang menerbitkan file model, sehingga siapa pun dapat mengunduh dan menjalankannya. 2-bit berarti setiap angka di dalamnya disimpan hanya dengan dua bit: file menjadi jauh lebih kecil dan model sedikit lebih kabur. Jika Anda lebih memilih melewati unduhan, Anda dapat memanggil model melalui API; dokumentasi CheapTokens menunjukkan permintaan pertama.
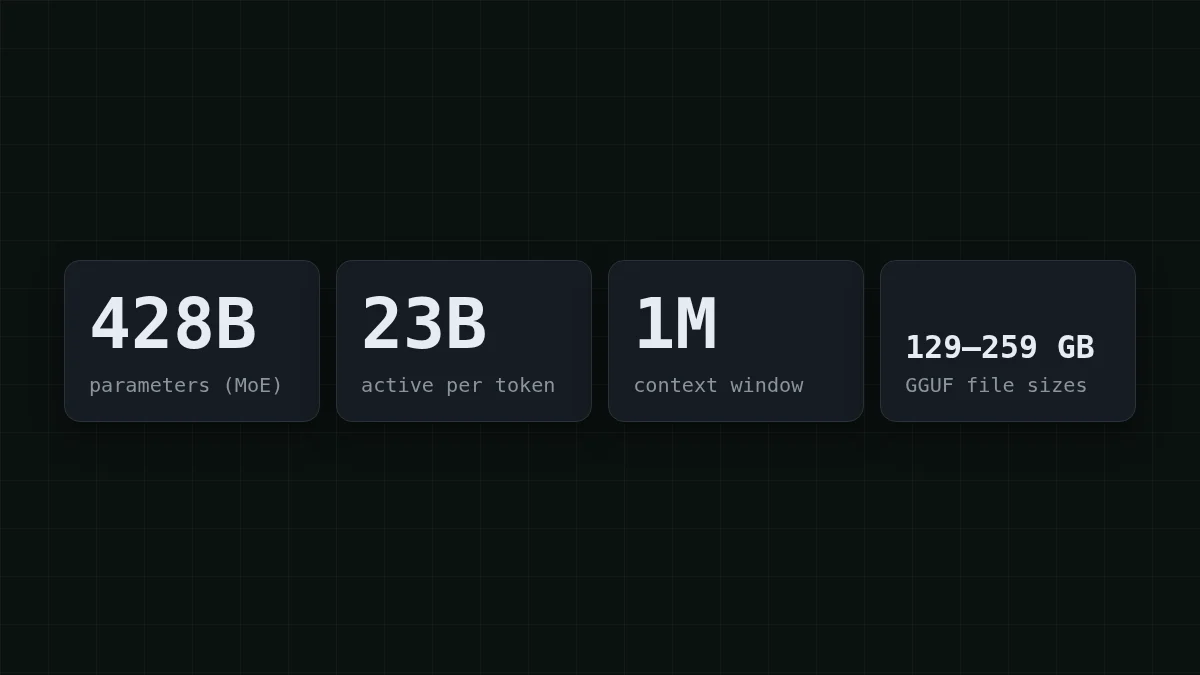
Contoh di bawah ini nyata. Halaman model Unsloth untuk MiniMax-M3.1-Flash (tanpa tanggal; diperiksa 27 Oktober 2026) mencantumkan file GGUF dari 129,4 GB hingga 259,1 GB untuk model yang kami bahas di posting peluncuran M3.1 Flash. Setiap ukuran dan angka memori di sini berasal dari halaman tersebut.
Istilah yang terus Anda temui#
Bayangkan sebuah mixing desk dengan 428 miliar tombol. Pelatihan menggeser setiap tombol hingga output terdengar tepat. Posisi akhir semua tombol adalah weights model. Terbitkan daftar itu dan Anda memiliki model open-weight; simpan di server Anda sendiri dan satu-satunya jalan masuk adalah API.
Kartu kilat
Istilah yang akan Anda temui di setiap pengumuman
Ketuk kartu untuk membaliknya
Dua jebakan bagi pemula. “Open-weight” tidak otomatis “gratis untuk penggunaan apa pun”: lisensi yang menentukan, dan halaman Unsloth tidak menyebutkannya, jadi baca model card (MiniMaxAI/ di Hugging Face) sebelum membangun apa pun untuk komersial. Dan “gratis diunduh” bukan “gratis dijalankan”, yang ditunjukkan bagian berikutnya.
Mengapa satu model berukuran unduhan 130–260 GB#
Masing-masing dari 428 miliar weight itu adalah angka, dan angka memakan ruang. Aturan praktisnya adalah jumlah × bit ÷ 8 = byte. Coba dulu sebelum membaca lanjut.
Tebak angkanya
Berapa GB yang dibutuhkan 8 miliar weight jika masing-masing disimpan dalam 4 bit?
Tebakan Anda
016
Tampilkan jawaban
Jawaban: 4
4 bit adalah setengah byte, jadi 8 miliar × 0,5 byte = 4 GB.
Sekarang perbesar skalanya. Bahkan pada 2 bit per weight, 428 × 2 ÷ 8 = 107 GB adalah batas bawah untuk seluruh model. File 2-bit yang sebenarnya adalah 143,9 GB, sedikit di atas batas bawah, jadi angka bit dalam nama file adalah label, bukan hitungan pasti.
Angka “23B aktif” berkaitan dengan kecepatan, bukan penyimpanan. Hanya sebagian dari model yang bekerja pada setiap token, yang membuatnya cepat, tetapi bagian itu berubah dari token ke token, sehingga semua 428B weight harus dimuat dan siap.
Apa yang sebenarnya dilakukan 2-bit dan 4-bit#
Bayangkan sebuah penggaris. Bit menentukan berapa banyak tanda yang dimilikinya: 2 bit memberi 4 tanda, 4 bit memberi 16, 8 bit memberi 256, dan 16 bit yang biasa memberi 65.536. Quantization membulatkan setiap weight ke tanda terdekat. Semakin sedikit tanda berarti file lebih kecil dan galat pembulatan lebih besar pada setiap angka.
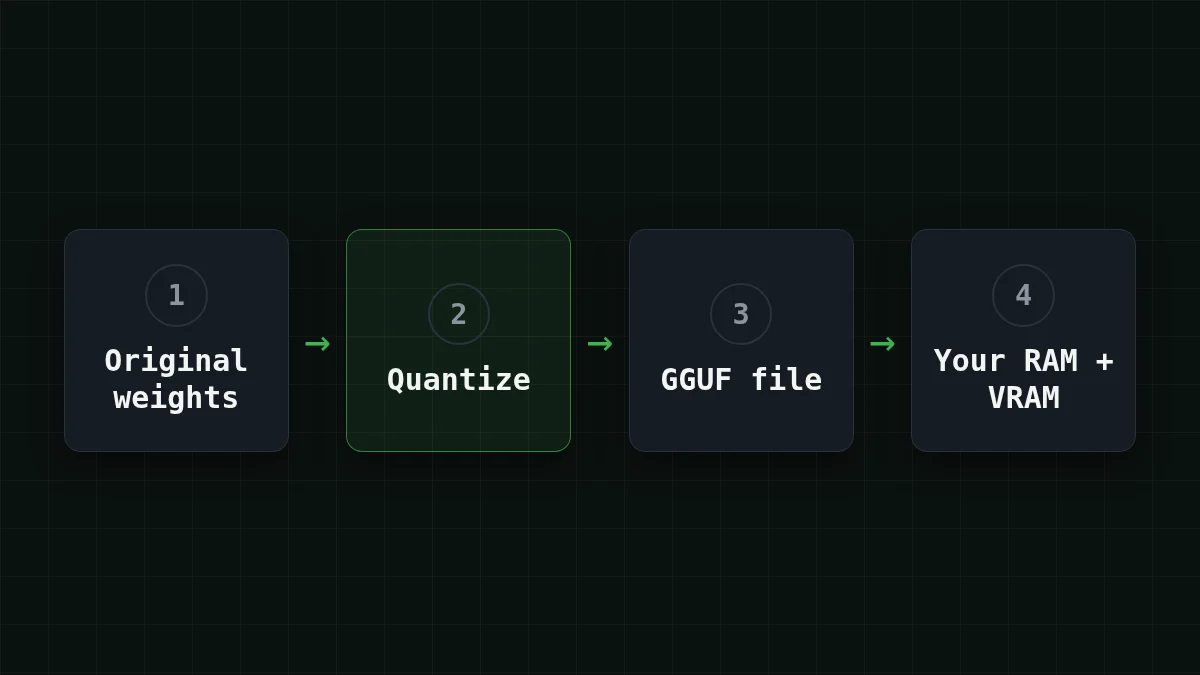
Berikut lineup Unsloth untuk model ini, dengan memori (RAM plus VRAM) yang dibutuhkan pada konteks 16K untuk satu sesi. Ukuran dalam GB desimal.
Gulir tabel ke kanan →
| Level | File (ukuran) | Memori yang dibutuhkan |
|---|---|---|
| 1-bit | UD-IQ1_M (129,4 GB) | ~134 GB |
| 2-bit | UD-IQ2_XXS (134,9 GB), UD-Q2_K_XL (143,9 GB) | ~150–160+ GB |
| 3-bit | UD-IQ3_XXS (160,0 GB), UD-IQ3_S (175,5 GB), UD-Q3_K_XL (194,0 GB) | 176–208 GB |
| 4-bit | UD-Q4_K_XL (249,4 GB) | ~256 GB |
| 8-bit | UD-Q8_K_XL (259,1 GB) | ~272 GB |
Membaca nama: UD-Q2_K_XL adalah build Unsloth Dynamic pada sekitar 2 bit; digitnya adalah level dan hurufnya adalah varian. Jangan melakukan aritmetika dengan digit tersebut. File 8-bit hanya sekitar 1,8 kali file 2-bit (259,1 ÷ 143,9 ≈ 1,8), bukan 4 kali. Baca ukurannya dari halaman unduhan.
Coba sendiriCoba: mesin Anda memiliki total memori 128 GB. Apakah ada file ini yang muat?Tampilkan jawaban
Tidak. Bahkan yang terkecil, UD-IQ1_M, membutuhkan sekitar 134 GB RAM plus VRAM pada konteks 16K, jadi 128 GB kurang. File 2-bit membutuhkan sekitar 150–160+ GB.
Apa yang Anda korbankan pada 2 bit#
Bandingkan dengan menyimpan foto sebagai JPEG yang lebih kecil: sebagian besar gambar tetap bertahan, dan kerusakannya muncul pada detail halus. Unsloth melaporkan bahwa file 2-bit-nya (143,9 GB) mencapai kesepakatan berbobot 91,5% dengan model asli di tujuh kategori: coding, matematika, chat, tools, multibahasa, penalaran, dan agentic.
Baca angka itu dengan cermat. Itu adalah ukuran milik Unsloth sendiri, dan halaman tersebut tidak menjelaskan baseline atau pembobotannya, jadi anggap sebagai panduan kasar dan bukan uji independen. Kesepakatan juga bukan akurasi: itu menunjukkan seberapa mirip perilaku file kecil dengan file besar, bukan seberapa sering salah satunya benar. Perbedaan kecil dapat menumpuk sepanjang rantai langkah yang panjang, seperti agen yang menjalankan dua puluh panggilan tool, jadi coba quant pada tugas Anda sendiri sebelum mengandalkannya. Level yang lebih tinggi tetap lebih dekat ke aslinya dan memakan memori lebih banyak.
Unduh atau panggil API?#
Katakanlah Anda ingin mencoba model setelah membaca pengumuman. Pilih baris yang terdengar seperti Anda.
Pilih kasus Anda
Mana yang menggambarkan Anda?
Pilih opsi untuk melihat jawabannya
Laptop dengan memori 16–32 GB
Jalur lokal tertutup: bahkan file 1-bit membutuhkan sekitar 134 GB RAM plus VRAM. Panggil model melalui API sebagai gantinya.
Workstation dengan memori sekitar 192 GB
File 2-bit (membutuhkan sekitar 150–160+ GB) muat dengan sisa ruang. File 3-bit membutuhkan 176–208 GB tergantung filenya, jadi periksa angka pastinya untuk file yang Anda inginkan sebelum mengunduh. Periksa lisensinya terlebih dahulu.
Saya hanya ingin mencoba model melalui API
Lewati unduhan. Panggilan API bersifat pay-as-you-go: Anda mengirim teks dan mendapatkan jawaban, tanpa file 130 GB di disk.
Untuk baris ketiga, satu permintaan cukup untuk merasakannya. Yang ini menuju DeepSeek-V4-Flash, yang memiliki jendela konteks 380K dan menjawab hingga 32.768 token, dengan satu harga pada jam berapa pun:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "In two sentences: what does open-weight mean?"}], "max_tokens": 200}'
Jawabannya kembali dalam choices[0]., dan field usage memberi tahu Anda berapa token yang Anda bayar. Tidak yakin apa itu token? Penjelasan bahasa sederhana memakan waktu lima menit. MiniMax-M2.7 tersedia dengan cara yang sama, dengan jendela konteks 180K dan hingga 8.192 token per jawaban. Keduanya menggunakan API yang kompatibel dengan OpenAI/Anthropic, dan satu saldo mencakup semua model.
Bagaimana itu terlihat di tagihan? Katakanlah sebuah bot dukungan kecil mengirim 2.000 permintaan sehari, masing-masing dengan 1.500 token masuk dan 500 keluar. Satu permintaan seperti itu berbiaya $0.00015 pada MiniMax-M2.7. Berikut seluruh hari untuk setiap model, di samping OpenRouter:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 2.000 permintaan | OpenRouter, 2.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00005 | $0.10 | $0.20 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000073 | $0.145 | $0.299 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00015 | $0.30 | $2.10 |
1.500 token input dan 500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Secara total, dengan input dan output dihitung bersama, CheapTokens lebih murah daripada OpenRouter. Harga terkini untuk setiap model ada di halaman harga.
Jika Anda memang memiliki perangkat kerasnya dan ingin membandingkan kecepatan serta biaya menjalankan, Jalankan DeepSeek secara lokal atau gunakan API membahasnya. Dan nantikan istilah-istilah ini lagi segera: open weights untuk Kimi K3.1 Pro dijadwalkan pada 4 November, seperti yang dijelaskan posting peluncuran kami.


