コスト最適化ガイド
マルチエージェントのハンドオフコスト:3エージェントチェーンがトークンで何を使うか
チェーン内の各エージェントが以前のすべてのハンドオフを再び読む理由、それがトークンでどれだけかかるか、入力を縮める3つの変更をご覧ください。
このページの内容
3つのエージェントが仕事を終え、請求額は仕事の見た目より大きくなっています。理由は単純です。テキストのハンドオフでは、各エージェントが前のエージェントが書いたすべてを読むためにお金を払うからです。1,500トークンの計画は、プランナーが書くときに一度支払われ、次にコーダーが、そしてレビュアーがまた支払います。ハンドオフを削り、各エージェントに必要なものだけを渡せば、後続の各エージェントの入力は小さくなります。
以下では、3エージェントの実例とそのトークン計算、実際の価格での1日100タスクのコスト見積もり、そして今日からできる3つの変更を紹介します。chat-completions APIはステートレスなので、すべてのリクエストが完全なコンテキストを再び運びます(長いチャットが高くつく理由とmessages配列の仕組みで基本を説明しています)。
トークンが積み上がる場所#
プランナー、コーダー、レビュアーを動かすとします。タスクと指示で1,000トークンです。プランナーは1,500トークンの計画を書き、コーダーは3,000トークンのコードとメモを書き、レビュアーは800トークンの判定を書きます。これらは例のための丸めた数字であり、実測値ではありません。usageフィールドから自分の数字に置き換えてください(読み方)。
数字を当てる
レビュアーは入力として何トークンを読むでしょうか?
あなたの予想
08,000
答えを表示
答え: 5,500
5,500:タスク(1,000)、計画(1,500)、コード(3,000)がすべてそのリクエストに届きます。
各エージェントの入力は、タスクと受け取るすべてのハンドオフです:
テーブルを右にスクロールしてください →
| エージェント | 読む(入力) | 書く(出力) |
|---|---|---|
| プランナー | 1,000(タスク) | 1,500 |
| コーダー | 1,000 + 1,500 = 2,500 | 3,000 |
| レビュアー | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| チェーン全体 | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
チェーンは5,300を生み出すために9,000トークンを読みます。4番目のエージェントを追加すると、タスクと3つのハンドオフすべてを読むので、入力は1つのハンドオフ分だけでなく、ホップごとに増えます。
1日100タスクのコスト#
ハンドオフトークンは、エージェントが書くときに出力として一度請求され、その後それを読む後続の各エージェントの入力として請求されます。出力トークンは入力トークンより高く価格設定されているので、この例ではチェーンが書くより多く読むにもかかわらず、回答が請求額のより大きな割合を占めます(入力トークンと出力トークン)。
1タスクは入力9,000トークン、出力5,300トークンです。MiniMax-M2.7では1タスクあたり$0.0012です。1日100タスクでは、これが当社モデル全体の実際の価格で、OpenRouterと並べたものです:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 100 リクエスト | OpenRouter、100 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
リクエストあたり 9,000 入力トークンと 5,300 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
合計で、入力と出力を合わせて数えると、上記のCheapTokensモデルはこのチェーンでOpenRouterより安くなります。
自分のチェーンで計算したいですか?1つのエージェントの平均リクエストを計算機に入れてください:約3,000トークン入力、1,800出力を300回繰り返すと、3エージェントの100タスクになります。
コスト計算機
1日100タスク、各3エージェント
リクエストあたりの入力トークン数: 3,000 · リクエストあたりの出力トークン数: 1,800 · 1日あたりのリクエスト数: 300
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
請求額を減らす3つの方法#
1. ハンドオフを短い構造化ノートにする#
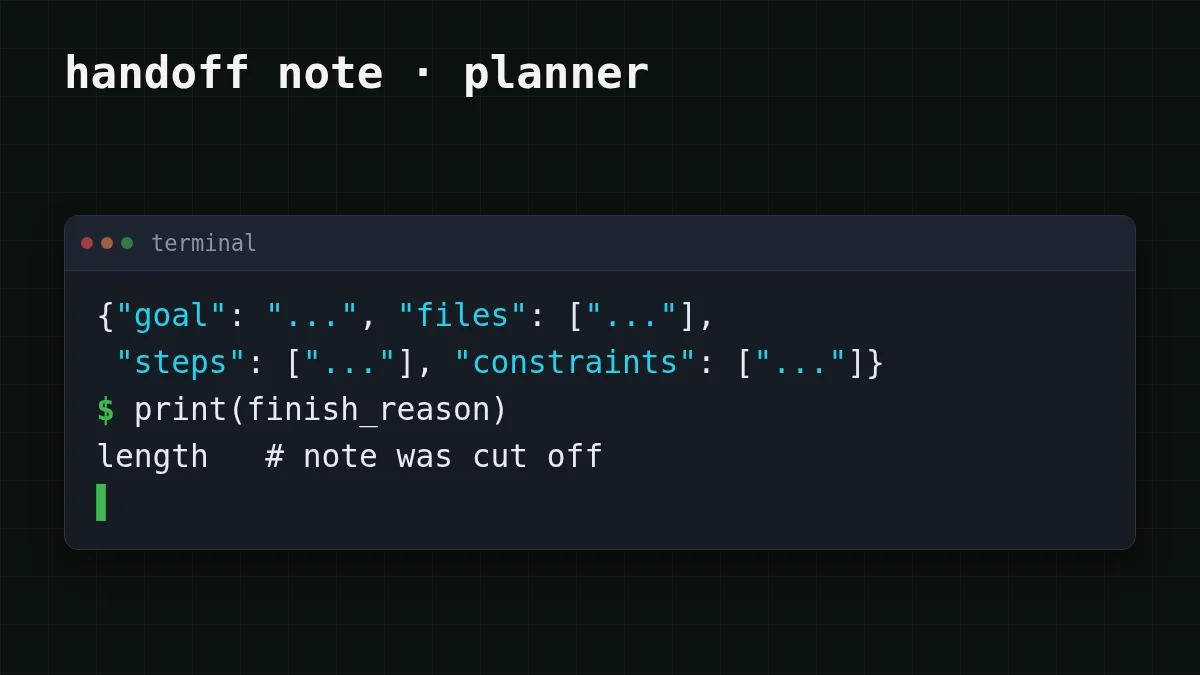
プランナーはコーダーのために長文を書く必要はありません。フィールドを要求してください:目標、ファイル、手順、制約。8つの1行ステップからなる短いノートは1,500ではなく約400トークンかかるとします(仮定です:usageから自分の数字を入れてください)。そして後続の各エージェントはその小さなノートを読みます。回答をmax_tokensで上限設定し、予想されるノートより少し上に設定して、おしゃべりなモデルが長文をこっそり戻せないようにします。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)finish_reasonがlengthの場合、ノートは上限で切り捨てられています:max_tokensを少し上げるか、スキーマを短くしてください(そのエラーの見え方)。モデルIDとベースURLはCheapTokensドキュメントにあります。
2. 各エージェントに必要なものだけを渡す#
レビュアーがコードをタスクに対してチェックするなら、計画は必要ありません:タスクとコードで十分です。コードを計画に対してもチェックするなら、計画を残してください。そのコンテキストから計画を削るのは、オーケストレーターでの1行の変更です:
比較する
レビュアーが読むもの
変更前:すべて
タスク1,000 + 計画1,500 + コード3,000 = 入力5,500トークン。
変更後:タスクとコード
タスク1,000 + コード3,000 = 入力4,000トークン。
両方の変更(および400トークンのノート、これは当社の仮定です)により、例のチェーンはプランナー入力1,000・出力400、コーダー入力1,000 + 400 = 1,400・出力3,000、レビュアー入力1,000 + 3,000 = 4,000・出力800になります。つまり入力1,000 + 1,400 + 4,000 = 6,400トークン、出力400 + 3,000 + 800 = 4,200トークンで、以前は9,000と5,300でした。同じ1日100タスクで:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 100 リクエスト | OpenRouter、100 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
リクエストあたり 6,400 入力トークンと 4,200 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
MiniMax-M2.7での1タスクあたり、削減後のチェーンは$0.00095で、$0.0012から下がります。
3. 短い役割には安いモデルを与える#
プランナーは短い回答を書くので、そこから始めてください:GLM-5.3-Flash(390Kコンテキスト、回答あたり最大8,192出力トークン)を試し、自分のタスク10〜20件で結果を比較してください。コーダーは最も長い回答を書きます:DeepSeek-V4-Flashは回答あたり最大32,768出力トークンを許可します。すべてのモデルがいつでも1つの価格で1つの残高に載っているので、1つのチェーンで混ぜるにはエージェントごとに異なるmodel文字列が必要なだけです。両方の現在の価格は価格表とDeepSeekページにあります。
KVキャッシュをそのまま渡すだけではだめなのか?#
論文SwaT(arXiv:2610.15095)は、2026年10月10日にAlabdulkareem、Tenison、Zhang、Zhu、Katz、Gutfreundによって提出され、まさにそれを提案しています:エージェントはテキストの代わりにKVキャッシュ状態を互いに渡し、受け取る側はテキストを再び読むのをスキップします。アブストラクトページ(2026年10月31日に閲覧)によると、著者らは17のベンチマーク、12のLLM、6つのモデルファミリーにわたって、テキスト間通信より平均精度が40%高く(KVキャッシュの圧縮あり)、平均実時間が4倍速いと報告しています。40%は精度であり、トークンや価格の節約ではありません。
このような研究手法にはモデルの内部キャッシュへのアクセスが必要です。chat-completionsリクエストはテキストを受け取りテキストを返すので、APIではあなたのレバーはテキストです:上記の3つの変更です。
数百回の実行にスケールする前に#
チェックリスト
ハンドオフチェックリスト
エージェント予算の全体像については、AIエージェントのコストを見積もる方法とエージェントがなぜそんなに多くのトークンを使うのかをご覧ください。


