لاگت کی بہتریگائیڈ
ملٹی-ایجنٹ ہینڈ آف لاگت: 3-ایجنٹ چین ٹوکنز میں کتنا استعمال کرتی ہے
دیکھیں کہ چین میں ہر ایجنٹ تمام پچھلے ہینڈ آف کیوں دوبارہ پڑھتا ہے، اس کی ٹوکنز میں کیا لاگت ہے، اور تین تبدیلیاں جو ان پٹ کو چھوٹا کرتی ہیں۔
اس صفحہ پر
آپ کے تین ایجنٹس نے کام مکمل کر لیا، اور بل کام کی ظاہری شکل سے بڑا ہے۔ وجہ سادہ ہے: ٹیکسٹ ہینڈ آف کے ساتھ، ہر ایجنٹ اپنے سے پہلے کے ایجنٹس کی لکھی ہر چیز کو پڑھنے کی قیمت ادا کرتا ہے۔ 1,500-ٹوکن کا پلان ایک بار پلانر کے لکھنے پر ادا ہوتا ہے، پھر کوڈر، پھر ریویور۔ ہینڈ آف کو مختصر کریں، ہر ایجنٹ کو صرف وہی دیں جس کی اسے ضرورت ہے، اور ہر بعد والے ایجنٹ کا ان پٹ چھوٹا ہو جاتا ہے۔
نیچے: 3-ایجنٹ کی ایک مکمل مثال اس کے ٹوکن ریاضی کے ساتھ، لائیو قیمتوں پر روزانہ 100 ٹاسکس کا لاگت کا تخمینہ، اور تین تبدیلیاں جو آپ آج کر سکتے ہیں۔ چیٹ-کمپلیشنز APIs اسٹیٹ لیس ہیں، لہذا ہر درخواست اپنا مکمل سیاق و سباق دوبارہ لے کر جاتی ہے (لمبی چیٹ زیادہ مہنگی کیوں ہے اور messages array کیسے کام کرتا ہے بنیادی باتیں بتاتے ہیں)۔
ٹوکنز کہاں جمع ہوتے ہیں#
فرض کریں آپ ایک پلانر، ایک کوڈر اور ایک ریویور چلاتے ہیں۔ ٹاسک اور ہدایات 1,000 ٹوکن ہیں۔ پلانر 1,500-ٹوکن کا پلان لکھتا ہے، کوڈر 3,000 ٹوکن کوڈ اور نوٹس لکھتا ہے، ریویور 800-ٹوکن کا فیصلہ لکھتا ہے۔ یہ مثال کے لیے گول اعداد ہیں، پیمائش نہیں؛ اپنے usage فیلڈ سے تبدیل کریں (اسے کیسے پڑھیں)۔
نمبر کا اندازہ لگائیں
ریویور ان پٹ کے طور پر کتنے ٹوکن پڑھتا ہے؟
آپ کا اندازہ
08,000
جواب دکھائیں
جواب: 5,500
5,500: ٹاسک (1,000)، پلان (1,500) اور کوڈ (3,000) سب اس کی درخواست میں آتے ہیں۔
ہر ایجنٹ کا ان پٹ ٹاسک کے علاوہ ہر وہ ہینڈ آف ہے جو اسے ملتا ہے:
ٹیبل کو دائیں طرف اسکرول کریں →
| ایجنٹ | پڑھتا ہے (ان پٹ) | لکھتا ہے (آؤٹ پٹ) |
|---|---|---|
| پلانر | 1,000 (ٹاسک) | 1,500 |
| کوڈر | 1,000 + 1,500 = 2,500 | 3,000 |
| ریویور | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| پوری چین | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
چین 5,300 پیدا کرنے کے لیے 9,000 ٹوکن پڑھتی ہے۔ چوتھا ایجنٹ شامل کریں تو وہ ٹاسک کے علاوہ تینوں ہینڈ آف پڑھے گا، لہذا ان پٹ ہر قدم کے ساتھ بڑھتا ہے، صرف ایک ہینڈ آف سے نہیں۔
روزانہ 100 ٹاسکس کی لاگت#
ہینڈ آف ٹوکن ایک بار آؤٹ پٹ کے طور پر بل کیا جاتا ہے، جب ایجنٹ اسے لکھتا ہے، اور پھر ان پٹ کے طور پر ہر بعد والے ایجنٹ کے لیے جو اسے پڑھتا ہے۔ آؤٹ پٹ ٹوکنز کی قیمت ان پٹ ٹوکنز سے زیادہ ہوتی ہے، لہذا اس مثال میں جوابات بل کا بڑا حصہ ہیں حالانکہ چین لکھنے سے زیادہ پڑھتی ہے (ان پٹ بمقابلہ آؤٹ پٹ ٹوکنز)۔
ایک ٹاسک 9,000 ٹوکن ان اور 5,300 آؤٹ ہے۔ MiniMax-M2.7 پر یہ فی ٹاسک $0.0012 ہے۔ روزانہ 100 ٹاسکس کے لیے، یہ ہمارے ماڈلز میں لائیو قیمتیں ہیں، OpenRouter کے مقابلے میں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 100 درخواستیں | OpenRouter، 100 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
فی درخواست 9,000 ان پٹ اور 5,300 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
مجموعی طور پر، ان پٹ اور آؤٹ پٹ کو ملا کر، اوپر دیے گئے CheapTokens ماڈلز اس چین کے لیے OpenRouter سے سستے نکلتے ہیں۔
اپنی چین کے لیے حساب چاہیے؟ کیلکولیٹر میں ایک ایجنٹ کی اوسط درخواست ڈالیں: تقریباً 3,000 ٹوکن ان اور 1,800 آؤٹ، 300 بار دہرائیں، تو یہ تین ایجنٹس کے 100 ٹاسکس ہیں۔
لاگت کیلکولیٹر
روزانہ 100 ٹاسکس، ہر ایک میں تین ایجنٹس
فی درخواست ان پٹ ٹوکنز: 3,000 · فی درخواست آؤٹ پٹ ٹوکنز: 1,800 · فی دن درخواستیں: 300
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
بل کم کرنے کے تین طریقے#
1. ہینڈ آف کو مختصر ساختی نوٹ بنائیں#
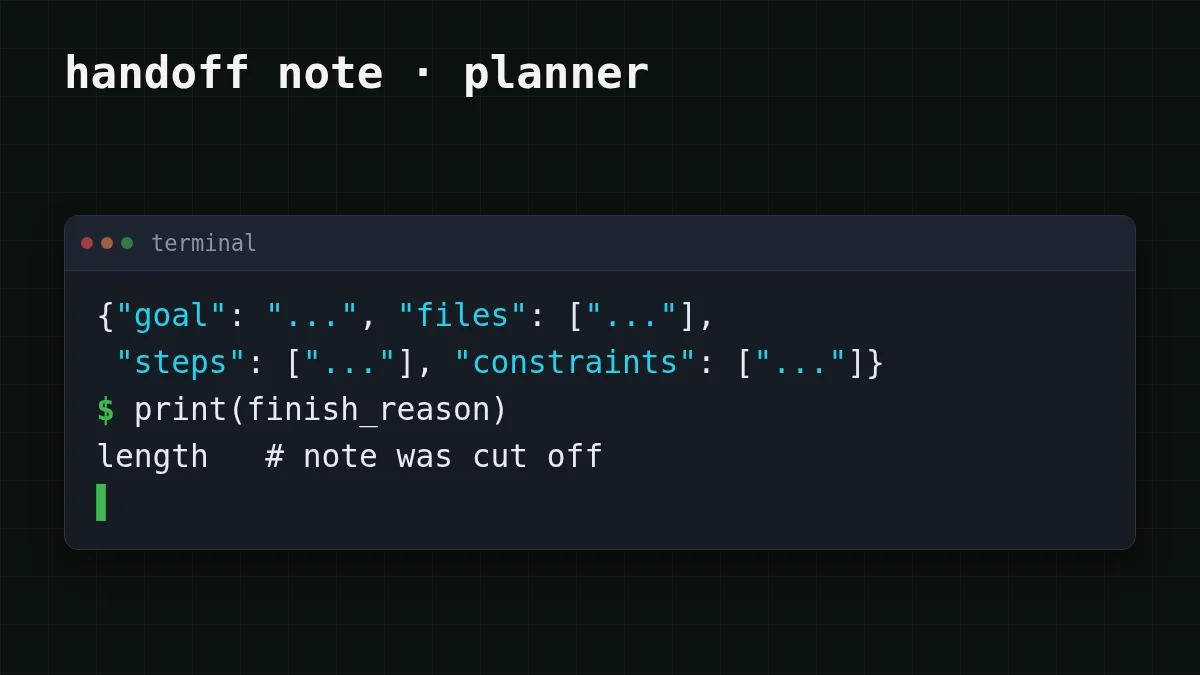
پلانر کو کوڈر کے لیے مضمون لکھنے کی ضرورت نہیں۔ فیلڈز طلب کریں: مقصد، فائلیں، مراحل، پابندیاں۔ فرض کریں آٹھ ایک-سطر مراحل کا مختصر نوٹ 1,500 کے بجائے تقریباً 400 ٹوکن لیتا ہے (ایک مفروضہ: اپنا نمبر usage سے ڈالیں)، اور ہر بعد والا ایجنٹ وہ چھوٹا نوٹ پڑھتا ہے۔ جواب کو max_tokens سے محدود کریں، متوقع نوٹ سے تھوڑا اوپر، تاکہ باتونی ماڈل مضمون واپس نہ لا سکے۔
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
اگر finish_reason length ہے، تو نوٹ کیپ سے کٹ گیا: max_tokens تھوڑا بڑھائیں یا اسکیما مختصر کریں (وہ خرابی کیسی دکھتی ہے)۔ ماڈل آئی ڈی اور بیس URL CheapTokens ڈاکس میں ہیں۔
2. ہر ایجنٹ کو صرف وہی دیں جس کی اسے ضرورت ہے#
اگر ریویور کوڈ کو ٹاسک کے خلاف جانچتا ہے، تو اسے پلان کی ضرورت نہیں: ٹاسک اور کوڈ کافی ہیں۔ اگر یہ کوڈ کو پلان کے خلاف بھی جانچتا ہے، تو پلان رکھیں۔ اس کے سیاق و سباق سے پلان نکالنا آپ کے آرکسٹریٹر میں ایک سطر کی تبدیلی ہے:
موازنہ کریں
ریویور کیا پڑھتا ہے
پہلے: سب کچھ
ٹاسک 1,000 + پلان 1,500 + کوڈ 3,000 = 5,500 ٹوکن ان۔
بعد میں: ٹاسک اور کوڈ
ٹاسک 1,000 + کوڈ 3,000 = 4,000 ٹوکن ان۔
دونوں تبدیلیوں کے ساتھ (اور 400-ٹوکن نوٹ، جو ہمارا مفروضہ ہے)، مثال کی چین بنتی ہے پلانر 1,000 ان اور 400 آؤٹ، کوڈر 1,000 + 400 = 1,400 ان اور 3,000 آؤٹ، ریویور 1,000 + 3,000 = 4,000 ان اور 800 آؤٹ۔ یہ 1,000 + 1,400 + 4,000 = 6,400 ٹوکن ان اور 400 + 3,000 + 800 = 4,200 آؤٹ، بمقابلہ پہلے 9,000 اور 5,300۔ وہی روزانہ 100 ٹاسکس:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 100 درخواستیں | OpenRouter، 100 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
فی درخواست 6,400 ان پٹ اور 4,200 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
MiniMax-M2.7 پر ایک ٹاسک کے لیے تراشی ہوئی چین $0.00095 ہے، جو $0.0012 سے کم ہے۔
3. مختصر کرداروں کو سستا ماڈل دیں#
پلانر مختصر جوابات لکھتا ہے، تو وہیں سے شروع کریں: GLM-5.3-Flash (390K سیاق و سباق، فی جواب زیادہ سے زیادہ 8,192 آؤٹ پٹ ٹوکن) آزمائیں اور اپنے 10–20 ٹاسکس پر نتیجہ موازنہ کریں۔ کوڈر سب سے لمبے جوابات لکھتا ہے: DeepSeek-V4-Flash فی جواب زیادہ سے زیادہ 32,768 آؤٹ پٹ ٹوکن کی اجازت دیتا ہے۔ چونکہ ہر ماڈل ایک ہی بیلنس پر کسی بھی وقت ایک ہی قیمت پر ہوتا ہے، ایک چین میں انہیں ملانے کے لیے صرف فی ایجنٹ مختلف model سٹرنگ درکار ہے۔ دونوں کی موجودہ قیمتیں قیمتوں کی جدول اور DeepSeek صفحہ پر ہیں۔
صرف KV کیش کیوں نہ پاس کریں؟#
پیپر SwaT (arXiv:2610.15095)، جو 10 اکتوبر 2026 کو Alabdulkareem، Tenison، Zhang، Zhu، Katz اور Gutfreund نے جمع کرایا، بالکل یہی تجویز کرتا ہے: ایجنٹس ایک دوسرے کو ٹیکسٹ کے بجائے KV-کیش اسٹیٹ دیتے ہیں، تاکہ وصول کنندہ ٹیکسٹ دوبارہ پڑھنے سے بچ جائے۔ خلاصے کے صفحے کے مطابق (31 اکتوبر 2026 کو پڑھا گیا)، مصنفین 17 بینچ مارکس، 12 LLMs اور 6 ماڈل فیملیز میں ٹیکسٹ ٹو ٹیکسٹ مواصلات سے 40% زیادہ اوسط درستگی (KV-کیش کمپیکشن کے ساتھ) اور 4 گنا تیز اوسط وال-کلاک وقت رپورٹ کرتے ہیں۔ 40% درستگی ہے، ٹوکنز یا قیمت پر بچت نہیں۔
اس طرح کے تحقیقی طریقے کے لیے ماڈل کے اندرونی کیش تک رسائی درکار ہے۔ چیٹ-کمپلیشنز درخواست ٹیکسٹ لیتی ہے اور ٹیکسٹ دیتی ہے، لہذا API کے ساتھ آپ کا لیور ٹیکسٹ ہے: اوپر دی گئی تین تبدیلیاں۔
سینکڑوں رنز تک بڑھانے سے پہلے#
چیک لسٹ
ہینڈ آف چیک لسٹ
ایجنٹ بجٹ کی بڑی تصویر کے لیے، دیکھیں AI ایجنٹ کی لاگت کا تخمینہ کیسے لگائیں اور ایجنٹس اتنے زیادہ ٹوکن کیوں استعمال کرتے ہیں۔


