Gastos sa multi-agent handoff: ano ang ginagamit ng 3-agent chain sa tokens
Tingnan kung bakit binabasa muli ng bawat agent sa chain ang lahat ng naunang handoff, magkano iyon sa tokens, at tatlong pagbabagong nagpapaliit ng input.
Sa pahinang ito
- Saan nag-iipon ang tokens
- Magkano ang 100 tasks kada araw
- Tatlong paraan para bawasan ang bill
- 1. Gawing maikling structured note ang handoff
- 2. Ibigay sa bawat agent ang kailangan lang nito
- 3. Bigyan ng murang modelo ang maiikling roles
- Bakit hindi na lang ipasa ang KV cache?
- Bago ka mag-scale sa daan-daang runs
Tatlong agent mo ang tumapos sa trabaho, at mas malaki ang bill kaysa sa hitsura ng trabaho. Simple lang ang dahilan: sa text handoffs, bawat agent ay nagbabayad para basahin ang lahat ng isinulat ng mga naunang agent. Ang 1,500-token na plano ay binabayaran isang beses kapag isinulat ito ng planner, pagkatapos ay muli ng coder, at muli ng reviewer. Bawasan ang handoff, ibigay sa bawat agent ang kailangan lang nito, at ang input ng bawat kasunod na agent ay liliit.
Sa ibaba: isang worked 3-agent na halimbawa kasama ang token math nito, isang cost estimate para sa 100 tasks kada araw sa live na presyo, at tatlong pagbabagong magagawa mo ngayon. Ang chat-completions APIs ay stateless, kaya bawat request ay may dalang buong context muli (bakit mas mahal ang mahabang chat at paano gumagana ang messages array ang sumasaklaw sa basics).
Saan nag-iipon ang tokens#
Sabihin nating may planner, coder at reviewer ka. Ang task kasama ang instructions ay 1,000 tokens. Ang planner ay nagsusulat ng 1,500-token na plano, ang coder ay nagsusulat ng 3,000 tokens ng code at notes, ang reviewer ay nagsusulat ng 800-token na verdict. Mga round numbers ito para sa halimbawa, hindi isang measurement; palitan ng sarili mo mula sa usage field (paano ito basahin).
Hulaan ang numero
Ilang tokens ang binabasa ng reviewer bilang input?
Ang iyong hula
08,000
Ipakita ang sagot
Sagot: 5,500
5,500: ang task (1,000), ang plano (1,500) at ang code (3,000) ay dumarating lahat sa request nito.
Ang input ng bawat agent ay ang task kasama ang bawat handoff na natatanggap nito:
I-scroll ang table pakanan →
| Agent | Binabasa (input) | Isinusulat (output) |
|---|---|---|
| Planner | 1,000 (task) | 1,500 |
| Coder | 1,000 + 1,500 = 2,500 | 3,000 |
| Reviewer | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| Buong chain | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
Ang chain ay nagbabasa ng 9,000 tokens para makabuo ng 5,300. Magdagdag ng ika-apat na agent at babasahin nito ang task kasama ang lahat ng tatlong handoff, kaya ang input ay lumalaki sa bawat hop, hindi lang sa isang handoff.
Magkano ang 100 tasks kada araw#
Ang handoff token ay sinisingil isang beses bilang output, kapag isinulat ito ng agent, at pagkatapos ay bilang input para sa bawat kasunod na agent na bumabasa nito. Mas mataas ang presyo ng output tokens kaysa input tokens, kaya sa halimbawang ito ang mga sagot ang mas malaking bahagi ng bill kahit na mas marami ang binabasa kaysa isinusulat ng chain (input vs output tokens).
Ang isang task ay 9,000 tokens in at 5,300 out. Sa MiniMax-M2.7 iyon ay $0.0012 kada task. Para sa 100 tasks kada araw, ito ang mga live na presyo sa aming mga modelo, katabi ng OpenRouter:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 100 mga kahilingan | OpenRouter, 100 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9,000 input at 5,300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa kabuuan, kasama ang input at output, ang mga CheapTokens model sa itaas ay mas mura kaysa OpenRouter para sa chain na ito.
Gusto mo ba ng kalkulasyon para sa sarili mong chain? Ilagay ang average request ng isang agent sa calculator: mga 3,000 tokens in at 1,800 out, paulit-ulit ng 300 beses, ay 100 tasks ng tatlong agent.
Calculator ng gastos
100 tasks kada araw, tatlong agent bawat isa
Mga input token bawat kahilingan: 3,000 · Mga output token bawat kahilingan: 1,800 · Mga kahilingan bawat araw: 300
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Tatlong paraan para bawasan ang bill#
1. Gawing maikling structured note ang handoff#
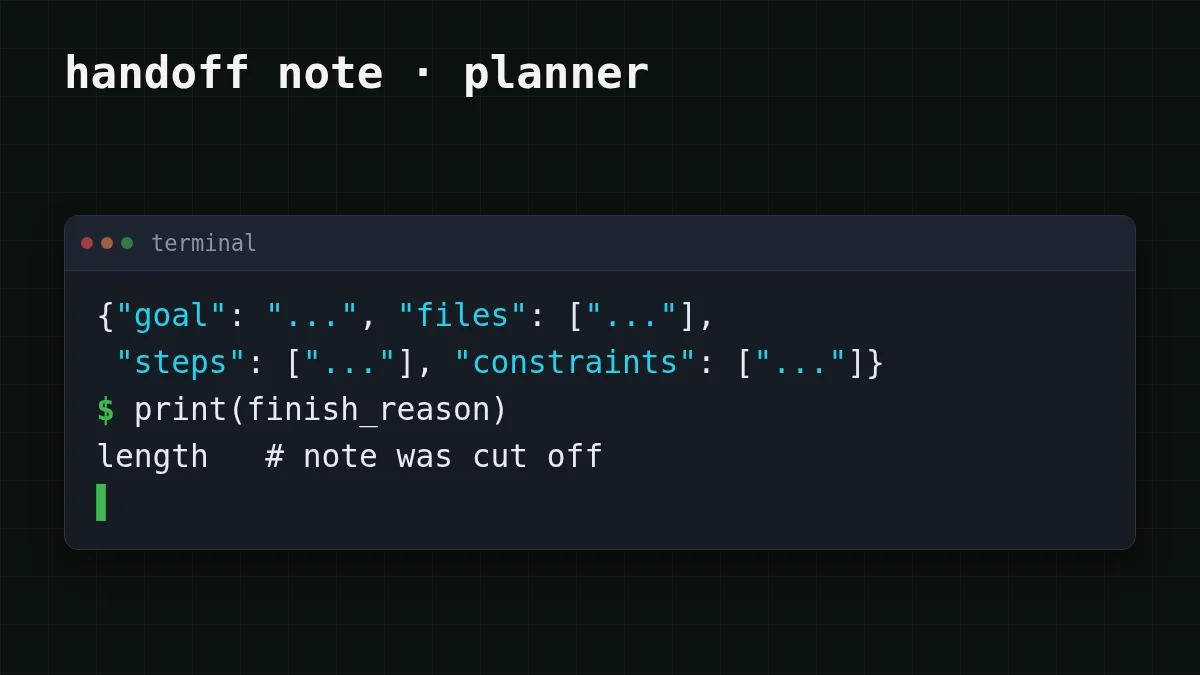
Hindi kailangan ng planner na magsulat ng essay para sa coder. Humingi ng fields: goal, files, steps, constraints. Sabihin nating ang maikling note na walong one-line steps ay tumatagal ng mga 400 tokens kaysa 1,500 (isang assumption: ilagay ang sarili mong numero mula sa usage), at bawat kasunod na agent ay binabasa ang mas maliit na note. Takpan ang sagot gamit ang max_tokens, itakda nang bahagyang mas mataas sa inaasahang note, para hindi maipuslit ng chatty model ang essay pabalik.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Kung ang finish_reason ay length, ang note ay naputol ng cap: taasan nang kaunti ang max_tokens o paikliin ang schema (ano ang hitsura ng error na iyon). Ang model id at base URL ay nasa CheapTokens docs.
2. Ibigay sa bawat agent ang kailangan lang nito#
Kung sinusuri ng reviewer ang code laban sa task, hindi nito kailangan ang plano: sapat na ang task at ang code. Kung sinusuri rin nito ang code laban sa plano, itago ang plano. Ang pagtanggal ng plano sa context nito ay isang one-line change sa iyong orchestrator:
Ihambing
Ano ang binabasa ng reviewer
Bago: lahat
Task 1,000 + plano 1,500 + code 3,000 = 5,500 tokens in.
Pagkatapos: task at code
Task 1,000 + code 3,000 = 4,000 tokens in.
Sa parehong pagbabago (at ang 400-token note, na aming assumption), ang halimbawang chain ay magiging planner 1,000 in at 400 out, coder 1,000 + 400 = 1,400 in at 3,000 out, reviewer 1,000 + 3,000 = 4,000 in at 800 out. Iyon ay 1,000 + 1,400 + 4,000 = 6,400 tokens in at 400 + 3,000 + 800 = 4,200 out, kumpara sa 9,000 at 5,300 dati. Parehong 100 tasks kada araw:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 100 mga kahilingan | OpenRouter, 100 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6,400 input at 4,200 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Para sa isang task sa MiniMax-M2.7 ang trimmed chain ay $0.00095, mula sa $0.0012.
3. Bigyan ng murang modelo ang maiikling roles#
Ang planner ay nagsusulat ng maiikling sagot, kaya doon magsimula: subukan ang GLM-5.3-Flash (390K context, hanggang 8,192 output tokens kada sagot) at ihambing ang resulta sa 10–20 ng sarili mong tasks. Ang coder ang nagsusulat ng pinakamahabang sagot: ang DeepSeek-V4-Flash ay nagpapahintulot ng hanggang 32,768 output tokens kada sagot. Dahil ang bawat modelo ay nasa isang balance na may isang presyo sa anumang oras, ang paghahalo ng mga ito sa isang chain ay nangangailangan lamang ng ibang model string kada agent. Ang kasalukuyang presyo para sa pareho ay nasa pricing table at sa DeepSeek page.
Bakit hindi na lang ipasa ang KV cache?#
Ang papel na SwaT (arXiv:2610.15095), na isinumite noong 10 Oktubre 2026 nina Alabdulkareem, Tenison, Zhang, Zhu, Katz at Gutfreund, ay nagmumungkahi ng eksaktong iyon: ang mga agent ay nagpapasa sa isa't isa ng KV-cache state kaysa text, para laktawan ng receiver ang pagbasa muli ng text. Ayon sa abstract page (binasa noong 31 Oktubre 2026), iniulat ng mga may-akda ang 40% na mas mataas na mean accuracy (may KV-cache compaction) kaysa text-to-text communication at 4x na mas mabilis na mean wall-clock time sa 17 benchmarks, 12 LLMs at 6 model families. Ang 40% ay accuracy, hindi tipid sa tokens o presyo.
Ang research method na tulad nito ay nangangailangan ng access sa internal cache ng modelo. Ang chat-completions request ay tumatanggap ng text at nagbibigay ng text, kaya sa API ang lever mo ay ang text: ang tatlong pagbabago sa itaas.
Bago ka mag-scale sa daan-daang runs#
Listahan ng dapat gawin
Handoff checklist
Para sa mas malaking larawan ng agent budgets, tingnan ang paano tantiyahin ang gastos ng isang AI agent at bakit gumagamit ng napakaraming tokens ang mga agent.


