Оптимизация расходовИнструкция
Сколько токенов стоит передача между агентами в цепочке из трёх
Почему каждый агент в цепочке заново читает все прошлые передачи, во сколько токенов это обходится и как сократить вход тремя способами.
Содержание
Три агента закончили работу, а счёт больше, чем кажется по задаче. Причина простая: при текстовой передаче каждый агент платит за чтение всего, что написали агенты до него. План на 1 500 токенов оплачивается один раз, когда его пишет планировщик, потом ещё раз кодером и ещё раз ревьюером. Сократите передачу, дайте каждому агенту только нужное — и вход каждого следующего агента станет меньше.
Дальше: разобранный пример с тремя агентами и подсчётом токенов, оценка стоимости 100 задач в день на живых ценах и три изменения, которые можно сделать сегодня. API чат-моделей не хранит состояние, поэтому каждый запрос заново несёт весь контекст (основы: почему длинный чат дороже и как устроен массив messages).
Где копятся токены#
Допустим, у вас планировщик, кодер и ревьюер. Задача с инструкциями занимает 1 000 токенов. Планировщик пишет план на 1 500 токенов, кодер — 3 000 токенов кода и заметок, ревьюер — вердикт на 800. Числа круглые, для примера, это не измерение; подставьте свои из поля usage (как его читать).
Угадайте число
Сколько токенов входа читает ревьюер?
Ваш вариант
08 000
Показать ответ
Ответ: 5 500
5 500: в его запрос попадают задача (1 000), план (1 500) и код (3 000).
Вход каждого агента — задача плюс все передачи, которые он получает:
Прокрутите таблицу вправо →
| Агент | Читает (вход) | Пишет (выход) |
|---|---|---|
| Планировщик | 1 000 (задача) | 1 500 |
| Кодер | 1 000 + 1 500 = 2 500 | 3 000 |
| Ревьюер | 1 000 + 1 500 + 3 000 = 5 500 | 800 |
| Вся цепочка | 1 000 + 2 500 + 5 500 = 9 000 | 1 500 + 3 000 + 800 = 5 300 |
Цепочка читает 9 000 токенов, чтобы написать 5 300. Добавьте четвёртого агента — он прочтёт задачу и все три передачи, так что вход растёт с каждым шагом, а не на одну передачу.
Сколько стоят 100 задач в день#
Токен передачи оплачивается один раз как выход, когда агент его пишет, и затем как вход у каждого агента, который его читает. Токены выхода стоят дороже токенов входа, поэтому в этом примере ответы составляют большую часть счёта, хотя цепочка читает больше, чем пишет (вход и выход).
Одна задача — 9 000 токенов входа и 5 300 выхода. На MiniMax-M2.7 это $0.0012 за задачу. Для 100 задач в день — живые цены наших моделей рядом с OpenRouter:
| Модель | Вход $/1M | Выход $/1M | За запрос | 100 запросов | OpenRouter, 100 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9 000 входных и 5 300 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В сумме, с учётом входа и выхода, модели CheapTokens в таблице выходят дешевле OpenRouter на этой цепочке.
Хотите расчёт для своей цепочки? Подставьте в калькулятор средний запрос одного агента: около 3 000 токенов входа и 1 800 выхода, 300 раз — это 100 задач по три агента.
Калькулятор стоимости
100 задач в день, по три агента
Входные токены на запрос: 3 000 · Выходные токены на запрос: 1 800 · Запросов в день: 300
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Три способа сократить счёт#
1. Сделайте передачу короткой структурированной заметкой#
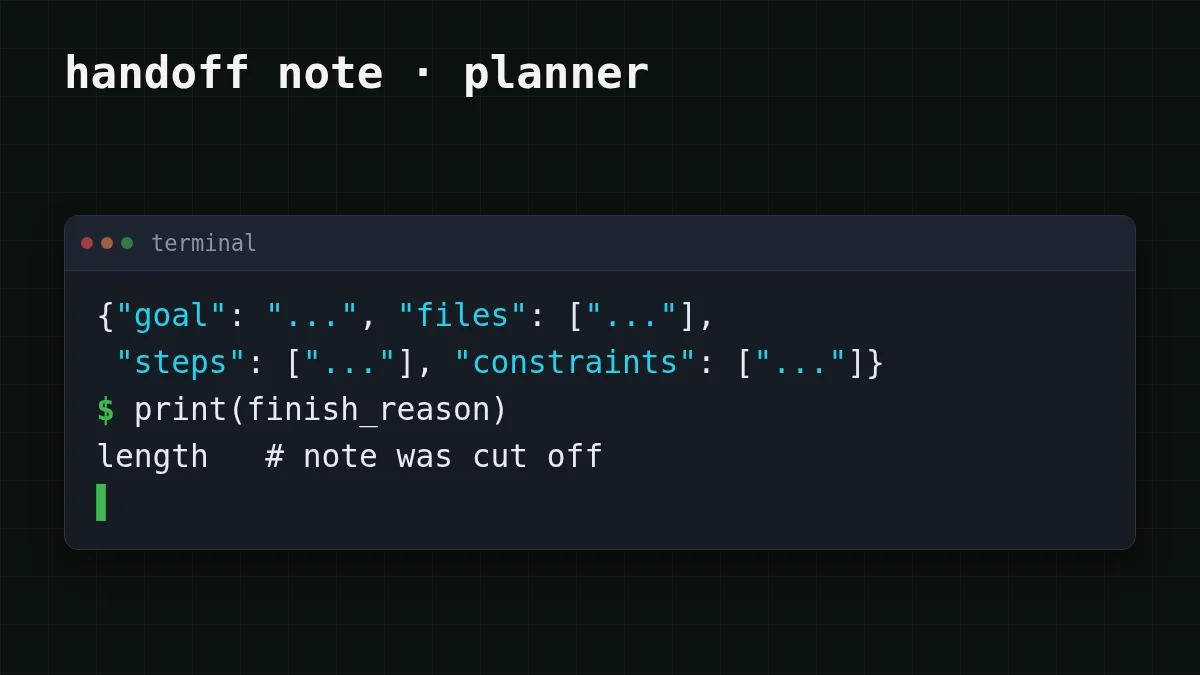
Планировщику не нужно писать кодеру эссе. Попросите поля: цель, файлы, шаги, ограничения. Допустим, короткая заметка из восьми строк по одному шагу занимает около 400 токенов вместо 1 500 (допущение: подставьте своё значение из usage), и каждый следующий агент читает уже эту заметку. Ограничьте ответ через max_tokens, поставив лимит чуть выше ожидаемой заметки, чтобы разговорчивая модель не вернула эссе.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Если finish_reason равен length, заметку обрезал лимит: чуть увеличьте max_tokens или сократите схему (как выглядит эта ошибка). Id модели и адрес API — в документации CheapTokens.
2. Давайте каждому агенту только то, что ему нужно#
Если ревьюер проверяет код по задаче, план ему не нужен — достаточно задачи и кода. Если проверяет и соответствие плану, оставьте план. Убрать план из его контекста — правка в одну строку в вашем оркестраторе:
Сравнение
Что читает ревьюер
До: всё подряд
Задача 1 000 + план 1 500 + код 3 000 = 5 500 токенов входа.
После: задача и код
Задача 1 000 + код 3 000 = 4 000 токенов входа.
С обоими изменениями (и заметкой в 400 токенов — это допущение) цепочка из примера выглядит так: планировщик 1 000 на входе и 400 на выходе, кодер 1 000 + 400 = 1 400 на входе и 3 000 на выходе, ревьюер 1 000 + 3 000 = 4 000 на входе и 800 на выходе. Итого 1 000 + 1 400 + 4 000 = 6 400 токенов входа и 400 + 3 000 + 800 = 4 200 выхода против 9 000 и 5 300. Те же 100 задач в день:
| Модель | Вход $/1M | Выход $/1M | За запрос | 100 запросов | OpenRouter, 100 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6 400 входных и 4 200 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Одна задача на MiniMax-M2.7 с короткой цепочкой — $0.00095, было $0.0012.
3. Отдайте короткие роли дешёвой модели#
Планировщик пишет короткие ответы, так что начните с него: попробуйте GLM-5.3-Flash (контекст 390K, до 8 192 токенов в ответе) и сравните результат на 10–20 своих задачах. Кодер пишет самые длинные ответы: DeepSeek-V4-Flash отдаёт до 32 768 токенов за ответ. Все модели сидят на одном балансе с единой ценой в любой час, так что для смешанной цепочки достаточно другой строки model у каждого агента. Актуальные цены обеих — в таблице цен и на странице DeepSeek.
Почему не передавать KV-кэш#
Статья SwaT (arXiv:2610.15095), отправленная 10 октября 2026 года авторами Alabdulkareem, Tenison, Zhang, Zhu, Katz и Gutfreund, предлагает именно это: агенты передают друг другу состояние KV-кэша вместо текста, и получателю не нужно заново читать текст. По странице аннотации (прочитана 31 октября 2026 года), авторы сообщают о 40% более высокой средней точности (с компактизацией KV-кэша), чем при текстовой передаче, и о 4-кратном ускорении по времени на 17 бенчмарках, 12 LLM и 6 семействах моделей. 40% — это точность, а не экономия токенов или денег.
Такому исследовательскому методу нужен доступ к внутреннему кэшу модели. Запрос chat-completions принимает текст и возвращает текст, так что через API ваш рычаг — сам текст: три изменения выше.
Прежде чем масштабировать до сотен запусков#
Чек-лист
Чек-лист передачи
О бюджете агентов в целом — как оценить стоимость ИИ-агента и почему агенты тратят так много токенов.


