비용 최적화가이드
멀티 에이전트 핸드오프 비용: 3-에이전트 체인이 사용하는 토큰
체인의 모든 에이전트가 이전 핸드오프를 모두 다시 읽는 이유, 그로 인한 토큰 비용, 그리고 입력을 줄이는 세 가지 변경 사항을 알아보세요.
이 페이지의 내용
세 개의 에이전트가 작업을 끝냈는데, 청구서는 작업 규모보다 큽니다. 이유는 간단합니다. 텍스트 핸드오프에서는 모든 에이전트가 앞선 에이전트들이 작성한 모든 내용을 읽는 비용을 지불하기 때문입니다. 1,500토큰짜리 계획은 기획자가 작성할 때 한 번, 코더가 읽을 때 또 한 번, 리뷰어가 읽을 때 또 한 번 비용이 발생합니다. 핸드오프를 줄이고 각 에이전트에게 필요한 것만 전달하면 이후 모든 에이전트의 입력이 작아집니다.
아래에는 토큰 계산이 포함된 3-에이전트 예시, 실시간 가격 기준 하루 100개 작업에 대한 비용 추정, 그리고 오늘 바로 적용할 수 있는 세 가지 변경 사항이 있습니다. 채팅 완성 API는 상태를 저장하지 않으므로 모든 요청이 전체 컨텍스트를 다시 전달합니다(긴 채팅이 더 비싼 이유와 messages 배열의 작동 방식에서 기본 내용을 다룹니다).
토큰이 쌓이는 지점#
기획자, 코더, 리뷰어를 운영한다고 가정해 봅시다. 작업과 지시사항은 1,000토큰입니다. 기획자는 1,500토큰짜리 계획을 작성하고, 코더는 3,000토큰의 코드와 노트를 작성하며, 리뷰어는 800토큰의 판정을 작성합니다. 이는 예시를 위한 반올림한 수치이며 측정값이 아닙니다. usage 필드에서 자신의 수치로 바꿔 보세요(읽는 방법).
숫자 맞히기
리뷰어는 입력으로 몇 개의 토큰을 읽을까요?
내 추측
08,000
정답 보기
정답: 5,500
5,500: 작업(1,000), 계획(1,500), 코드(3,000)가 모두 요청에 포함됩니다.
각 에이전트의 입력은 작업에 받은 모든 핸드오프를 더한 값입니다:
표를 오른쪽으로 스크롤하세요 →
| 에이전트 | 읽기 (입력) | 쓰기 (출력) |
|---|---|---|
| 기획자 | 1,000 (작업) | 1,500 |
| 코더 | 1,000 + 1,500 = 2,500 | 3,000 |
| 리뷰어 | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| 전체 체인 | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
체인은 5,300을 생성하기 위해 9,000토큰을 읽습니다. 네 번째 에이전트를 추가하면 작업과 세 개의 핸드오프를 모두 읽게 되므로, 입력은 핸드오프 하나만큼이 아니라 매 단계마다 증가합니다.
하루 100개 작업의 비용#
핸드오프 토큰은 에이전트가 작성할 때 출력으로 한 번 청구되고, 이후 읽는 각 에이전트의 입력으로 청구됩니다. 출력 토큰은 입력 토큰보다 가격이 높으므로, 이 예시에서는 체인이 쓰는 것보다 더 많이 읽음에도 불구하고 답변이 청구서에서 더 큰 비중을 차지합니다(입력 vs 출력 토큰).
작업 하나는 입력 9,000토큰, 출력 5,300토큰입니다. MiniMax-M2.7에서는 작업당 $0.0012입니다. 하루 100개 작업 기준으로, OpenRouter와 비교한 우리 모델들의 실시간 가격은 다음과 같습니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 100회 요청 | OpenRouter, 100회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
요청당 입력 9,000개 및 출력 5,300개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
입력과 출력을 합산한 총액에서, 위의 CheapTokens 모델들은 이 체인에 대해 OpenRouter보다 저렴합니다.
자신의 체인에 대한 계산을 원하시나요? 한 에이전트의 평균 요청을 계산기에 넣으세요. 약 3,000토큰 입력과 1,800토큰 출력을 300번 반복하면 세 에이전트의 100개 작업입니다.
비용 계산기
하루 100개 작업, 각각 세 에이전트
요청당 입력 토큰: 3,000 · 요청당 출력 토큰: 1,800 · 일일 요청 수: 300
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
청구서를 줄이는 세 가지 방법#
1. 핸드오프를 짧은 구조화된 노트로 만들기#
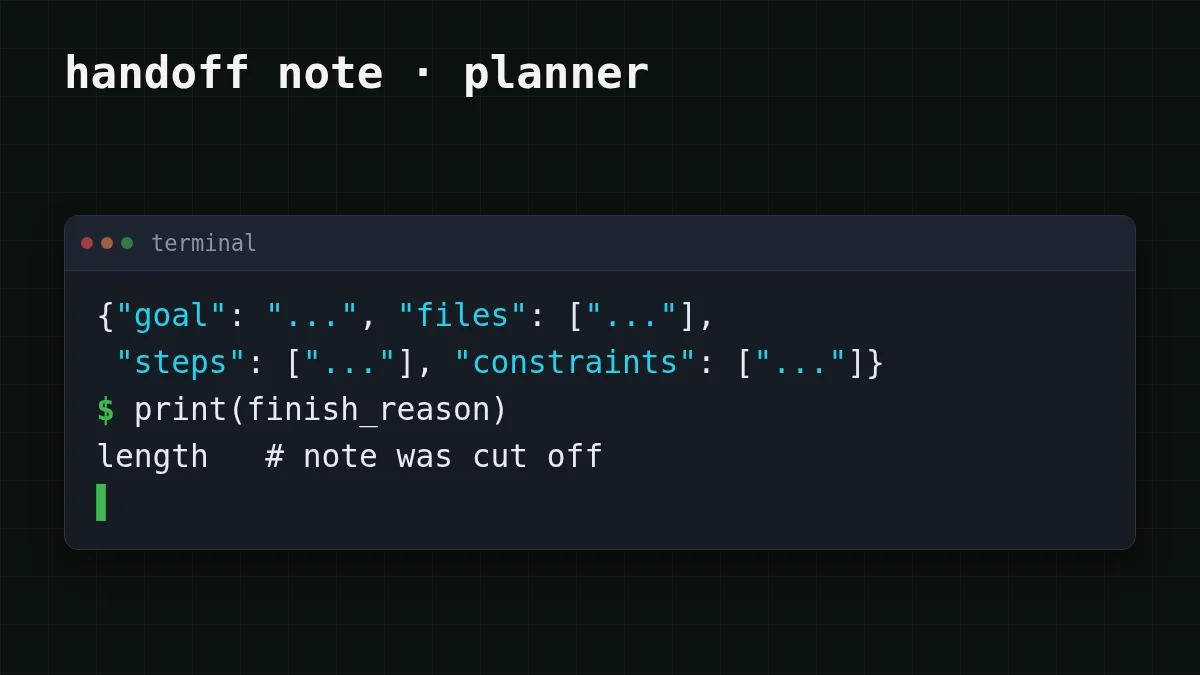
기획자가 코더를 위해 에세이를 작성할 필요는 없습니다. 목표, 파일, 단계, 제약 조건 같은 필드를 요청하세요. 한 줄짜리 여덟 단계로 구성된 짧은 노트는 1,500토큰 대신 약 400토큰이 든다고 가정해 봅시다(가정입니다. usage에서 자신의 수치를 넣으세요). 이후 모든 에이전트는 그 더 작은 노트를 읽습니다. max_tokens로 답변을 제한하고, 예상 노트보다 약간 높게 설정하여 수다스러운 모델이 에세이를 다시 끼워 넣지 못하게 하세요.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)finish_reason가 length이면 노트가 제한에 의해 잘린 것입니다. max_tokens을 조금 높이거나 스키마를 줄이세요(해당 오류의 모습). 모델 ID와 기본 URL은 CheapTokens 문서에 있습니다.
2. 각 에이전트에게 필요한 것만 전달하기#
리뷰어가 작업에 대해 코드를 검사한다면 계획은 필요 없습니다. 작업과 코드만으로 충분합니다. 계획에 대해서도 코드를 검사한다면 계획을 유지하세요. 컨텍스트에서 계획을 제거하는 것은 오케스트레이터에서 한 줄만 바꾸면 됩니다:
비교하기
리뷰어가 읽는 것
이전: 모든 것
작업 1,000 + 계획 1,500 + 코드 3,000 = 입력 5,500토큰.
이후: 작업과 코드
작업 1,000 + 코드 3,000 = 입력 4,000토큰.
두 가지 변경(그리고 우리의 가정인 400토큰 노트)을 적용하면 예시 체인은 기획자 입력 1,000, 출력 400, 코더 입력 1,000 + 400 = 1,400, 출력 3,000, 리뷰어 입력 1,000 + 3,000 = 4,000, 출력 800이 됩니다. 즉 입력 1,000 + 1,400 + 4,000 = 6,400토큰, 출력 400 + 3,000 + 800 = 4,200토큰으로, 이전의 9,000과 5,300에 비해 줄어듭니다. 동일한 하루 100개 작업 기준:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 100회 요청 | OpenRouter, 100회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
요청당 입력 6,400개 및 출력 4,200개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
MiniMax-M2.7에서 작업 하나당 축소된 체인은 $0.00095으로, $0.0012에서 감소합니다.
3. 짧은 역할에는 저렴한 모델 사용하기#
기획자는 짧은 답변을 작성하므로 여기서 시작하세요. GLM-5.3-Flash(390K 컨텍스트, 답변당 최대 8,192 출력 토큰)를 시도하고 자신의 작업 10~20개에서 결과를 비교해 보세요. 코더는 가장 긴 답변을 작성합니다. DeepSeek-V4-Flash는 답변당 최대 32,768 출력 토큰을 허용합니다. 모든 모델이 어느 시간대든 하나의 가격으로 하나의 잔액에 있으므로, 하나의 체인에서 이들을 혼합하려면 에이전트마다 다른 model 문자열만 필요합니다. 두 모델의 현재 가격은 가격표와 DeepSeek 페이지에 있습니다.
KV 캐시를 그냥 전달하면 안 될까?#
2026년 10월 10일 Alabdulkareem, Tenison, Zhang, Zhu, Katz, Gutfreund가 제출한 논문 SwaT (arXiv:2610.15095)는 바로 그것을 제안합니다. 에이전트가 텍스트 대신 KV 캐시 상태를 서로 전달하여 수신자가 텍스트를 다시 읽지 않도록 하는 것입니다. 초록 페이지(2026년 10월 31일 열람)에 따르면, 저자들은 17개 벤치마크, 12개 LLM, 6개 모델 패밀리에서 텍스트 대 텍스트 통신보다 평균 정확도가 40% 더 높고(KV 캐시 압축 적용 시) 평균 실제 소요 시간이 4배 더 빠르다고 보고합니다. 40%는 정확도이며, 토큰이나 가격 절감이 아닙니다.
이와 같은 연구 방법은 모델의 내부 캐시에 접근해야 합니다. 채팅 완성 요청은 텍스트를 받아 텍스트를 내놓으므로, API를 사용할 때 여러분의 수단은 텍스트입니다. 바로 위의 세 가지 변경입니다.
수백 번의 실행으로 확장하기 전에#
체크리스트
핸드오프 체크리스트
에이전트 예산에 대한 더 큰 그림은 AI 에이전트 비용을 추정하는 방법과 에이전트가 왜 그렇게 많은 토큰을 사용하는지를 참고하세요.


