Costo degli handoff multi-agente: quanti token usa una catena a 3 agenti
Scopri perché ogni agente in una catena rilegge tutti gli handoff precedenti, quanto costa in token, e tre modifiche che riducono l'input.
In questa pagina
- Dove si accumulano i token
- Quanto costano 100 task al giorno
- Tre modi per ridurre la bolletta
- 1. Trasforma l'handoff in una breve nota strutturata
- 2. Passa a ogni agente solo ciò che gli serve
- 3. Assegna un modello economico ai ruoli brevi
- Perché non passare direttamente la KV cache?
- Prima di scalare a centinaia di esecuzioni
I tuoi tre agenti hanno finito il lavoro, e la bolletta è più grande di quanto sembri il lavoro. Il motivo è semplice: con gli handoff testuali, ogni agente paga per leggere tutto ciò che gli agenti precedenti hanno scritto. Un piano da 1.500 token viene pagato una volta quando il planner lo scrive, poi di nuovo dal coder, poi di nuovo dal reviewer. Riduci l'handoff, passa a ogni agente solo ciò che gli serve, e l'input di ogni agente successivo diventa più piccolo.
Qui sotto: un esempio pratico a 3 agenti con il suo calcolo dei token, una stima dei costi per 100 task al giorno sui prezzi live, e tre modifiche che puoi fare oggi. Le API chat-completions sono stateless, quindi ogni richiesta porta di nuovo tutto il suo contesto (perché una chat lunga costa di più e come funziona l'array messages coprono le basi).
Dove si accumulano i token#
Supponi di avere un planner, un coder e un reviewer. Il task più le istruzioni sono 1.000 token. Il planner scrive un piano da 1.500 token, il coder scrive 3.000 token di codice e note, il reviewer scrive un verdetto da 800 token. Sono numeri arrotondati per l'esempio, non una misurazione; sostituisci i tuoi dal campo usage (come leggerlo).
Indovina il numero
Quanti token legge il reviewer come input?
La tua risposta
08000
Mostra risposta
Risposta: 5500
5.500: il task (1.000), il piano (1.500) e il codice (3.000) arrivano tutti nella sua richiesta.
L'input di ogni agente è il task più ogni handoff che riceve:
Scorri la tabella verso destra →
| Agente | Legge (input) | Scrive (output) |
|---|---|---|
| Planner | 1.000 (task) | 1.500 |
| Coder | 1.000 + 1.500 = 2.500 | 3.000 |
| Reviewer | 1.000 + 1.500 + 3.000 = 5.500 | 800 |
| Intera catena | 1.000 + 2.500 + 5.500 = 9.000 | 1.500 + 3.000 + 800 = 5.300 |
La catena legge 9.000 token per produrne 5.300. Aggiungi un quarto agente e leggerebbe il task più tutti e tre gli handoff, quindi l'input cresce a ogni salto, non solo di un handoff.
Quanto costano 100 task al giorno#
Un token di handoff viene fatturato una volta come output, quando l'agente lo scrive, e poi come input per ogni agente successivo che lo legge. I token di output costano più di quelli di input, quindi in questo esempio le risposte sono la quota maggiore della bolletta anche se la catena legge più di quanto scrive (token di input vs output).
Un task è 9.000 token in input e 5.300 in output. Su MiniMax-M2.7 sono $0.0012 per task. Per 100 task al giorno, questi sono i prezzi live dei nostri modelli, accanto a OpenRouter:
| Modello | Input $/1M | Output $/1M | Per richiesta | 100 richieste | OpenRouter, 100 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9000 token di input e 5300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In totale, contando insieme input e output, i modelli CheapTokens qui sopra risultano più economici di OpenRouter per questa catena.
Vuoi il calcolo per la tua catena? Inserisci nella calcolatrice la richiesta media di un agente: circa 3.000 token in input e 1.800 in output, ripetuta 300 volte, sono 100 task di tre agenti.
Calcolatore di costi
100 task al giorno, tre agenti ciascuno
Token di input per richiesta: 3000 · Token di output per richiesta: 1800 · Richieste al giorno: 300
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Tre modi per ridurre la bolletta#
1. Trasforma l'handoff in una breve nota strutturata#
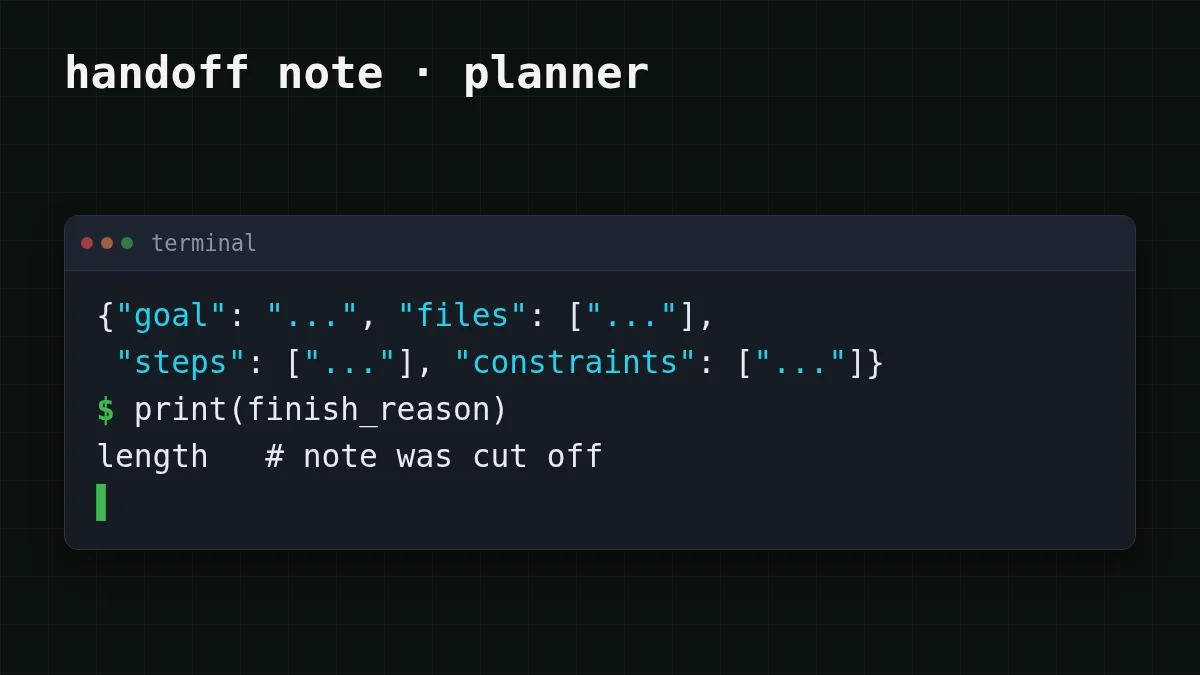
Il planner non ha bisogno di scrivere un tema per il coder. Chiedi dei campi: obiettivo, file, passi, vincoli. Supponi che una breve nota di otto passi da una riga richieda circa 400 token invece di 1.500 (un'ipotesi: inserisci il tuo numero da usage), e ogni agente successivo legge quella nota più piccola. Limita la risposta con max_tokens, impostato un po' sopra la nota attesa, così un modello loquace non può reintrodurre di nascosto il tema.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Se finish_reason è length, la nota è stata troncata dal limite: alza un po' max_tokens o accorcia lo schema (come appare quell'errore). L'id del modello e la base URL sono nella documentazione di CheapTokens.
2. Passa a ogni agente solo ciò che gli serve#
Se il reviewer verifica il codice rispetto al task, non ha bisogno del piano: bastano il task e il codice. Se verifica anche il codice rispetto al piano, tieni il piano. Tagliare il piano dal suo contesto è una modifica da una riga nel tuo orchestrator:
Confronta
Cosa legge il reviewer
Prima: tutto
Task 1.000 + piano 1.500 + codice 3.000 = 5.500 token in input.
Dopo: task e codice
Task 1.000 + codice 3.000 = 4.000 token in input.
Con entrambe le modifiche (e la nota da 400 token, che è una nostra ipotesi), la catena dell'esempio diventa planner 1.000 in input e 400 in output, coder 1.000 + 400 = 1.400 in input e 3.000 in output, reviewer 1.000 + 3.000 = 4.000 in input e 800 in output. Cioè 1.000 + 1.400 + 4.000 = 6.400 token in input e 400 + 3.000 + 800 = 4.200 in output, contro 9.000 e 5.300 di prima. Stessi 100 task al giorno:
| Modello | Input $/1M | Output $/1M | Per richiesta | 100 richieste | OpenRouter, 100 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6400 token di input e 4200 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Per un task su MiniMax-M2.7 la catena ridotta è $0.00095, in calo da $0.0012.
3. Assegna un modello economico ai ruoli brevi#
Il planner scrive risposte brevi, quindi inizia da lì: prova GLM-5.3-Flash (contesto 390K, fino a 8.192 token di output per risposta) e confronta il risultato su 10–20 dei tuoi task. Il coder scrive le risposte più lunghe: DeepSeek-V4-Flash consente fino a 32.768 token di output per risposta. Poiché ogni modello sta su un unico saldo con un unico prezzo a qualsiasi ora, mescolarli in una catena richiede solo una diversa stringa model per agente. I prezzi attuali di entrambi sono nella tabella dei prezzi e nella pagina DeepSeek.
Perché non passare direttamente la KV cache?#
Il paper SwaT (arXiv:2610.15095), inviato il 10 ottobre 2026 da Alabdulkareem, Tenison, Zhang, Zhu, Katz e Gutfreund, propone esattamente questo: gli agenti si passano lo stato della KV cache invece del testo, così il ricevente evita di rileggere il testo. Secondo la pagina dell'abstract (letta il 31 ottobre 2026), gli autori riportano un'accuratezza media superiore del 40% (con compattazione della KV cache) rispetto alla comunicazione testo-a-testo e un tempo medio wall-clock 4x più veloce su 17 benchmark, 12 LLM e 6 famiglie di modelli. Il 40% è accuratezza, non un risparmio su token o prezzo.
Un metodo di ricerca come questo richiede accesso alla cache interna del modello. Una richiesta chat-completions prende testo in input e restituisce testo in output, quindi con un'API la tua leva è il testo: le tre modifiche qui sopra.
Prima di scalare a centinaia di esecuzioni#
Lista di controllo
Checklist degli handoff
Per il quadro più ampio dei budget degli agenti, vedi come stimare il costo di un agente AI e perché gli agenti usano così tanti token.


