Novità AIAggiornamento
Mistral Large 4 open weights: prezzo API e costo per attività di un agente
Mistral Large 4 è ora open-weight, con i prezzi API di Mistral. Scopri quanto costa un'attività di un agente di coding e quando un modello più economico è adatto.
In questa pagina
Mistral Large 4 è ora open-weight: Mistral ha pubblicato i pesi il 29 ottobre 2026 e ha fissato il prezzo API a $0,70 per 1M di token in input e $2,10 per 1M di token in output ($0,07 per l'input in cache). Se esegui agenti di coding, la domanda utile non è il prezzo per token ma quanto costa in totale un'attività lunga.
Cosa ha annunciato Mistral#
Secondo la pagina di rilascio di Mistral (verificata il 30 ottobre 2026), Mistral Large 4 è un modello da circa 1T di parametri, un ibrido di instruct e reasoning costruito come mixture of experts. È nativamente multimodale in input, copre oltre 160 lingue e ha tre modalità di reasoning, Low, Medium e High, con High come predefinita. Il repository Hugging Face è Mistral-; l'id API è mistral-.
I pesi sono distribuiti con la licenza Mistral Ecosystem Open-Weight, una MIT modificata. L'uso commerciale e il fine-tuning sono consentiti. Vendere il modello come servizio hosted richiede una licenza commerciale separata da Mistral. Puoi eseguirlo con vLLM o SGLang, tramite NVIDIA NIM o TensorRT-LLM, oppure usare l'API di Mistral, Microsoft Foundry e Mistral Vibe Code.
Sui benchmark Mistral riporta i propri numeri: 41% su Terminal-Bench 4.0 (la preview segnava 28%), 19,7% su FrontierCode 2.0, 84,5% su BrowseComp e 48% sull'Artificial Analysis Coding Agent Index, che secondo Mistral è al livello di GLM-5.3 con il 47% in meno di token per attività. Sono i risultati del fornitore, non indipendenti, quindi trattali come un motivo per testare sul tuo repository piuttosto che come un verdetto.
Quanto costa un'attività di un agente al prezzo di Mistral#
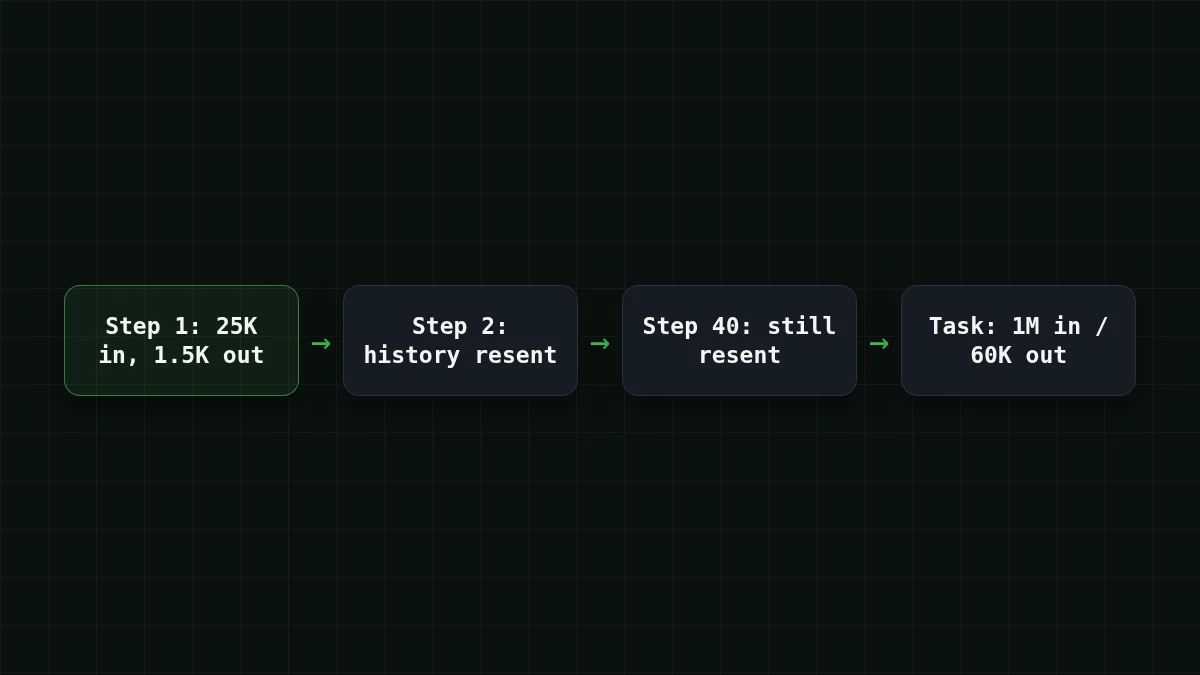
Parti da come un agente consuma davvero i token. Ogni passo rinvia la conversazione fin lì, quindi l'input si accumula mentre ogni risposta resta breve. Supponi che un agente di coding da terminale faccia 40 passi su un'attività, con circa 25.000 token in input e 1.500 token in output per passo. È un'ipotesi a scopo illustrativo; sostituiscila con i tuoi numeri.
Indovina il numero
40 passi a circa 25.000 token in input ciascuno: quanti migliaia di token in input invia in totale l'attività?
La tua risposta
02000
Mostra risposta
Risposta: 1000
25.000 × 40 = 1.000.000 token in input, quindi 1.000 migliaia. L'agente rinvia il proprio contesto a ogni passo, ed è per questo che il volume di input domina le bollette degli agenti.
Al prezzo pubblicato da Mistral (30 ottobre 2026) quell'attività costa 1.000.000 × $0,70 / 1M = $0,70 per l'input e 60.000 × $2,10 / 1M = $0,126 per l'output, quindi $0,70 + $0,126 = $0,826 per attività. Il lato input è la maggior parte della bolletta.
La cache cambia il quadro. Se 20.000 dei 25.000 token in input di ogni passo sono serviti dalla cache a $0,07 per 1M, un passo costa 20.000 × $0,07 / 1M = $0,0014 per l'input in cache, 5.000 × $0,70 / 1M = $0,0035 per l'input fresco e 1.500 × $2,10 / 1M = $0,00315 per l'output. Sono $0,00805 a passo, e $0,00805 × 40 = $0,322 per attività. L'80% di cache hit è un'altra ipotesi, quindi controlla cosa riporta il tuo strumento.
Ecco lo stesso carico di lavoro su una calcolatrice che puoi modificare:
Calcolatore di costi
Un'attività di un agente di coding: 40 passi
Token di input per richiesta: 25.000 · Token di output per richiesta: 1500 · Richieste al giorno: 40
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
E la stessa attività prezzata sui modelli CheapTokens, in tempo reale, accanto a OpenRouter:
| Modello | Input $/1M | Output $/1M | Per richiesta | 40 richieste | OpenRouter, 40 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25.000 token di input e 1500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Per questo ciclo dell'agente, DeepSeek-V4-Flash su CheapTokens arriva a $0.021 per l'intera attività, in totale con input e output contati insieme, ed è più economico del prezzo di riferimento di OpenRouter in totale. Ha una finestra di contesto di 380K e fino a 32.768 token in output per risposta, a un unico prezzo a qualsiasi ora del giorno.
Pesi aperti o API#
I pesi sono la parte interessante di questo rilascio. Se i tuoi dati non possono uscire dalla tua rete, o vuoi fare fine-tuning, ora puoi farlo con un modello di questa classe. Il costo di questa strada è l'hardware. Un modello da 1T di parametri richiede un server multi-GPU anche se solo una parte è attiva per token, e la pagina di Mistral non indica il numero di parametri attivi (il A52B nel nome del repository suggerisce 52B, ma è un'inferenza dal nome). La pagina di Mistral non indica nemmeno la dimensione del contesto.
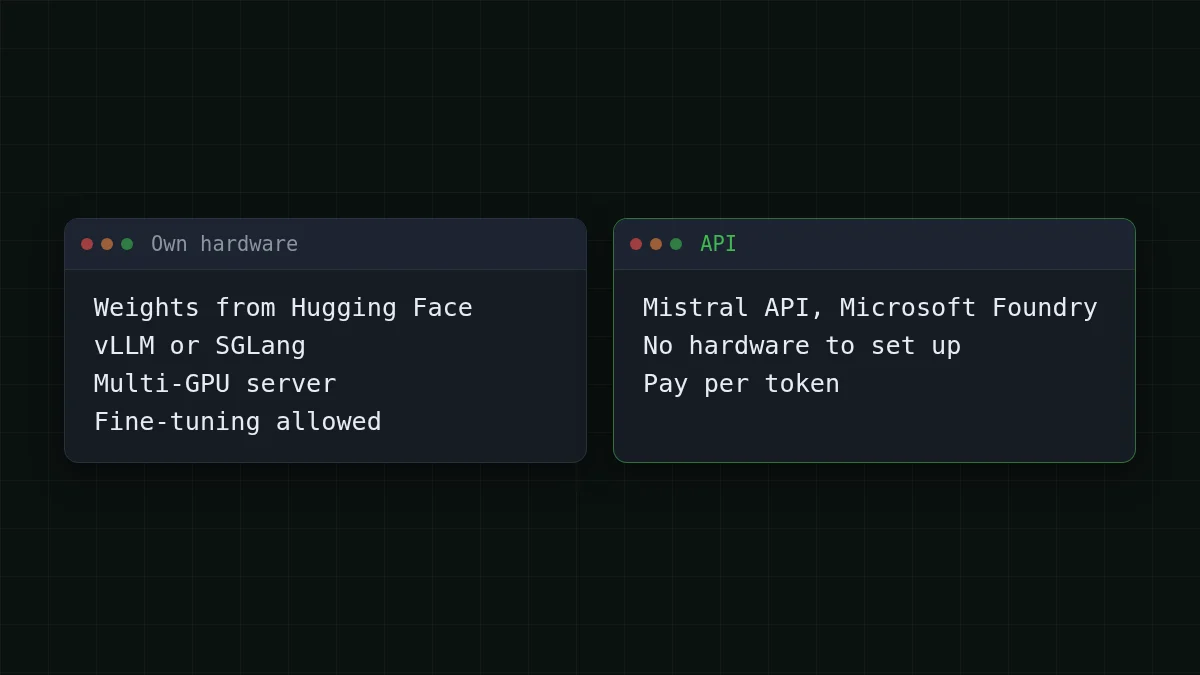
Per la maggior parte dei team che vogliono solo che un agente chiuda i ticket, la strada API evita quella configurazione. Se vuoi il contesto su cosa significano in pratica i pesi aperti, vedi cosa sono i pesi aperti e la quantizzazione.
La stessa attività su un modello per agenti che puoi chiamare oggi#
Se il tuo obiettivo è un agente da terminale o IDE che esegue molti passi a basso costo, puoi provare lo stesso ciclo su DeepSeek-V4-Flash o GLM-5.3-Flash tramite CheapTokens. L'API è compatibile con OpenAI Chat Completions e Anthropic Messages, con un unico saldo per tutti i modelli. Usa l'id completo del modello dalla documentazione di CheapTokens; i nomi dei modelli variano tra i provider.
Una richiesta, due client
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Il campo usage nella risposta mostra i token in input e in output, così puoi misurare il passo del tuo agente e inserirlo nella calcolatrice qui sopra. La nostra guida ai costi di Cline mostra come pianificare il budget di un'intera sessione, e la documentazione spiega come collegare altri strumenti. Pagine dei modelli: DeepSeek economico e prezzi in tempo reale.
Quale per quale lavoro#
I pesi aperti sul tuo hardware, e il fine-tuning, sono una strada separata, ed è quella che questo rilascio apre. Per un ciclo lungo di passi brevi, usa DeepSeek-V4-Flash su CheapTokens: contesto 380K, fino a 32.768 token in output per risposta, un unico prezzo a qualsiasi ora del giorno, e più economico di OpenRouter in totale, con input e output contati insieme. GLM-5.3-Flash ha un contesto di 390K. Il benchmark di Mistral confronta con GLM-5.3 e non dice quale variante di GLM-5.3, quindi non leggere i suoi numeri su GLM-5.3-Flash. Esegui dieci tue attività su ciascuno e confronta i conteggi dei token; lo stesso approccio è in come si calcola il prezzo di GPT-6.1 Terra per attività.


