ข่าว AIอัปเดต
Mistral Large 4 น้ำหนักเปิด: ราคา API และค่าใช้จ่ายต่องานเอเจนต์
Mistral Large 4 เปิดน้ำหนักแล้ว พร้อมราคา API จาก Mistral ดูว่างานโค้ดดิ้งเอเจนต์หนึ่งงานมีค่าใช้จ่ายเท่าไร และเมื่อใดโมเดลที่ถูกกว่าจึงเหมาะสม
ในหน้านี้
Mistral Large 4 เปิดน้ำหนักแล้ว: Mistral เผยแพร่เวตเมื่อวันที่ 29 ตุลาคม 2026 และตั้งราคา API ที่ $0.70 ต่อ 1M โทเคนอินพุต และ $2.10 ต่อ 1M โทเคนเอาต์พุต ($0.07 สำหรับอินพุตที่แคชไว้) ถ้าคุณรันโค้ดดิ้งเอเจนต์ คำถามที่มีประโยชน์ไม่ใช่ราคาต่อโทเคน แต่เป็นงานยาวหนึ่งงานรวมแล้วเท่าไร
Mistral ประกาศอะไร#
ตามหน้าประกาศของ Mistral (ตรวจสอบเมื่อ 30 ตุลาคม 2026) Mistral Large 4 เป็นโมเดลขนาดประมาณ 1T พารามิเตอร์ เป็นไฮบริดของ instruct และ reasoning ที่สร้างเป็น mixture of experts รองรับมัลติโมดัลแบบเนทีฟฝั่งอินพุต ครอบคลุมกว่า 160 ภาษา และมีโหมด reasoning สามแบบ คือ Low, Medium และ High โดย High เป็นค่าเริ่มต้น รีโพซิทอรี Hugging Face คือ Mistral-; ไอดี API คือ mistral-
เวตเผยแพร่ภายใต้สัญญาอนุญาต Mistral Ecosystem Open-Weight ซึ่งดัดแปลงจาก MIT อนุญาตให้ใช้เชิงพาณิชย์และ fine-tune ได้ การขายโมเดลเป็นบริการโฮสต์ต้องมีสัญญาอนุญาตเชิงพาณิชย์แยกจาก Mistral คุณรันได้ด้วย vLLM หรือ SGLang ผ่าน NVIDIA NIM หรือ TensorRT-LLM หรือใช้ API ของ Mistral เอง, Microsoft Foundry และ Mistral Vibe Code
ในด้านเบนช์มาร์ก Mistral รายงานตัวเลขของตัวเอง: 41% บน Terminal-Bench 4.0 (พรีวิวได้ 28%), 19.7% บน FrontierCode 2.0, 84.5% บน BrowseComp และ 48% บน Artificial Analysis Coding Agent Index ซึ่ง Mistral กล่าวว่าอยู่ในระดับเดียวกับ GLM-5.3 โดยใช้โทเคนต่องานน้อยลง 47% เหล่านี้เป็นผลลัพธ์ของผู้ขาย ไม่ใช่ผลลัพธ์อิสระ ดังนั้นจงมองเป็นเหตุผลให้ทดสอบบนรีโพของคุณเองมากกว่าคำตัดสิน
งานเอเจนต์หนึ่งงานมีค่าใช้จ่ายเท่าไรที่ราคาของ Mistral#
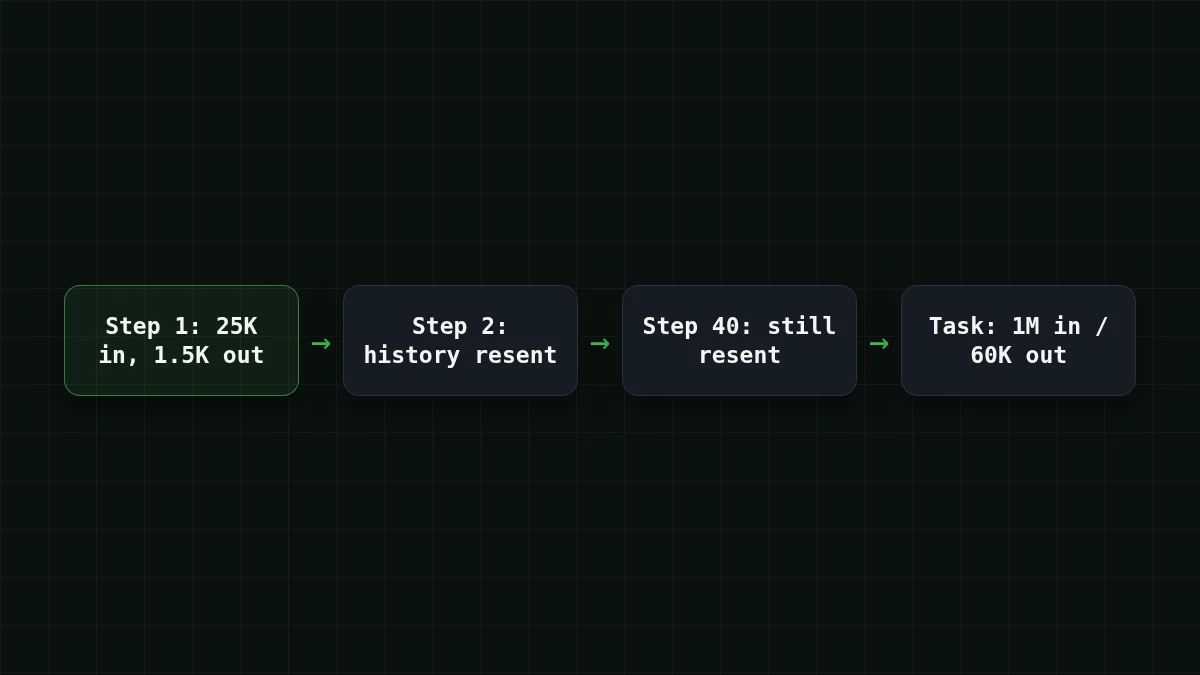
เริ่มจากวิธีที่เอเจนต์ใช้โทเคนจริง ๆ ทุกขั้นตอนจะส่งบทสนทนาที่ผ่านมาทั้งหมดซ้ำ อินพุตจึงพอกพูนขึ้นขณะที่แต่ละคำตอบยังสั้น สมมติว่าเทอร์มินัลโค้ดดิ้งเอเจนต์ใช้ 40 ขั้นตอนในงานหนึ่ง โดยมีอินพุตประมาณ 25,000 โทเคนและเอาต์พุต 1,500 โทเคนต่อขั้นตอน นั่นคือสมมติฐานเพื่อประกอบคำอธิบาย; เปลี่ยนเป็นตัวเลขของคุณเอง
ทายตัวเลข
40 ขั้นตอนที่อินพุตประมาณ 25,000 โทเคนต่อขั้น: งานนี้ส่งอินพุตทั้งหมดกี่พันโทเคน?
คำตอบของคุณ
02,000
แสดงคำตอบ
คำตอบ: 1,000
25,000 × 40 = 1,000,000 โทเคนอินพุต ดังนั้น 1,000 พัน เอเจนต์ส่งบริบทซ้ำในทุกขั้นตอน ซึ่งเป็นเหตุผลที่ปริมาณอินพุตครองค่าใช้จ่ายของเอเจนต์
ที่ราคาที่ Mistral เผยแพร่ (30 ตุลาคม 2026) งานนั้นคือ 1,000,000 × $0.70 / 1M = $0.70 สำหรับอินพุต และ 60,000 × $2.10 / 1M = $0.126 สำหรับเอาต์พุต ดังนั้น $0.70 + $0.126 = $0.826 ต่องาน ฝั่งอินพุตเป็นส่วนใหญ่ของบิล
การแคชเปลี่ยนภาพ หาก 20,000 จาก 25,000 โทเคนอินพุตในแต่ละขั้นเสิร์ฟจากแคชที่ $0.07 ต่อ 1M หนึ่งขั้นมีค่าใช้จ่าย 20,000 × $0.07 / 1M = $0.0014 สำหรับอินพุตที่แคชไว้, 5,000 × $0.70 / 1M = $0.0035 สำหรับอินพุตใหม่ และ 1,500 × $2.10 / 1M = $0.00315 สำหรับเอาต์พุต นั่นคือ $0.00805 ต่อขั้น และ $0.00805 × 40 = $0.322 ต่องาน อัตราการแคชฮิต 80% ก็เป็นอีกสมมติฐานหนึ่ง ดังนั้นตรวจสอบว่าเครื่องมือของคุณรายงานอะไร
นี่คือภาระงานเดียวกันบนเครื่องคิดเลขที่คุณเลื่อนได้:
เครื่องคำนวณค่าใช้จ่าย
งานโค้ดดิ้งเอเจนต์หนึ่งงาน: 40 ขั้นตอน
โทเค็นอินพุตต่อคำขอ: 25,000 · โทเค็นเอาต์พุตต่อคำขอ: 1,500 · คำขอต่อวัน: 40
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
และงานเดียวกันที่คิดราคาข้ามโมเดล CheapTokens แบบสด ๆ เทียบกับ OpenRouter:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 40 คำขอ | OpenRouter, 40 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25,000 โทเค็นอินพุตและ 1,500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
สำหรับลูปเอเจนต์นี้ DeepSeek-V4-Flash บน CheapTokens คิดเป็น $0.021 สำหรับงานทั้งหมด โดยรวมอินพุตและเอาต์พุตเข้าด้วยกัน และถูกกว่าราคาอ้างอิงของ OpenRouter เมื่อรวมทั้งหมด มีหน้าต่างบริบท 380K และเอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ ในราคาเดียวทุกชั่วโมงของวัน
น้ำหนักเปิดหรือ API#
เวตคือส่วนที่น่าสนใจของการเปิดตัวนี้ หากข้อมูลของคุณออกจากเครือข่ายไม่ได้ หรือคุณต้องการ fine-tune ตอนนี้คุณทำได้ด้วยโมเดลระดับนี้ ต้นทุนของเส้นทางนั้นคือฮาร์ดแวร์ โมเดล 1T พารามิเตอร์ต้องใช้เซิร์ฟเวอร์หลาย GPU แม้จะเปิดใช้งานเพียงบางส่วนต่อโทเคน และหน้าของ Mistral ไม่ได้ระบุจำนวนพารามิเตอร์ที่เปิดใช้งาน (A52B ในชื่อรีโพซิทอรีบ่งชี้ว่า 52B แต่นั่นเป็นการอนุมานจากชื่อ) หน้าของ Mistral ก็ไม่ได้ระบุขนาดบริบทเช่นกัน
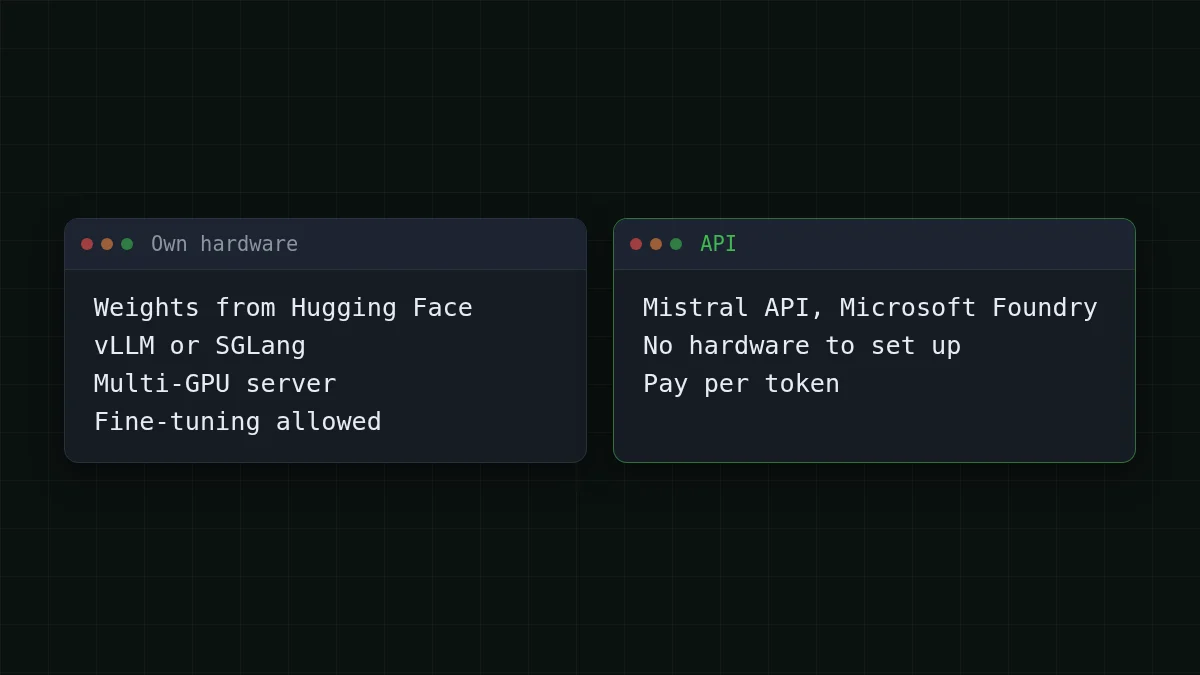
สำหรับทีมส่วนใหญ่ที่เพียงต้องการให้เอเจนต์ปิดตั๋วงานให้เสร็จ เส้นทาง API เลี่ยงการตั้งค่านั้นได้ หากคุณต้องการพื้นฐานว่าการเปิดน้ำหนักหมายถึงอะไรในทางปฏิบัติ ดู น้ำหนักเปิดและการควอนไทซ์คืออะไร
งานเดียวกันบนโมเดลเอเจนต์ที่คุณเรียกได้วันนี้#
หากเป้าหมายของคุณคือเอเจนต์เทอร์มินัลหรือ IDE ที่รันหลายขั้นตอนอย่างประหยัด คุณลองลูปเดียวกันบน DeepSeek-V4-Flash หรือ GLM-5.3-Flash ผ่าน CheapTokens ได้ API เข้ากันได้กับ OpenAI Chat Completions และ Anthropic Messages ด้วยยอดเงินเดียวสำหรับทุกโมเดล ใช้ไอดีโมเดลแบบเต็มจากเอกสาร CheapTokens; ชื่อโมเดลแตกต่างกันระหว่างผู้ให้บริการ
หนึ่งคำขอ สองไคลเอนต์
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
ฟิลด์ usage ในคำตอบแสดงโทเคนอินพุตและเอาต์พุต คุณจึงวัดขั้นตอนของเอเจนต์คุณเองและใส่ลงในเครื่องคิดเลขด้านบนได้ คู่มือค่าใช้จ่าย Cline ของเราแสดงวิธีจัดงบทั้งเซสชัน และ เอกสาร ครอบคลุมการเชื่อมต่อเครื่องมืออื่น หน้าโมเดล: DeepSeek ราคาถูก และ ราคา แบบสด
อันไหนสำหรับงานไหน#
น้ำหนักเปิดบนฮาร์ดแวร์ของคุณเอง และการ fine-tune เป็นเส้นทางแยก และนั่นคือสิ่งที่การเปิดตัวนี้เปิดขึ้น สำหรับลูปยาวของขั้นตอนสั้น ๆ ใช้ DeepSeek-V4-Flash บน CheapTokens: บริบท 380K เอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ ราคาเดียวทุกชั่วโมงของวัน และถูกกว่า OpenRouter เมื่อรวมทั้งหมด โดยนับอินพุตและเอาต์พุตเข้าด้วยกัน GLM-5.3-Flash มีบริบท 390K เบนช์มาร์กของ Mistral เปรียบเทียบกับ GLM-5.3 และไม่ได้ระบุว่าเป็น GLM-5.3 รุ่นใด ดังนั้นอย่าอ่านตัวเลขของมันไปยัง GLM-5.3-Flash รันงานของคุณเองสิงานในแต่ละโมเดลแล้วเปรียบเทียบจำนวนโทเคน วิธีเดียวกันอยู่ใน ราคา GPT-6.1 Terra คิดต่องานอย่างไร


