Notícias de IAAtualização
Mistral Large 4 com pesos abertos: preço da API e custo por tarefa de agente
O Mistral Large 4 agora tem pesos abertos, com preços de API da Mistral. Veja quanto custa uma tarefa de agente de programação e quando um modelo mais barato se encaixa.
Nesta página
O Mistral Large 4 agora tem pesos abertos: a Mistral publicou os pesos em 29 de outubro de 2026 e definiu o preço da API em US$ 0,70 por 1M de tokens de entrada e US$ 2,10 por 1M de tokens de saída (US$ 0,07 para entrada em cache). Se você roda agentes de programação, a pergunta útil não é o preço por token, mas quanto uma tarefa longa soma no total.
O que a Mistral anunciou#
Segundo a página de lançamento da Mistral (verificada em 30 de outubro de 2026), o Mistral Large 4 é um modelo de cerca de 1T de parâmetros, um híbrido de instruct e reasoning construído como mistura de especialistas. É nativamente multimodal na entrada, cobre mais de 160 idiomas e tem três modos de raciocínio, Low, Medium e High, com High como padrão. O repositório no Hugging Face é Mistral-; o id da API é mistral-.
Os pesos são distribuídos sob a licença Mistral Ecosystem Open-Weight, uma MIT modificada. Uso comercial e fine-tuning são permitidos. Vender o modelo como serviço hospedado exige uma licença comercial separada da Mistral. Você pode rodá-lo com vLLM ou SGLang, via NVIDIA NIM ou TensorRT-LLM, ou usar a própria API da Mistral, o Microsoft Foundry e o Mistral Vibe Code.
Nos benchmarks a Mistral reporta seus próprios números: 41% no Terminal-Bench 4.0 (a prévia marcou 28%), 19,7% no FrontierCode 2.0, 84,5% no BrowseComp e 48% no Artificial Analysis Coding Agent Index, que a Mistral diz estar no nível do GLM-5.3 com 47% menos tokens por tarefa. São resultados do fornecedor, não independentes, então trate-os como motivo para testar no seu próprio repositório, não como veredito.
Quanto custa uma tarefa de agente no preço da Mistral#
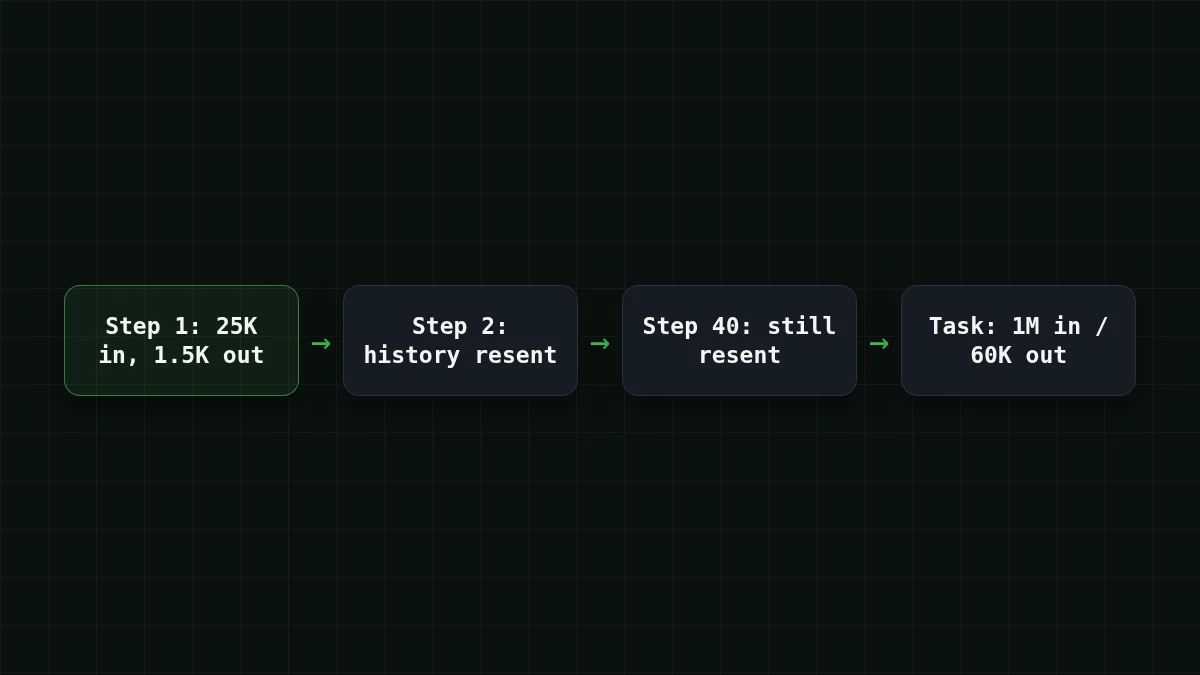
Comece por como um agente realmente gasta tokens. Cada passo reenvia a conversa até ali, então a entrada se acumula enquanto cada resposta fica curta. Digamos que um agente de programação de terminal faça 40 passos em uma tarefa, com cerca de 25.000 tokens de entrada e 1.500 tokens de saída por passo. Isso é uma suposição para ilustração; troque pelos seus próprios números.
Adivinhar o número
40 passos com cerca de 25.000 tokens de entrada cada: quantos milhares de tokens de entrada a tarefa envia no total?
O seu palpite
02.000
Mostrar resposta
Resposta: 1.000
25.000 × 40 = 1.000.000 de tokens de entrada, ou seja, 1.000 milhares. O agente reenvia seu contexto a cada passo, e é por isso que o volume de entrada domina as contas de agentes.
No preço publicado da Mistral (30 de outubro de 2026), essa tarefa é 1.000.000 × US$ 0,70 / 1M = US$ 0,70 de entrada e 60.000 × US$ 2,10 / 1M = US$ 0,126 de saída, então US$ 0,70 + US$ 0,126 = US$ 0,826 por tarefa. O lado da entrada é a maior parte da conta.
O cache muda o quadro. Se 20.000 dos 25.000 tokens de entrada em cada passo forem servidos do cache a US$ 0,07 por 1M, um passo custa 20.000 × US$ 0,07 / 1M = US$ 0,0014 de entrada em cache, 5.000 × US$ 0,70 / 1M = US$ 0,0035 de entrada nova e 1.500 × US$ 2,10 / 1M = US$ 0,00315 de saída. Isso dá US$ 0,00805 por passo, e US$ 0,00805 × 40 = US$ 0,322 por tarefa. A taxa de acerto de cache de 80% é outra suposição, então confira o que sua ferramenta reporta.
Aqui está a mesma carga de trabalho em uma calculadora que você pode mover:
Calculadora de custos
Uma tarefa de agente de programação: 40 passos
Tokens de entrada por solicitação: 25.000 · Tokens de saída por solicitação: 1.500 · Solicitações por dia: 40
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
E a mesma tarefa precificada entre os modelos CheapTokens, ao vivo, ao lado do OpenRouter:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 40 solicitações | OpenRouter, 40 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25.000 tokens de entrada e 1.500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Para este loop de agente, o DeepSeek-V4-Flash no CheapTokens fica em $0.021 para a tarefa inteira, no total com entrada e saída contadas juntas, e é mais barato que o preço de referência do OpenRouter no total. Tem janela de contexto de 380K e até 32.768 tokens de saída por resposta, a um preço em qualquer hora do dia.
Pesos abertos ou a API#
Os pesos são a parte interessante deste lançamento. Se seus dados não podem sair da sua rede, ou se você quer fazer fine-tuning, agora você pode fazer isso com um modelo dessa classe. O custo desse caminho é hardware. Um modelo de 1T de parâmetros precisa de um servidor multi-GPU mesmo que só uma parte dele esteja ativa por token, e a página da Mistral não informa a contagem de parâmetros ativos (o A52B no nome do repositório sugere 52B, mas isso é uma inferência a partir do nome). A página da Mistral também não informa o tamanho do contexto.
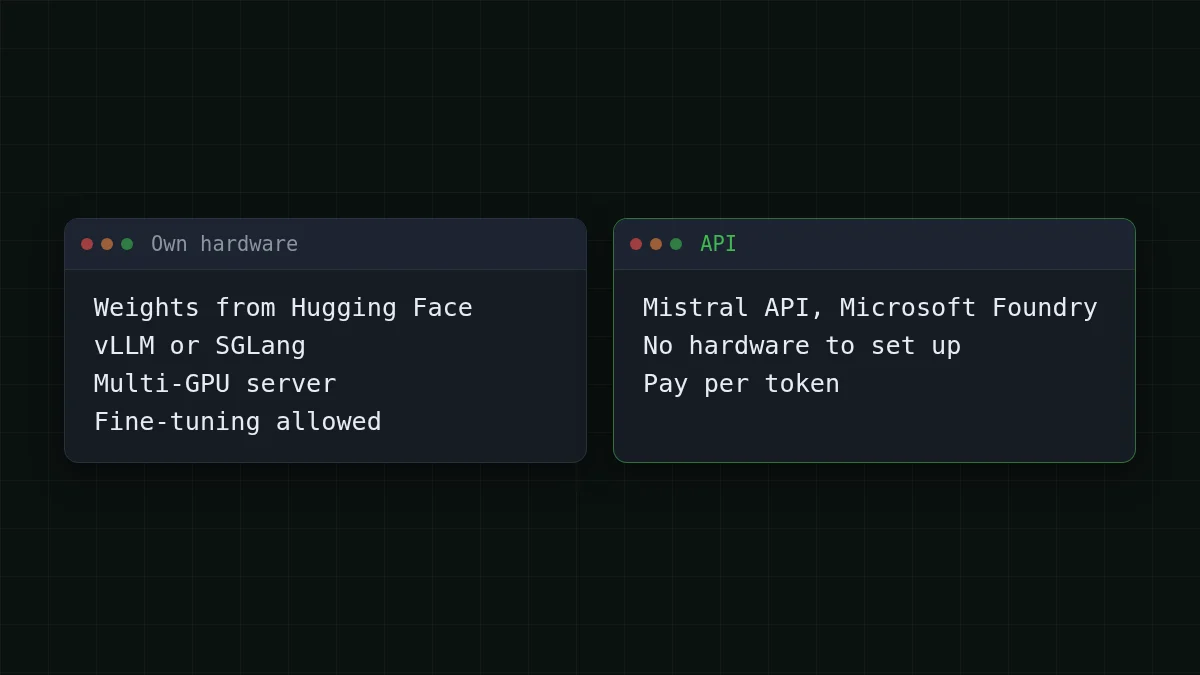
Para a maioria das equipes que só quer um agente para concluir tickets, o caminho da API evita essa configuração. Se você quer o contexto sobre o que pesos abertos significam na prática, veja o que são pesos abertos e quantização.
A mesma tarefa em um modelo de agente que você pode chamar hoje#
Se seu objetivo é um agente de terminal ou IDE que roda muitos passos barato, você pode testar o mesmo loop no DeepSeek-V4-Flash ou no GLM-5.3-Flash pelo CheapTokens. A API é compatível com OpenAI Chat Completions e Anthropic Messages, com um saldo para todos os modelos. Use o id completo do modelo da documentação do CheapTokens; os nomes de modelo diferem entre provedores.
Uma requisição, dois clientes
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
O campo usage na resposta mostra tokens de entrada e saída, então você pode medir o passo do seu próprio agente e colocá-lo na calculadora acima. Nosso guia de custos do Cline mostra como orçar uma sessão inteira, e a documentação cobre a conexão de outras ferramentas. Páginas de modelos: DeepSeek barato, e preços ao vivo.
Qual para qual trabalho#
Pesos abertos no seu próprio hardware, e fine-tuning, são um caminho separado, e é isso que este lançamento abre. Para um loop longo de passos curtos, use o DeepSeek-V4-Flash no CheapTokens: contexto de 380K, até 32.768 tokens de saída por resposta, um preço em qualquer hora do dia, e mais barato que o OpenRouter no total, com entrada e saída contadas juntas. O GLM-5.3-Flash tem contexto de 390K. O benchmark da Mistral compara com o GLM-5.3, e não diz qual variante do GLM-5.3, então não leia seus números como se fossem do GLM-5.3-Flash. Rode dez tarefas suas em cada um e compare as contagens de tokens; a mesma abordagem está em como o preço do GPT-6.1 Terra fica por tarefa.


