Noticias de IAActualización
Pesos abiertos de Mistral Large 4: precio de la API y coste por tarea de agente
Mistral Large 4 ya tiene pesos abiertos, con precios de API de Mistral. Descubre cuánto cuesta una tarea de agente de programación y cuándo encaja un modelo más barato.
En esta página
Mistral Large 4 ya tiene pesos abiertos: Mistral publicó los pesos el 29 de octubre de 2026 y fijó el precio de la API en $0.70 por 1M de tokens de entrada y $2.10 por 1M de tokens de salida ($0.07 para entrada en caché). Si ejecutas agentes de programación, la pregunta útil no es el precio por token sino cuánto suma una tarea larga.
Qué anunció Mistral#
Según la página de lanzamiento de Mistral (consultada el 30 de octubre de 2026), Mistral Large 4 es un modelo de unos 1T de parámetros, un híbrido de instruct y razonamiento construido como mezcla de expertos. Es multimodal de forma nativa en la entrada, cubre más de 160 idiomas y tiene tres modos de razonamiento, Low, Medium y High, con High como predeterminado. El repositorio de Hugging Face es Mistral-; el id de la API es mistral-.
Los pesos se distribuyen bajo la licencia Mistral Ecosystem Open-Weight, una MIT modificada. Se permite el uso comercial y el fine-tuning. Vender el modelo como servicio alojado requiere una licencia comercial aparte de Mistral. Puedes ejecutarlo con vLLM o SGLang, mediante NVIDIA NIM o TensorRT-LLM, o usar la propia API de Mistral, Microsoft Foundry y Mistral Vibe Code.
En los benchmarks Mistral reporta sus propias cifras: 41% en Terminal-Bench 4.0 (la preview obtuvo 28%), 19.7% en FrontierCode 2.0, 84.5% en BrowseComp y 48% en el Artificial Analysis Coding Agent Index, que según Mistral está a la altura de GLM-5.3 con un 47% menos de tokens por tarea. Son resultados del proveedor, no independientes, así que tómalos como un motivo para probar en tu propio repositorio y no como un veredicto.
Cuánto cuesta una tarea de agente al precio de Mistral#
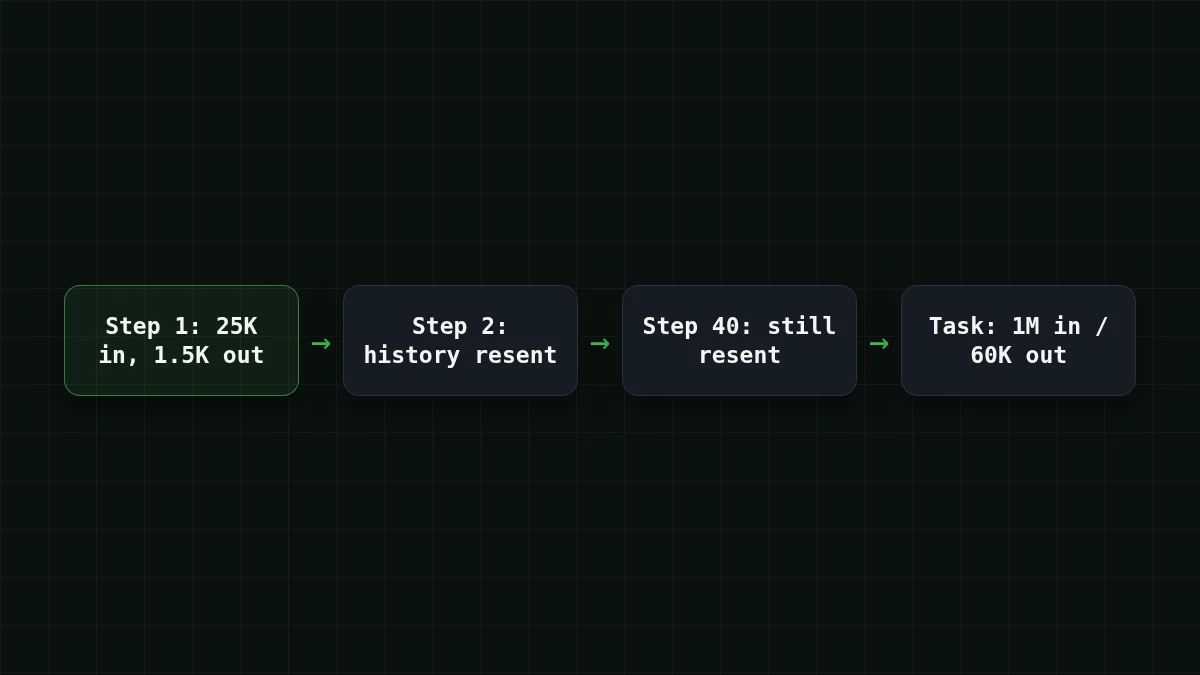
Empieza por cómo gasta tokens realmente un agente. Cada paso reenvía la conversación hasta ese momento, así que la entrada se acumula mientras cada respuesta sigue siendo corta. Supongamos que un agente de programación de terminal da 40 pasos en una tarea, con unos 25,000 tokens de entrada y 1,500 tokens de salida por paso. Es una suposición ilustrativa; sustituye tus propias cifras.
Adivina el número
40 pasos con unos 25,000 tokens de entrada cada uno: ¿cuántos miles de tokens de entrada envía la tarea en total?
Tu respuesta
02000
Mostrar respuesta
Respuesta: 1000
25,000 × 40 = 1,000,000 de tokens de entrada, es decir, 1,000 miles. El agente reenvía su contexto en cada paso, por eso el volumen de entrada domina las facturas de los agentes.
Al precio publicado por Mistral (30 de octubre de 2026), esa tarea es 1,000,000 × $0.70 / 1M = $0.70 de entrada y 60,000 × $2.10 / 1M = $0.126 de salida, así que $0.70 + $0.126 = $0.826 por tarea. La parte de entrada es la mayor parte de la factura.
El caché cambia el panorama. Si 20,000 de los 25,000 tokens de entrada de cada paso se sirven desde caché a $0.07 por 1M, un paso cuesta 20,000 × $0.07 / 1M = $0.0014 de entrada en caché, 5,000 × $0.70 / 1M = $0.0035 de entrada nueva y 1,500 × $2.10 / 1M = $0.00315 de salida. Eso es $0.00805 por paso, y $0.00805 × 40 = $0.322 por tarea. La tasa de acierto de caché del 80% es otra suposición, así que comprueba lo que reporta tu herramienta.
Aquí tienes la misma carga de trabajo en una calculadora que puedes mover:
Calculadora de costos
Una tarea de agente de programación: 40 pasos
Tokens de entrada por solicitud: 25.000 · Tokens de salida por solicitud: 1500 · Solicitudes por día: 40
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
Y la misma tarea con precios de los modelos de CheapTokens, en vivo, junto a OpenRouter:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 40 solicitudes | OpenRouter, 40 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25.000 tokens de entrada y 1500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Para este bucle de agente, DeepSeek-V4-Flash en CheapTokens sale a $0.021 por la tarea completa, en total con entrada y salida contadas juntas, y es más barato que el precio de referencia de OpenRouter en total. Tiene una ventana de contexto de 380K y hasta 32,768 tokens de salida por respuesta, a un solo precio a cualquier hora del día.
Pesos abiertos o la API#
Los pesos son la parte interesante de este lanzamiento. Si tus datos no pueden salir de tu red, o quieres hacer fine-tuning, ahora puedes hacerlo con un modelo de esta clase. El coste de esa vía es el hardware. Un modelo de 1T de parámetros necesita un servidor multi-GPU aunque solo una parte esté activa por token, y la página de Mistral no indica el número de parámetros activos (el A52B en el nombre del repositorio sugiere 52B, pero es una inferencia a partir del nombre). La página de Mistral tampoco indica el tamaño de contexto.
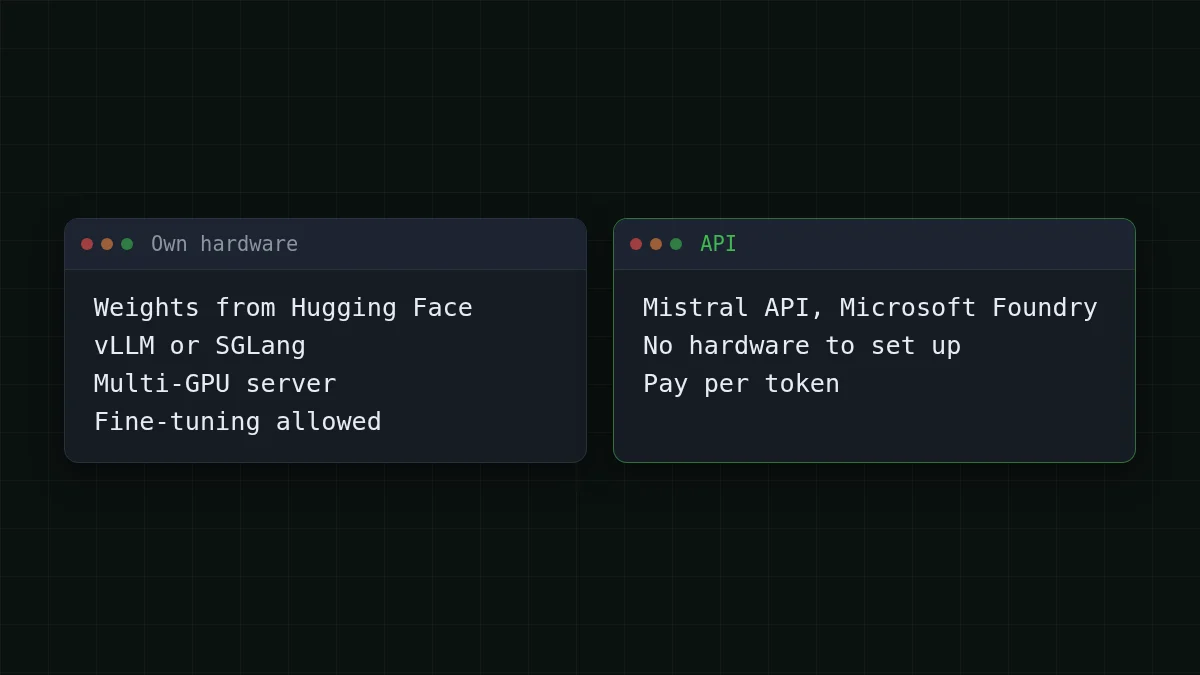
Para la mayoría de los equipos que solo quieren que un agente termine tickets, la vía de la API evita esa configuración. Si quieres el contexto sobre qué significan los pesos abiertos en la práctica, consulta qué son los pesos abiertos y la cuantización.
La misma tarea en un modelo de agente que puedes llamar hoy#
Si tu objetivo es un agente de terminal o de IDE que ejecute muchos pasos de forma barata, puedes probar el mismo bucle en DeepSeek-V4-Flash o GLM-5.3-Flash a través de CheapTokens. La API es compatible con OpenAI Chat Completions y Anthropic Messages, con un solo saldo para todos los modelos. Usa el id de modelo completo de la documentación de CheapTokens; los nombres de modelo difieren entre proveedores.
Una petición, dos clientes
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
El campo usage de la respuesta muestra los tokens de entrada y salida, así que puedes medir el paso de tu propio agente y meterlo en la calculadora de arriba. Nuestra guía de costes de Cline muestra cómo presupuestar una sesión completa, y la documentación cubre cómo conectar otras herramientas. Páginas de modelos: DeepSeek barato y precios en vivo.
Cuál para cada trabajo#
Los pesos abiertos en tu propio hardware, y el fine-tuning, son una vía aparte, y eso es lo que abre este lanzamiento. Para un bucle largo de pasos cortos, usa DeepSeek-V4-Flash en CheapTokens: contexto de 380K, hasta 32,768 tokens de salida por respuesta, un solo precio a cualquier hora del día y más barato que OpenRouter en total, con entrada y salida contadas juntas. GLM-5.3-Flash tiene un contexto de 390K. El benchmark de Mistral compara con GLM-5.3, y no dice qué variante de GLM-5.3, así que no traslades sus cifras a GLM-5.3-Flash. Ejecuta diez tareas propias en cada uno y compara los recuentos de tokens; el mismo enfoque está en cómo sale el precio de GPT-6.1 Terra por tarea.


