Cómo funciona un agente de IA: el bucle, ejecutado sin clave de API
Un agente de IA es un bucle: el modelo pide una herramienta, tu código la ejecuta, el resultado vuelve. Ejecuta una demo de Python sin clave y luego apúntala a un modelo real.
En esta página
Le pides a un agente de programación que corrija una errata y ves cómo se desplaza el registro: leer un archivo, buscar, leer otro archivo, editar, ejecutar las pruebas. Una pequeña petición, una docena de llamadas al modelo. ¿De dónde vienen?
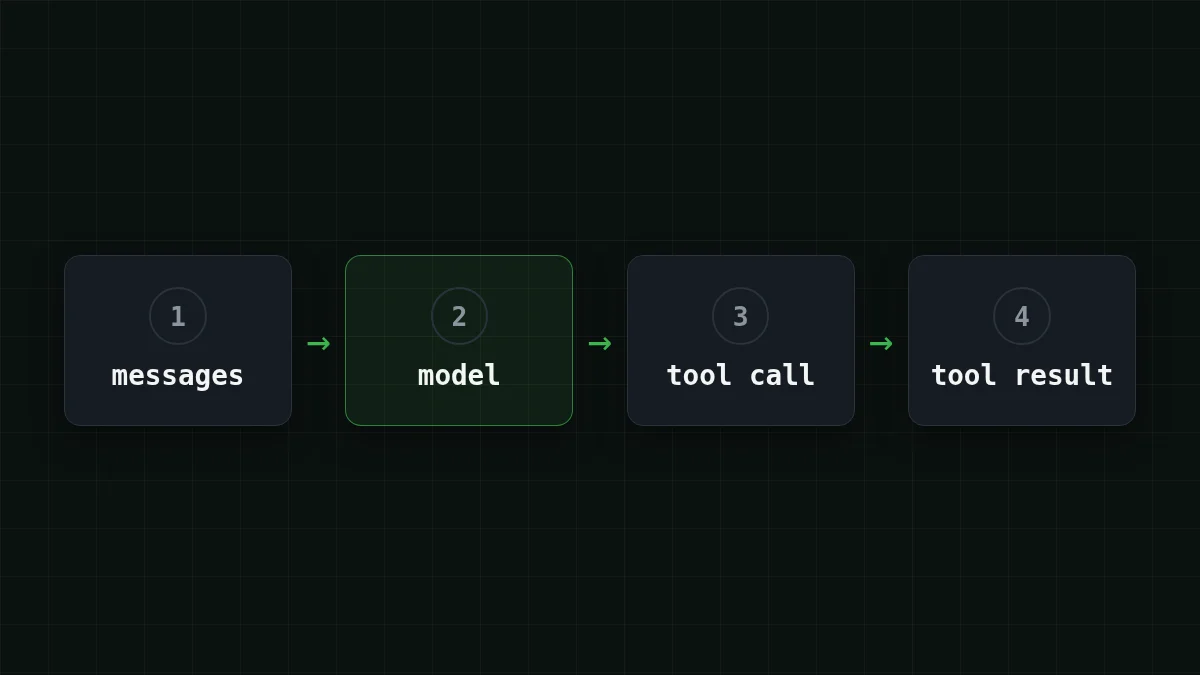
Un agente de IA es un bucle. Tu programa envía la conversación al modelo; el modelo responde o pide una herramienta ("lee este archivo"); tu programa ejecuta la herramienta, añade el resultado a la conversación y vuelve a llamar al modelo. Se repite hasta que el modelo responde en texto plano. Los agentes de programación como Claude Code, Codex y el modo agente de Cursor se construyen en torno a este mismo bucle, con más herramientas y más cuidado. A continuación ejecutarás una versión de 40 líneas sin ninguna clave, y luego la apuntarás a un modelo real.
El bucle en una imagen#
Piensa en un gerente que no puede tocar nada. El gerente solo escribe notas: "por favor, tráeme todo.txt". Un asistente (tu programa) va al estante, trae el archivo y lo pone sobre el escritorio. El gerente lo lee y escribe la siguiente nota, o la respuesta final.
Ese es todo el truco. El modelo nunca abre un archivo ni ejecuta un comando. Escribe texto que dice qué herramienta llamar y con qué argumentos. Tu código hace el trabajo y le informa. Si has visto function calling, este es el mismo mecanismo, repetido hasta que el trabajo está hecho.
¿Puedes poner una vuelta del bucle en el orden correcto?
Poner en orden
Pon una vuelta del bucle del agente en orden
Arrastra los elementos o usa las flechas
- Enviar la tarea y la lista de herramientas al modelo
- El modelo responde con una llamada a herramienta, no con texto
- Tu programa ejecuta esa herramienta por sí mismo
- El resultado entra en los mensajes como un mensaje "tool"
- Se vuelve a llamar al modelo con el resultado, hasta que responde en texto plano
Ejecútalo sin clave#
Digamos que la tarea es: "¿Cuántos elementos hay en todo.txt?". La herramienta es una función read_file que busca en un pequeño diccionario en lugar de en un disco. Y en lugar de un modelo real hay uno programado que siempre hace las mismas dos cosas: pedir el archivo, luego responder. Eso es suficiente para ver cada pieza en movimiento. Guarda esto como agent_loop.py (Python 3.10+, solo biblioteca estándar):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Ejecuta python agent_. Sin LLM_API_KEY en tu entorno obtienes el modelo programado, y la pantalla muestra exactamente dos vueltas:
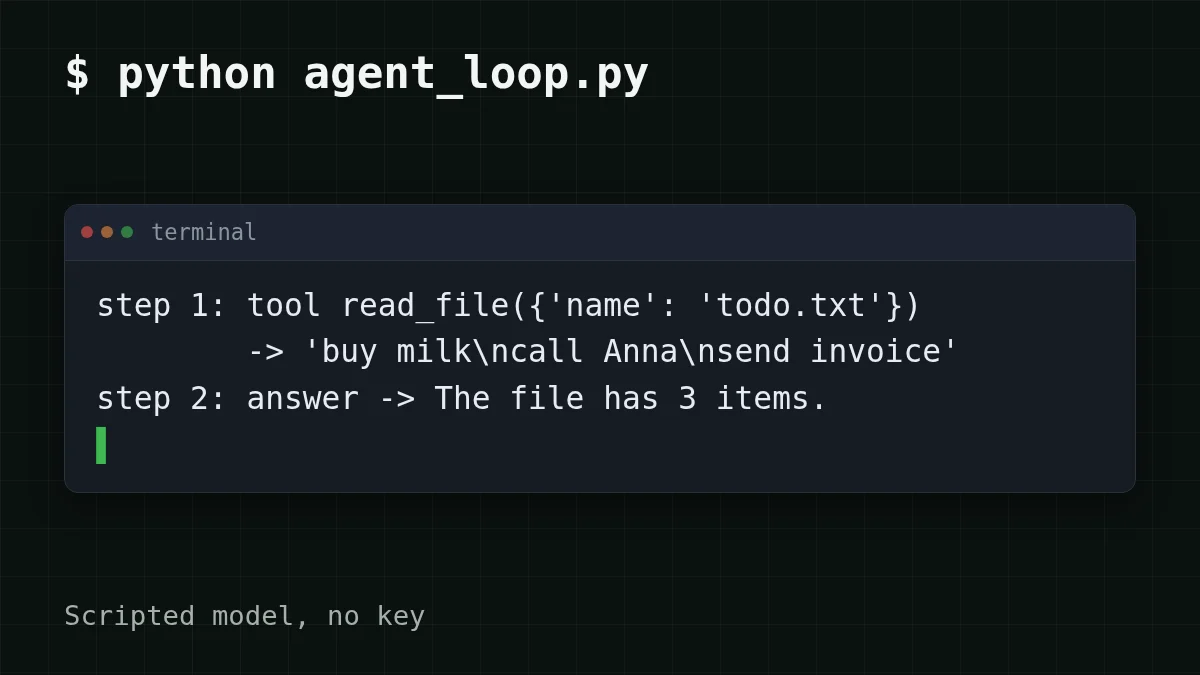
Fíjate en tres líneas, porque contienen toda la idea:
messages.conserva el turno del propio modelo. Si lo omites, la siguiente llamada contiene un resultado de herramienta que responde a una petición que la API nunca ha visto; la mayoría de las API lo rechazan con un 400.append(reply) argumentsllega como una cadena JSON, así que pasa porjson.loadsantes de llamar a la función.max_stepses el freno de emergencia. Un modelo puede seguir pidiendo herramientas para siempre, así que todo agente real tiene un límite como este.
Apunta el mismo bucle a un modelo real#
Solo cambia una cosa: quién interpreta al modelo. El script lee tres variables de entorno, y si hay una clave presente envía el mismo messages a un endpoint compatible con OpenAI. La dirección de CheapTokens es https:/ (compatible con OpenAI Chat Completions y Anthropic Messages), y el id del modelo tiene que ser el completo de la documentación: deepseek-.
Ejecuta el bucle de tres formas
Sin clave
python agent_loop.pyEl modelo programado interpreta ambas vueltas. Nada sale de tu máquina.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Una ventana de contexto de 380K y hasta 32.768 tokens de salida por respuesta: espacio para un bucle largo.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Un modelo ligero con una ventana de contexto de 390K para una primera ejecución de un bucle de varios pasos.
Lo que deberías ver es la misma forma que antes: step 1: tool read_, luego step 2: answer -, con una línea usage: bajo cada llamada al modelo. La redacción de la respuesta diferirá de la programada, y un modelo charlatán puede dar una vuelta extra. Eso es normal: el modelo decide, el bucle solo obedece. Mantén la clave fuera del propio script; una variable de entorno es el lugar seguro (aquí tienes cómo guardarla).
Las líneas usage: son la parte útil. Añade los números in de una ejecución más larga y verás a dónde va el dinero.
Por qué cada vuelta cuesta más que la anterior#
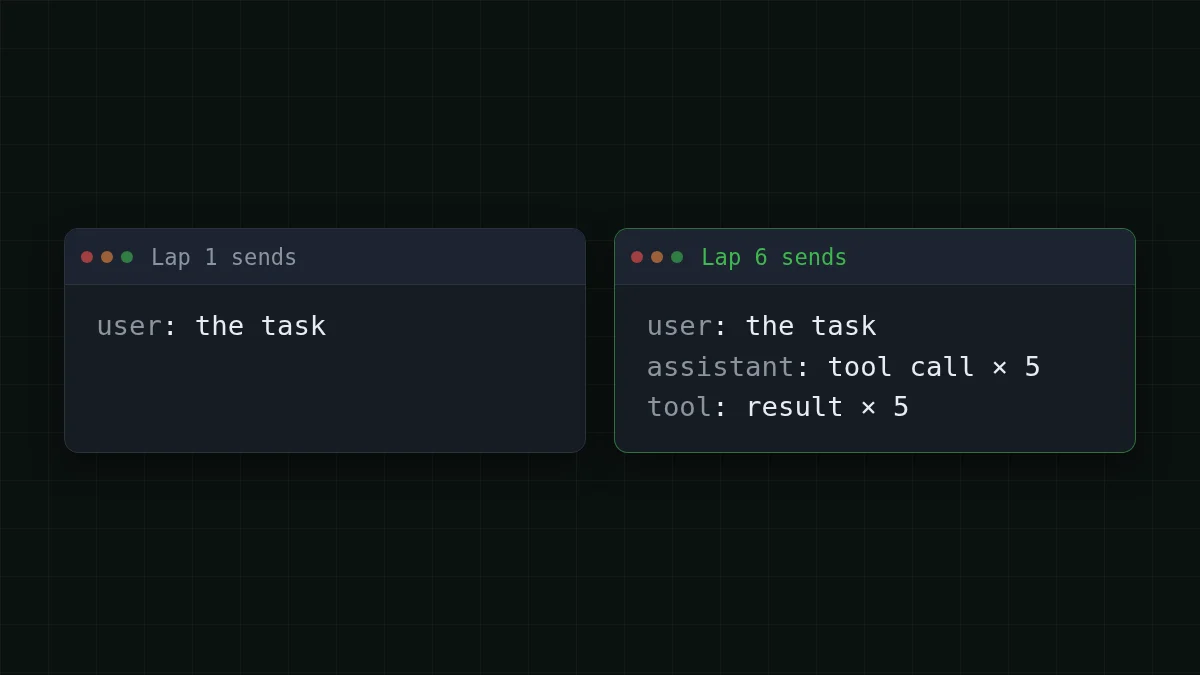
El modelo no recuerda nada entre llamadas. Cada vuelta envía de nuevo la lista completa messages: la tarea, cada llamada a herramienta anterior, cada resultado de herramienta. (La misma regla hace caro un chat largo; chat multi-turno lo muestra en una conversación normal.)
La vuelta 1 envía un mensaje. Si el bucle sigue, la vuelta 6 envía once.
Digamos que una tarea real requiere 10 vueltas. Empieza con unos 2.000 tokens (instrucciones, lista de herramientas, tu petición), cada vuelta añade unos 1.500 (un resultado de herramienta más la nota del modelo), y el modelo escribe unos 300 tokens por vuelta. La vuelta 1 envía 2.000, la vuelta 2 envía 3.500, la vuelta 10 envía 15.500. La suma de la primera parte es 10 × 2.000 = 20.000 tokens; el crecimiento añade 1.500 × 45 = 67.500 (45 es 0+1+…+9), así que la entrada sobre la tarea es 20.000 + 67.500 = 87.500 tokens. La salida es 10 × 300 = 3.000 tokens.
El texto de la tarea en sí son unas pocas frases, sin embargo el lado de entrada es de 87.500 tokens. A $0.015 por 1M de tokens de entrada, toda la tarea en DeepSeek-V4-Flash sale por $0.0016. Aquí está la misma carga en los modelos, con OpenRouter como referencia. En total, contando entrada y salida juntas, CheapTokens resulta más barato que OpenRouter en esta carga:
| Modelo | Entrada $/1M | Salida $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87.500 tokens de entrada y 3000 tokens de salida en total. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Un precio único a cualquier hora del día también ayuda aquí: un agente que se ejecuta durante la noche cuesta lo mismo que uno al mediodía, y puedes ver todos los precios en la página de precios. Para un día de tales tareas, mueve los deslizadores:
Calculadora de costos
Un día: 20 tareas de 10 vueltas cada una
Tokens de entrada por solicitud: 8750 · Tokens de salida por solicitud: 300 · Solicitudes por día: 200
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Los campos son por llamada al modelo: 8.750 es la entrada promedio de una vuelta del ejemplo anterior (87.500 ÷ 10), y 200 llamadas son 20 tareas × 10 vueltas. Por eso las facturas de agentes tienen que ver con el historial, no con la pregunta. El ejemplo de 20 pasos profundiza en el mismo efecto.
Verificación rápida
La vuelta 3 de un bucle de agente cuesta más que la vuelta 1, aunque no hayas preguntado nada nuevo. ¿Por qué?
Mostrar respuesta
Respuesta: La lista de mensajes ahora contiene dos llamadas a herramienta y dos resultados, y todo ello se envía de nuevo
La API no tiene estado. Cada llamada lleva el historial completo, así que los tokens de entrada crecen con cada vuelta mientras la salida se mantiene más o menos igual.
A dónde ir desde las 40 líneas#
El script anterior es un boceto para aprender. Si quieres la versión larga, hay un curso abierto en GitHub, justxor/agent-harness-course (README en ruso, comprobado el 31 de octubre de 2026). Es Python 3.10+ puro sin dependencias, el código tiene licencia MIT, el texto es CC BY 4.0. Después de clonar, python examples/ ejecuta el bucle sin conexión con un modelo programado, y python - ejecuta sus 19 pruebas sin red. El curso continúa con compactación de contexto, memoria, subagentes, aprobación humana de acciones riesgosas y seguimiento de costos. Para un modelo real lee LLM_PROVIDER, LLM_MODEL, LLM_API_KEY y, para endpoints compatibles con OpenAI, LLM_BASE_URL: toma el valor exacto de LLM_PROVIDER de su README.
Cuando el bucle funcione, el siguiente paso es una clave real y una tarea real: la documentación tiene una primera petición en un minuto, y DeepSeek-V4-Flash es un buen modelo para ejecutar el bucle.


