Yeni başlayanlar için AIKılavuz
Bir yapay zeka ajanı nasıl çalışır: döngü, API anahtarı olmadan çalıştırma
Bir yapay zeka ajanı bir döngüdür: model bir araç ister, kodunuz onu çalıştırır, sonuç geri döner. Anahtarsız bir Python demosu çalıştırın, sonra onu gerçek bir modele yönlendirin.
Bu sayfada
Bir kodlama ajanından tek bir yazım hatasını düzeltmesini istersiniz ve günlüğün kaydığını görürsünüz: bir dosya oku, ara, başka bir dosya oku, düzenle, testleri çalıştır. Tek bir küçük istek, bir düzine model çağrısı. Bunlar nereden geliyor?
Bir yapay zeka ajanı bir döngüdür. Programınız konuşmayı modele gönderir; model ya yanıtlar ya da bir araç ister ("bu dosyayı oku"); programınız aracı çalıştırır, sonucu konuşmaya ekler ve modeli tekrar çağırır. Model düz metin olarak yanıtlayana kadar tekrarlanır. Claude Code, Codex ve Cursor'ın ajan modu gibi kodlama ajanları da aynı döngü etrafında, daha fazla araç ve daha fazla özenle inşa edilmiştir. Aşağıda hiç anahtar olmadan 40 satırlık bir sürümü çalıştıracak, sonra onu gerçek bir modele yönlendireceksiniz.
Tek resimde döngü#
Hiçbir şeye dokunamayan bir yönetici düşünün. Yönetici sadece notlar yazar: "lütfen bana todo.txt getir". Bir asistan (programınız) rafa gider, dosyayı getirir ve masaya koyar. Yönetici onu okur ve bir sonraki notu ya da nihai yanıtı yazar.
Bütün numara bu. Model asla bir dosya açmaz veya komut çalıştırmaz. Hangi aracın hangi argümanlarla çağrılacağını söyleyen metin yazar. İşi kodunuz yapar ve geri bildirir. Fonksiyon çağrısını gördüyseniz, bu aynı mekanizmadır, iş bitene kadar tekrarlanır.
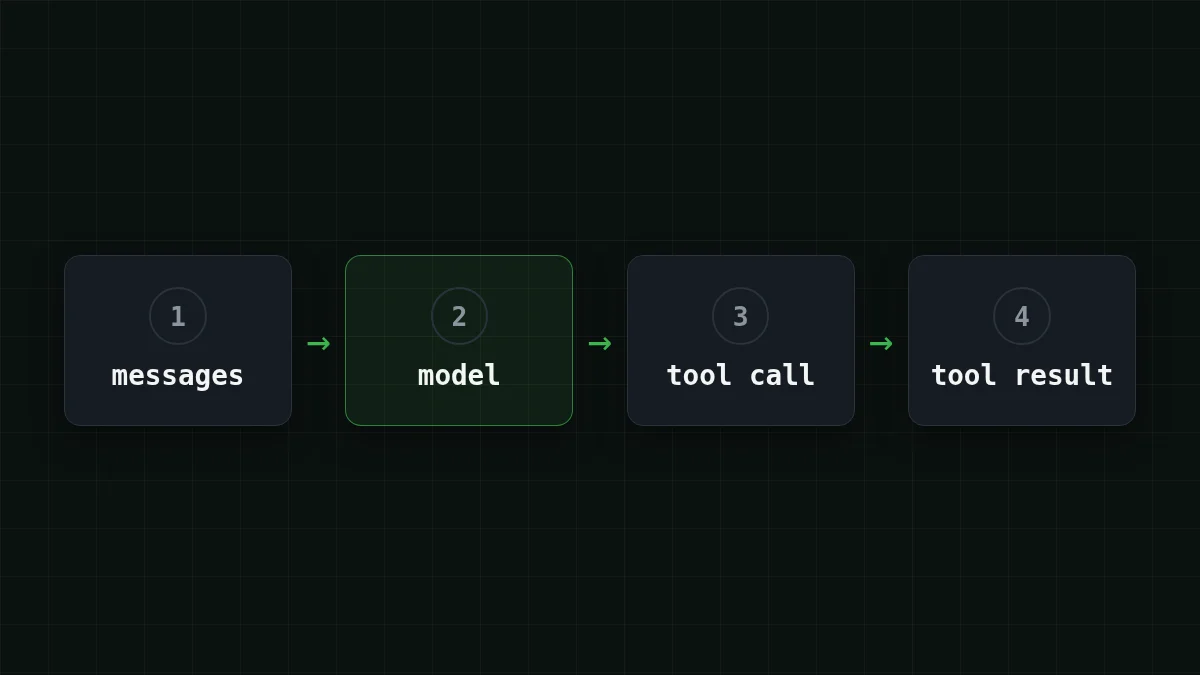
Döngünün bir turunu doğru sıraya koyabilir misiniz?
Sıraya koy
Ajan döngüsünün bir turunu sıraya koyun
Öğeleri sürükle veya okları kullan
- Görevi ve araç listesini modele gönderin
- Model metin yerine bir araç çağrısıyla yanıtlar
- Programınız o aracı kendisi çalıştırır
- Sonuç, mesajlara bir "tool" mesajı olarak girer
- Model, düz metin olarak yanıtlayana kadar sonuçla tekrar çağrılır
Anahtarsız çalıştırın#
Görev şöyle olsun: "todo.txt'te kaç öğe var?". Araç, disk yerine küçük bir sözlüğe bakan bir read_file fonksiyonudur. Ve gerçek bir model yerine, her zaman aynı iki şeyi yapan betiklenmiş bir model vardır: dosyayı iste, sonra yanıtla. Her hareketli parçayı görmek için bu yeterlidir. Bunu agent_loop.py olarak kaydedin (Python 3.10+, yalnızca standart kütüphane):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
python agent_ komutunu çalıştırın. Ortamınızda LLM_API_KEY yoksa betiklenmiş modeli alırsınız ve ekran tam olarak iki tur gösterir:
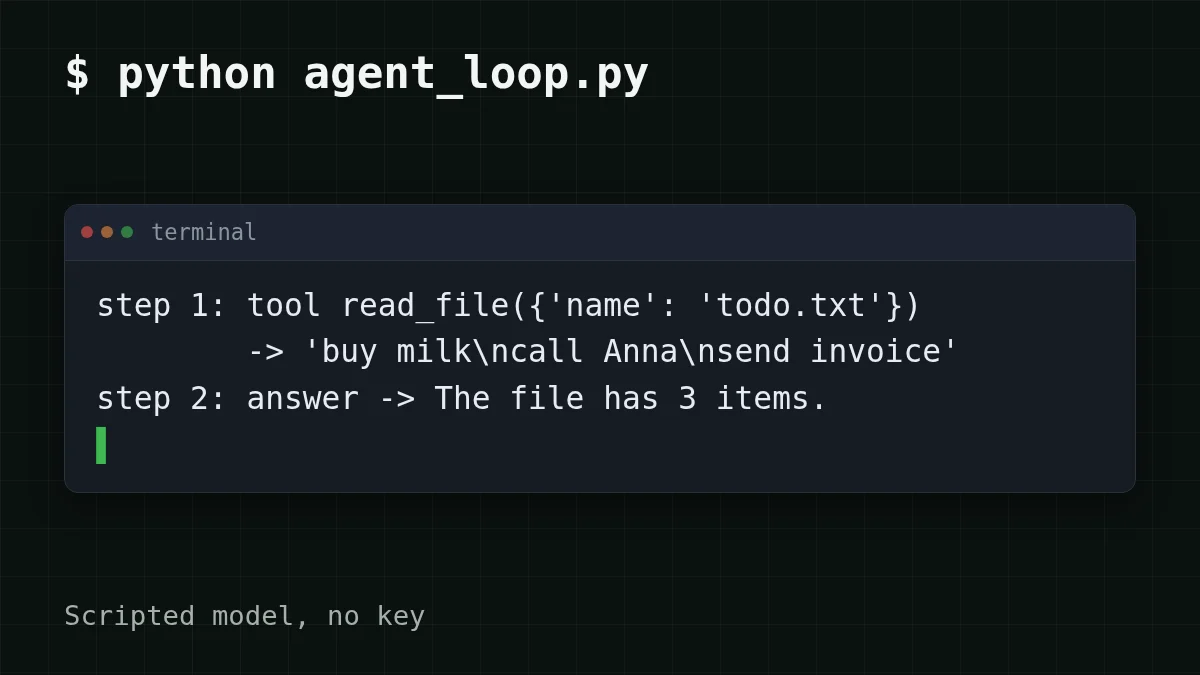
Üç satıra bakın, çünkü bütün fikri onlar taşır:
messages.modelin kendi turunu saklar. Bunu atlarsanız, bir sonraki çağrı, API'nin hiç görmediği bir isteği yanıtlayan bir araç sonucu içerir; çoğu API bunu 400 ile reddeder.append(reply) argumentsbir JSON dizesi olarak gelir, bu yüzden fonksiyonu çağırmadan öncejson.loadsüzerinden geçer.max_stepsacil frendir. Bir model sonsuza kadar araç isteyebilir, bu yüzden her gerçek ajanın böyle bir sınırı vardır.
Aynı döngüyü gerçek bir modele yönlendirin#
Sadece bir şey değişir: modeli kimin oynadığı. Betik üç ortam değişkeni okur ve bir anahtar varsa aynı messages'i OpenAI uyumlu bir uç noktaya gönderir. CheapTokens adresi https:/'dir (OpenAI Chat Completions ve Anthropic Messages uyumlu) ve model kimliği belgelerdeki tam kimlik olmalıdır: deepseek-.
Döngüyü üç şekilde çalıştırın
Anahtar yok
python agent_loop.pyBetiklenmiş model her iki turu oynar. Makinenizden hiçbir şey çıkmaz.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
380K bağlam penceresi ve yanıt başına 32.768'e kadar çıktı token'ı: uzun bir döngü için yer.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Çok adımlı bir döngünün ilk çalıştırması için 390K bağlam pencereli hafif bir model.
Görmeniz gereken şey öncekiyle aynı şekil: step 1: tool read_, sonra step 2: answer -, her model çağrısının altında bir usage: satırıyla. Yanıtın ifadesi betiklenmiş olandan farklı olacak ve konuşkan bir model fazladan bir tur atabilir. Bu normaldir: model karar verir, döngü sadece itaat eder. Anahtarı betiğin kendisinden uzak tutun; güvenli yer bir ortam değişkenidir (nasıl saklanacağı burada).
usage: satırları işe yarayan kısımdır. Daha uzun bir çalıştırmanın in sayılarını ekleyin ve paranın nereye gittiğini görürsünüz.
Her tur neden bir öncekinden daha pahalı#
Model çağrılar arasında hiçbir şey hatırlamaz. Her tur tüm messages listesini tekrar gönderir: görev, önceki her araç çağrısı, her araç sonucu. (Aynı kural uzun bir sohbeti pahalı yapar; çok turlu sohbet bunu düz bir konuşmada gösterir.)
1. tur bir mesaj gönderir. Döngü devam ederse, 6. tur on bir mesaj gönderir.
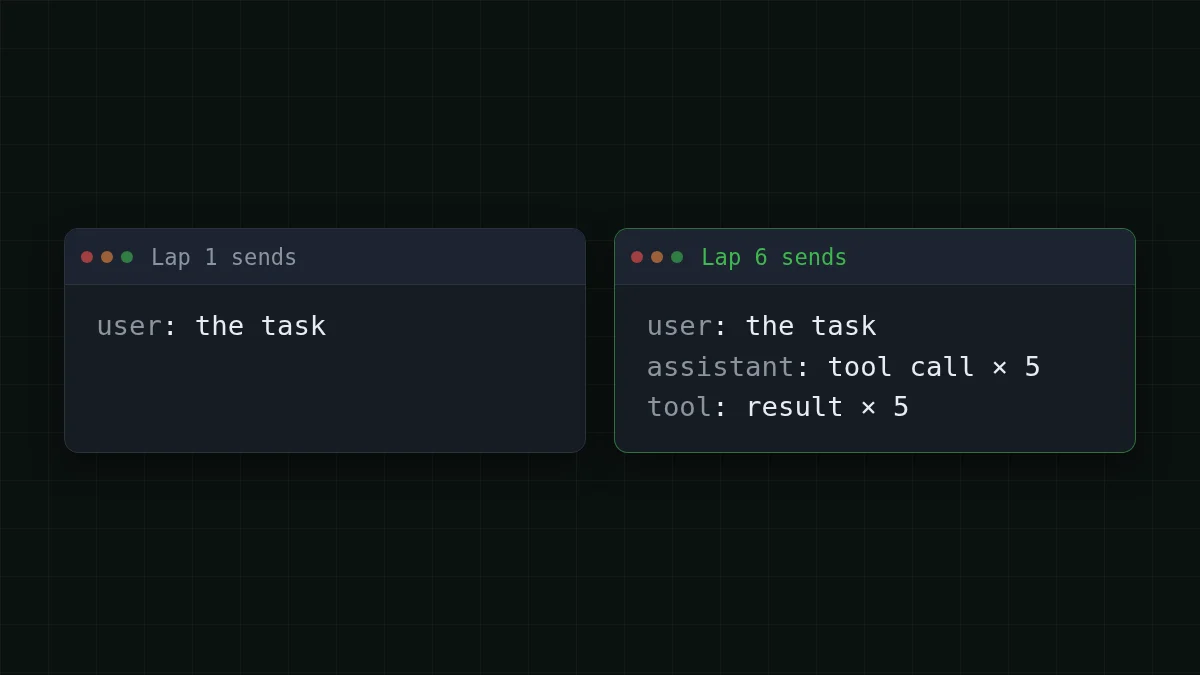
Diyelim ki gerçek bir görev 10 tur sürüyor. Yaklaşık 2.000 token ile başlar (talimatlar, araç listesi, isteğiniz), her tur yaklaşık 1.500 ekler (bir araç sonucu artı modelin notu) ve model tur başına yaklaşık 300 token yazar. 1. tur 2.000 gönderir, 2. tur 3.500, 10. tur 15.500. İlk kısmın toplamı 10 × 2.000 = 20.000 token'dır; büyüme 1.500 × 45 = 67.500 ekler (45, 0+1+…+9'dur), yani görev üzerindeki girdi 20.000 + 67.500 = 87.500 token'dır. Çıktı 10 × 300 = 3.000 token'dır.
Görev metni birkaç cümle, ama girdi tarafı 87.500 token. 1M girdi token'ı başına $0.015 ile, DeepSeek-V4-Flash'te tüm görev $0.0016 tutar. İşte aynı yük modeller arasında, referans olarak OpenRouter ile. Toplamda, girdi ve çıktı birlikte sayıldığında, CheapTokens bu yükte OpenRouter'dan daha ucuz çıkar:
| Model | Giriş $/1M | Çıkış $/1M | Maliyet | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
Toplamda 87.500 giriş ve 3.000 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Günün her saatinde tek fiyat da burada yardımcı olur: gece boyunca çalışan bir ajan öğlen çalışanla aynı maliyettedir ve tüm fiyatları fiyatlandırma sayfasında görebilirsiniz. Böyle görevlerden bir gün için kaydırıcıları hareket ettirin:
Maliyet hesaplayıcı
Bir gün: her biri 10 turluk 20 görev
İstek başına giriş token'ı: 8.750 · İstek başına çıkış token'ı: 300 · Günlük istek sayısı: 200
| Model | Günlük | Aylık |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Alanlar model çağrısı başınadır: 8.750, yukarıdaki örnekteki bir turun ortalama girdisidir (87.500 ÷ 10) ve 200 çağrı, 20 görev × 10 turdur. Ajan faturalarının soruyla değil geçmişle ilgili olmasının nedeni budur. 20 adımlı örnek aynı etkiye daha derinlemesine iner.
Hızlı kontrol
Bir ajan döngüsünün 3. turu, yeni bir şey sormadığınız halde 1. turdan daha pahalıdır. Neden?
Cevabı göster
Cevap: Mesajlar listesi artık iki araç çağrısı ve iki sonuç tutar ve hepsi tekrar gönderilir
API durumsuzdur. Her çağrı tam geçmişi taşır, bu yüzden girdi token'ları her turda büyürken çıktı yaklaşık aynı kalır.
40 satırdan nereye#
Yukarıdaki betik öğrenmek için bir taslaktır. Uzun sürümü istiyorsanız, GitHub'da açık bir kurs var, justxor/agent-harness-course (README Rusça, 31 Ekim 2026'da kontrol edildi). Bağımlılıksız düz Python 3.10+, kod MIT lisanslı, metin CC BY 4.0. Klonladıktan sonra python examples/ döngüyü betiklenmiş bir modelle çevrimdışı çalıştırır ve python - 19 testini ağ olmadan çalıştırır. Kurs bağlam sıkıştırma, bellek, alt ajanlar, riskli eylemlerin insan onayı ve maliyet takibi ile devam eder. Gerçek bir model için LLM_PROVIDER, LLM_MODEL, LLM_API_KEY ve OpenAI uyumlu uç noktalar için LLM_BASE_URL okur: README'sinden tam LLM_PROVIDER değerini alın.
Döngü çalıştığında, sonraki adım gerçek bir anahtar ve gerçek bir görevdir: belgelerde bir dakika içinde ilk istek var ve DeepSeek-V4-Flash döngüyü çalıştırmak için iyi bir modeldir.


